Stub 頁
本頁為待補充的 stub,先補上被其他頁面引用的核心定義與供應商輪廓,後續累積來源再擴充(演進節奏、各廠世代、與 CoWoS 產能連動等)。
定義
HBM(High Bandwidth Memory,高頻寬記憶體)本質是 3D 堆疊 DRAM:以 TSV(矽穿孔)將多顆 DRAM 晶粒垂直堆疊成一個記憶體立方體,再透過矽中介層(interposer)以 2.5D 方式(如 技術_CoWoS)與 GPU/AI 加速器並列整合,提供大容量、大頻寬的記憶體,是 AI 訓練與大型加速器的主流記憶體方案。
圖解
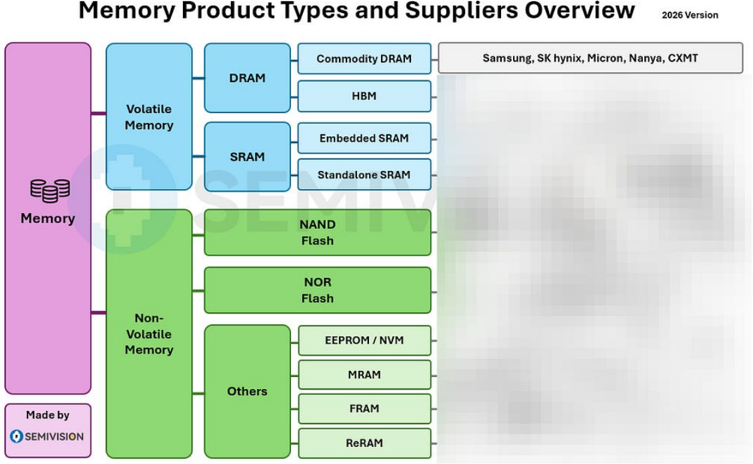
圖說:記憶體產品分類與供應商(2026 版)——揮發性記憶體分 DRAM(Commodity DRAM/HBM)與 SRAM(Embedded/Standalone);HBM 與 Commodity DRAM 供應商為 Samsung、SK hynix、Micron、Nanya(南亞科)、CXMT。
供應商
| 類別 | 主要供應商 |
|---|---|
| HBM | Samsung、SK hynix、Micron |
| Commodity DRAM | Samsung、SK hynix、Micron、Nanya(南亞科)、CXMT |
HBM4E 與客製 ASIC 拉貨
- HBM4E 為下一世代 HBM。Google TPU v10(Icefish)單顆採 16× HBM4E(N2P chiplet 設計),顯示客製 ASIC 對 HBM4E 的拉貨量大。
- 來源 產業_SemiAnalysis_BroadcomTPU_Pumafish取消_20260518;客製 ASIC 供應鏈結構見 供應鏈_GoogleTPU。
與 3D 堆疊 SRAM 的定位對照
| 面向 | HBM(3D 堆疊 DRAM) | 技術_3D堆疊SRAM |
|---|---|---|
| 堆疊內容 | DRAM | SRAM |
| 強項 | 大容量、大頻寬 | 低延遲、近運算、免刷新 |
| 主要工作負載 | AI 訓練、大型 GPU 加速器 | AI 推論、CPU 大快取、邊緣 |
| 整合方式 | 2.5D(CoWoS 等)並列 | 3D 垂直堆疊於邏輯晶粒 |
兩者互補而非取代:未來 AI 記憶體階層中,HBM 提供大外部頻寬,3D 堆疊 SRAM 作為高頻寬、低延遲的近運算中間層。
相關技術
- 技術_3D堆疊SRAM(低延遲近運算對照層)
- 技術_CoWoS(HBM 與運算晶片 2.5D 整合平台)
- 技術_TSV(HBM 垂直堆疊互連)
- 技術_SoIC(3D 混合鍵合)
HBM 製造流程與鍵合世代(AI 晶片封裝講座,2026-10-14)
- 流程:前段分別製作 DRAM 晶圓(TSV 製程)與底層邏輯控制晶片(Base/Logic Die);中後段為晶圓薄化+凸塊製作 → 晶粒切割 → 堆疊鍵合(Die-to-Wafer/Wafer-to-Wafer)→ 模塑封膠與切割 → 以 KGSD(Known Good Stacked Die)型態出貨。
- 鍵合世代:HBM2/2E 採 TC-NCF(熱壓非導電膜),接點間隙約 10~15µm、熱應力較高;HBM3/3E 導入 MR-MUF 與 Advanced MR-MUF,低應力、間隙約 13µm、導熱與散熱路徑較佳,支援 8Hi/12Hi;HBM4 展望為 16Hi,若採微凸塊則間隙被迫壓至 10µm、DRAM 晶圓需薄化至 40µm 以下,改採技術_混合鍵合可使間隙歸零並增加傳輸頻寬與通道數。(本節為講座筆記口徑,與下方「HBM4 規格下修」所記 8 層、11Gbps 以下的最新規格走向並存,量產路線以後者為準。)
- HBF:高頻寬快閃記憶體(SK Hynix、SanDisk、Kioxia、Samsung 研發),以 HBM 類架構垂直堆疊多層 3D NAND 與控制晶片,經中介層連接運算晶片,鎖定 Edge AI 推論;詳見 技術_NAND近記憶體化_KV Cache卸載與HBF。
HBM 市場展望(HSBC 2026-06-02)
來源:報告_HSBC_韓國AI供應鏈科技巡禮_20260602
- HBM 市場規模:HSBC 估 2027 年 HBM 市場規模達 US$163bn(estimate,高信心)
- HBM bit 需求 CAGR:2024–2027 年 CAGR 達 67%(estimate,高信心)
- Vera Rubin 平台 HBM 佔比:Rubin Ultra 進一步大幅提升 HBM 比例(Exhibit 13 圖表顯示顯著擴大)
- HBM3e 定價趨勢:HBM3e ASP 將上調,縮小與 commodity DRAM 的差距(估計)
- SO-CAMM2 佔 DRAM 比例:Vera Rubin 平台 SO-CAMM2 佔全球 DRAM 需求約 6–10%(estimate)
- Samsung vs SK Hynix HBM 競賽:HSBC 預期 Samsung 將縮小在 HBM4 與 commodity DRAM 上的技術差距(HSBC Buy Samsung)
- 台灣受惠:台灣廠商受惠主要來自 DRAM 測試(京元電)、FC-BGA 載板(欣興、南電等)、CoWoS 封裝(台積電)
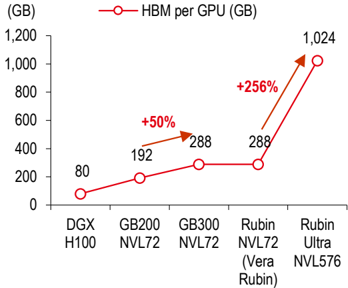
圖說:HSBC 估計 Rubin Ultra 平台 HBM 含量顯著高於前代(Rubin),反映 AI 加速器對高頻寬記憶體的需求大幅提升。
HBM Cannibalization 與供需模型(MS Chipflation 2026-06-02)
來源:報告_MorganStanley_記憶體Chipflation_20260602(投資論點見 分析_Chipflation記憶體危機_MS_20260602)
HBM 不只是「額外的 DRAM 需求」,而是透過吃掉 leading-edge wafer 與 LTA 鎖量,成為 AI 排擠傳統記憶體的核心機制。
- 三層非線性放大:HBM 含量在晶片層 7.2x(A100 40GB → Rubin 288GB/GPU)、系統層 ~65x(8-GPU A100 server 320GB → Rubin NVL72 機櫃 20.7TB)、叢集層 ~1,800x(2020 訓練叢集 ~10TB → 2026 frontier 叢集 ~18PB)。單一 2026 frontier 叢集的 HBM 量 > 2020 全球年產量。
- Bit-output penalty:HBM die 大、3D 堆疊/TSV/封裝/測試良率挑戰,使每單位 HBM 產出吃掉的 wafer 從 2021–24 的 ~3.0x 升到 2028e 的 ~4.3x 傳統 DRAM。
- Cannibalization:HBM 佔 leading-edge 記憶體 wafer 從 2023 的 ~6% 升到 2028e 的 ~34%(見下圖),壓縮 DDR/LPDDR/server DRAM 的可用先進產能。
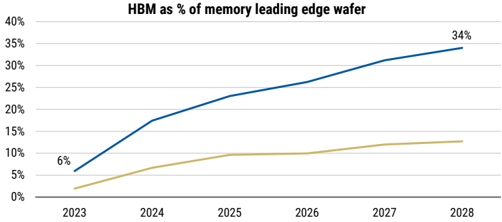
圖說(Exhibit 28):HBM 佔記憶體 leading-edge wafer 比例由 2023 ~6% 升至 2028e ~34%(藍線),即 HBM 對先進 DRAM 產能的排擠快速上升;黃線為較保守情境。
HBM TSV 產能(year-end, kwpm)與供需 sufficiency(MS 模型)
| 項目 | 2024 | 2025 | 2026e | 2027e |
|---|---|---|---|---|
| Samsung | 130 | 150 | 180 | 250 |
| SK hynix | 120 | 150 | 200 | 250 |
| Micron | 20 | 60 | 100 | 110 |
| 合計 TSV 產能 | 270 | 360 | 480 | 610 |
| DRAM 總體 sufficiency(含 HBM) | -5% | -4% | -17% | -15% |
- HBM 產能集中三雄,2026e ~480kwpm → 2027e ~610kwpm;但產能不等於可用 bit——還受良率、UTR、TSV、先進封裝、測試與客戶 qualification 限制。
- 中國:CXMT 目標 2027 HBM3e(1anm,無 EUV,比照 Micron 先例),但 bits/wafer 僅西方 ~1/3;XMC(武漢新芯)為 YMTC 產 HBM wafer,仍 R&D 規模。MS 的 HBM 模型完全不計入中國貢獻(Samsung/SK hynix/Micron only)。
HBM4E 封裝挑戰與客製 HBM(ECTC 2026,SemiAnalysis 2026-07-02)
來源:報告_SemiAnalysis_ECTC2026先進封裝_20260702
HBM4E 對中介層/載板的規格衝擊(Samsung 揭露)
- HBM4 pin 數為 HBM3 的 2 倍,HBM4E 資料速率推向 12 Gb/s 以上;中介層層數需求 HBM4E 為 HBM3E 的 2 倍、HBM2 的 5 倍
- 介面功耗:HBM4E 為 HBM3E 的 +86%、HBM2 的 5.6 倍
- Samsung 提出 8 層矽中介層方案(2 訊號/1 接地交錯 + UHC 超高密度電容平衡佈局),比估計需求少 20% 層數
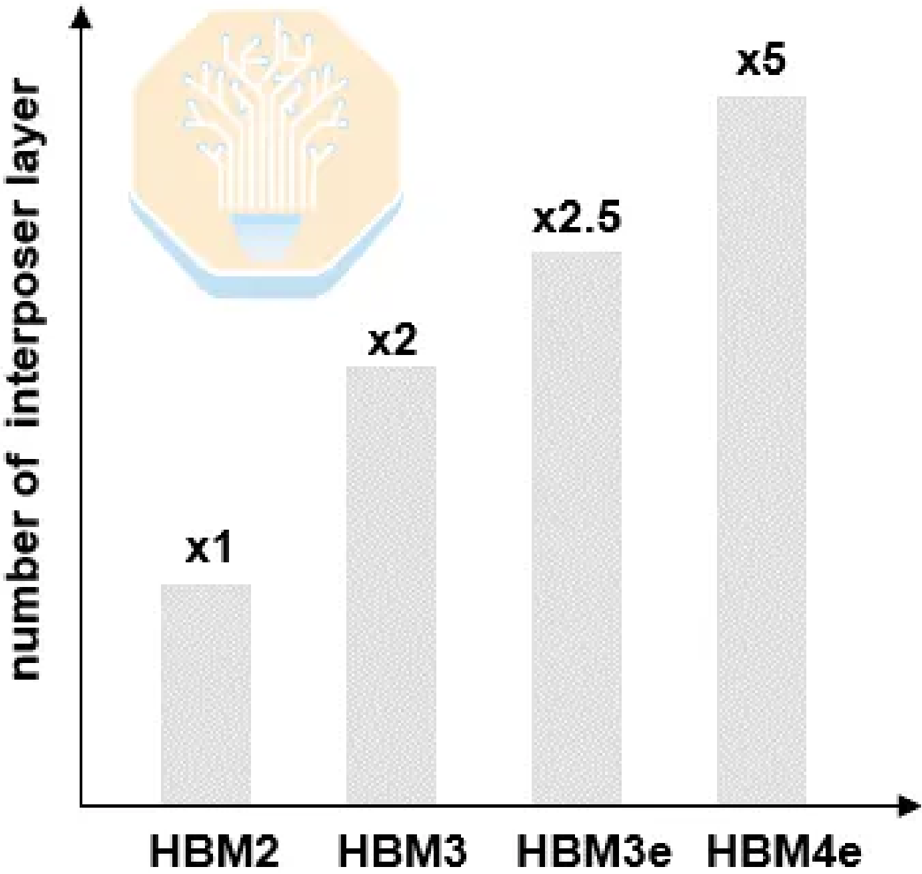
圖說:中介層層數需求柱狀圖——HBM2 x1、HBM3 x2、HBM3e x2.5、HBM4e x5。來源:Samsung, ECTC 2026 © SemiAnalysis
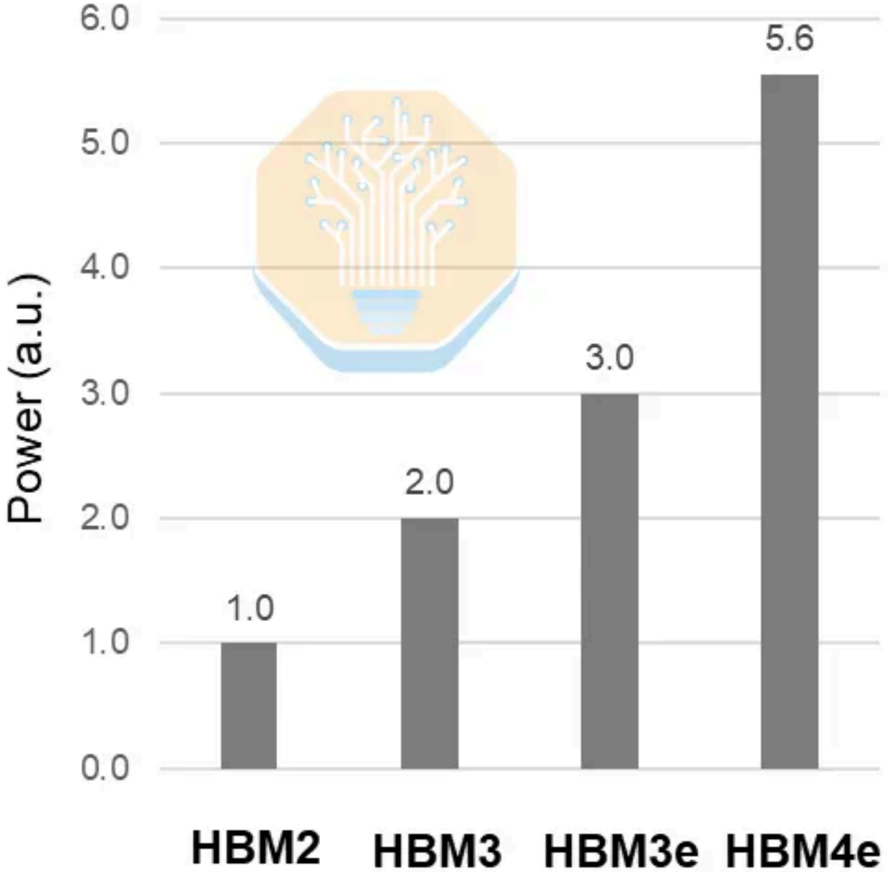
圖說:HBM 介面功耗柱狀圖——HBM2 1.0、HBM3 2.0、HBM3e 3.0、HBM4e 5.6(a.u.)。來源:Samsung, ECTC 2026 © SemiAnalysis
客製 HBM(cHBM):JEDEC 邊界的鬆動
Marvell 於 ECTC 2026 揭露客製 HBM4E 封裝細節(host PHY 面積 −60%、4.1TB/s、有機 RDL 中介層),NVIDIA 已宣布 Feynman 採用。此為獨立深度主題,完整架構、量化效益與投資判讀見 技術_客製HBM。
base die 製程自 HBM4 起轉邏輯製程(介面 1024-bit → 2048-bit,DRAM 製程做邏輯又大又慢):SK hynix 用台積電 12nm、Samsung 用自家 4nm、Micron 因成本考量 HBM4 仍沿用 DRAM 製程、計畫自 HBM4E 轉台積電邏輯製程(2026-07-09)。製程改變不等於客製化——設計仍屬記憶體廠、仍符合 JEDEC 者為 sHBM 標準品,cHBM 的分水嶺是客戶設計進入 base die。再下一步是 base die 位置被客戶運算晶片取代,見 技術_DRAM-on-Logic。
HBM 熱阻:TCB vs 混合鍵合(HCB)
- HBM 已成 2.5D 封裝熱瓶頸(Samsung:HBM 內部熱阻占比 57% vs ASIC 13%);16-hi 尚可接受,20-hi/24-hi 需新方案
- HCB(hybrid copper bonding)取代 TCB:stack 級熱阻 −19%(pad 密度 ×2 → −22.3%、×4 → −29.1%);系統級總熱阻改善較小(氣冷 −3.5%、液冷 −7.7%)
- base die 功耗放大(cHBM 趨勢)時 HCB 優勢擴大;Samsung 估 HCB 可讓進水溫 +1–2°C 或封裝功耗 +4%、冷卻功耗 −7%
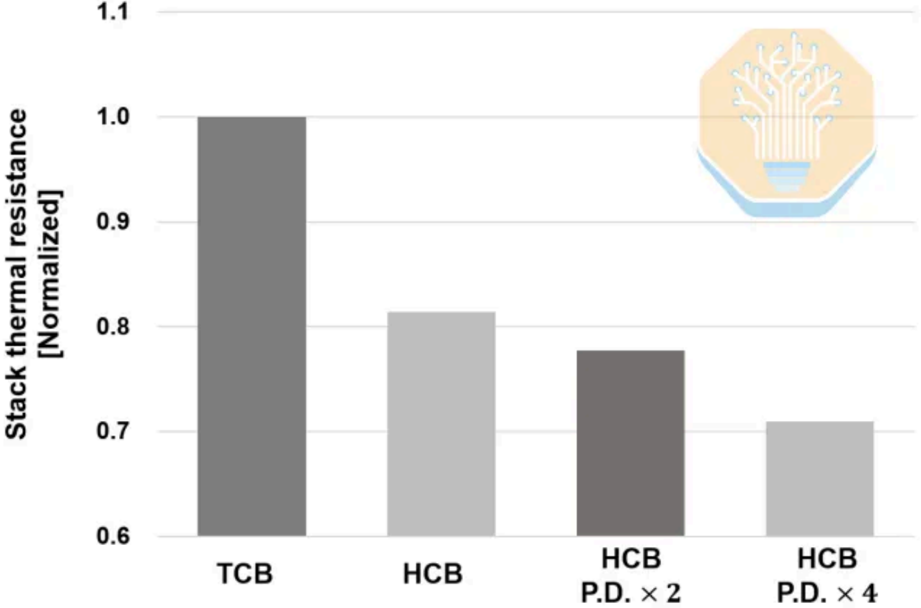
圖說:Stack 熱阻正規化柱狀圖——TCB 1.0、HCB 0.81、HCB pad 密度×2 0.78、×4 0.71。來源:Samsung, ECTC 2026 © SemiAnalysis
- OCP 2026 Marvell 口徑(廠商論述):混合鍵合降 D2D 熱阻 23–47%、堆疊高度縮 >15%;SK hynix iHBM 的矽 ICE 熱阻約 −30%;HBM 熱通量超過 JEDEC 約 1.7 W/mm²(報告_OCP2026_Marvell_客製HBM系統_20261015,2026-10)。與上方 Samsung −19% 為不同量測口徑(D2D 熱阻 vs stack 熱阻),並列不互蓋。
HBM5:兩個口徑的預測(OCP 2026,2026-10)
HBM5 目前無 JEDEC 定案資料,OCP 2026 有兩家 IP/ASIC 廠給出預測,皆為預測,並列:
| 項目 | Marvell(報告_OCP2026_Marvell_客製HBM系統_20261015) | 創意 GUC(報告_OCP2026_創意_AI運算記憶體連接擴展_20261015) |
|---|---|---|
| 速率 | 最高 28 Gbps(next-gen 約 HBM4E+30%,每堆疊 5.3–7.2 TB/s) | 24–32 Gbps |
| 時程 | 2028E+;熱問題約 2028 前後(8-hi→16-hi)逼近熱預算 | 2029 量產(較明確的一項) |
| 功耗與熱 | 約 100W/stack、>2.0 W/mm²(>28 Gbps),D2D PHY 最熱 | 32 Gbps 約 90W,D2D 為主熱源;HBM4E 約 60W |
| PHY | — | PHY 面積 14→8 mm²(−40%);HBM4E 16 Gbps PHY/controller 稱 2026「已就緒」 |
Samsung 在 OCP 2026 稱 zHBM(直接貼合 GPU、去除矽中介層與微凸塊)對 HBM5 頻寬 4–8x、能效 3x;LPDDR PIM 有效頻寬 8x、TPS 3x;另稱 HBM 頻寬 +17% 使 decode 快 12–15%(vLLM、DGX B200,Samsung 實驗室值)。zHBM 無年份與規格,屬廠商值(video_OCP2026_Samsung_高擴展記憶體_20261015,2026-10)。
HBM de-specing 與供需展望(UBS 2026-08-07)
來源:報告_UBS_記憶體月報_20260807(insight 見 分析_記憶體月度供需與價格追蹤_UBS_20260807)
- Rubin Ultra(VR300)規格下修但需求不減:UBS 產業查證顯示 NVIDIA 極可能先以 HBM4 8-Hi 供應 Rubin Ultra,再轉 HBM4E 8-Hi;先前預期為 HBM4E 12-Hi。研判為因應持續緊繃的供給。初版 VR300 單 GPU 含 HBM 容量將是 384GB HBM4(8-Hi×24Gb×8×2),之後轉 512GB HBM4E(8-Hi×32Gb×8×2),低於先前估計的 768GB(原 12-Hi 版本)。
- 規格下修不影響總需求上修:儘管單顆容量降低,UBS 將 2027E NVIDIA HBM 終端消耗量上修至 25.1bn Gb(原估 24.0bn),因 GPU 出貨量估上修至 12.6 百萬顆(原估 11.0 百萬顆);Google TPU 的 HBM 用量估亦上修至 2027 年 19.2bn Gb(原估 17.4bn)。全產業 HBM 終端消耗估上修至 2027 年 61.5bn Gb(原估 58.7bn),YoY +91%。
- HBM 定價:UBS 估 HBM4E 2027 年 ASP 約 US$3.9/Gb(較 2026 年 HBM4 +75% YoY);HBM4 2026 年 US$3.5/Gb(+60% YoY)。全產業 HBM 混合 ASP 2027 年 YoY +79%(原估 +66%)。連動下,DRAM 產業位元終端需求估 2027 年 YoY +40%(原估 +36%),2026 年 +21%。
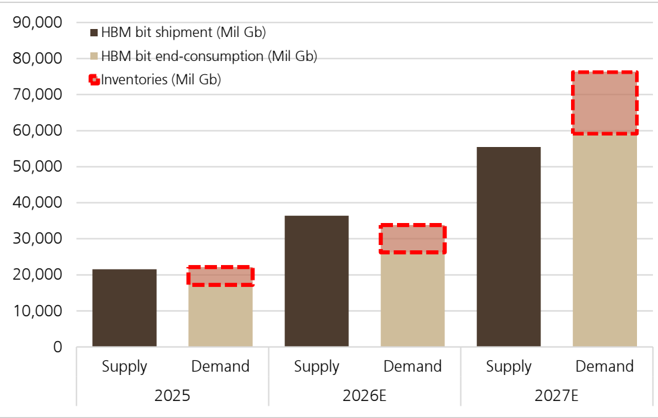
圖說(Figure 4):UBS HBM 位元供給(bit shipment)vs 需求(bit end-consumption)柱狀圖,分 2025/2026E/2027E;紅框標示需求柱上緣的庫存差額,可見需求持續高於出貨,供需仍緊。
HBM 供應商位元出貨與市占(UBS 模型,2026E/2027E)
| 廠商 | 2026E 位元出貨(M 1Gb) | 2026E 佔比 | 2027E 位元出貨(M 1Gb) | 2027E 佔比 |
|---|---|---|---|---|
| SK hynix | 17,237 | 47.3% | 21,295 | 38.4% |
| Samsung | 11,400 | 31.3% | 22,189 | 40.0% |
| Micron | 7,778 | 21.4% | 11,964 | 21.6% |
| 合計 | 36,415 | 100% | 55,447 | 100% |
UBS 模型顯示三星 HBM 位元佔比由 2026E 的 31.3%(落後 SK hynix 16 個百分點)快速拉近,估 2027E 反超 SK hynix(40.0% vs 38.4%),與「Samsung Key Call Buy」的評等邏輯呼應;SK hynix 雖仍全年出貨量最大但佔比明顯下滑。
Rubin Ultra 多 SKU 分層規格(MS 2026-08-10)
來源:報告_MS_AI供應鏈_20260810(Morgan Stanley,Charlie Chan 團隊,「AI Supply Chain: GPU Architecture Optimization Given Memory Shortage and Supernode Challenge」)
- MS 產業查證顯示 NVIDIA Rubin Ultra 將以多顆 SKU 同時並存因應:高階版採 HBM4e 8-Hi、低階版採 HBM4 12-Hi 或 8-Hi;NVIDIA 預計於 3Q26 底前做出最終決定。這與 UBS(2026-08-07,見上節)「單一規格沿時間演進(先 HBM4 8-Hi → 再轉 HBM4e 8-Hi)」的描述角度不同——MS 強調的是同代內依 SKU/工作負載分層,UBS 強調的是規格隨時間下修;兩者不必然矛盾(可能是「先以下修規格起量、同時依 SKU 分層」),但表述框架不同,暫並列觀察,待更多來源交叉確認。
- MS 判斷規格下修反映三個因素:① HBM 產能短缺、② 成本壓力、③ 依工作負載記憶體容量需求做最佳化。並指出 HBM de-specification 對 decoding(解碼)工作負載的影響大於 pre-fill(預填),尤其是長上下文窗口的 LLM。
- 降低單顆 HBM 含量可能提高晶片總出貨量,對以量計價的供應商(測試、封裝、載板等)反而有利;MS 不排除主要 ASIC 專案基於同樣邏輯採用不同 HBM 配置。
HBM 前段晶圓處理(PWF):力積電承接美光(2026 Q1 法說)
HBM 堆疊前的晶圓處理(PWF, pre-stack wafer fab/wafer processing)是 HBM 製造的上游環節之一。力積電 在 2026 Q1 法說揭露其 3D AI Foundry 承接 美光(Micron)HBM 堆疊前晶圓處理,採「成本加成」包賺模式:
- 美光預付 3 億美元購置設備,進駐力積電 P1/P2 廠;先建 Mini line 試產,目標 2027 Q2–Q3 量產。
- 對力積電屬低風險(成本加成)切入 HBM 供應鏈的方式,而非自製 HBM 顆粒。
- 力積電另以 WoW(Wafer-on-Wafer)Hybrid Bonding 將 4/8 層 DRAM 堆疊於邏輯晶片(鎖定低功耗穿戴);公司表示 HBM 現行 micro-bumping 遇瓶頸後可能轉向此類晶圓堆疊技術。
HBM4 規格下修與 CXMT 進場(Cantor 專家會/MS,2026-08-26~27)
HBM4 降規(Cantor 專家電話會,富邦轉述,2026-08-27) - HBM4 原規劃 12 層、16 層堆疊,因良率與速度損失問題,規格大幅下修至 8 層、11Gbps 以下;NVIDIA 與記憶體廠在價格與效能間持續拉鋸。 - 2026 年 HBM3E 因 Rubin 平台延遲仍占 HBM 出貨約 8 成;一般 DRAM 價格因 HBM 排擠效應走升,惟 HBM 本身因長約議價,獲利反而不如預期。 - 記憶體(HBM、eSSD、LPDDR5X)合計已占 AI 伺服器半導體內容值約 3 成,而 AI 伺服器半導體成本占整機約 95%——記憶體成本高企對雲端業者 TCO 形成明顯壓力,這是 NVIDIA 力推 HBM4 降規以控成本的核心背景。 - 長文本 LLM 帶動 prefill/decode 分離架構:prefill 偏採 GDDR7 或 LPDDR 系列,decode 高度仰賴 HBM 存放推論中介資料,以降低整體記憶體成本。 - Hybrid Copper Bonding(HCB)被視為晶圓級接合新方向,可望先用於邏輯製程單層晶粒接合,多層堆疊的 HBM 導入時程更晚,短期仍以傳統 TSV 堆疊為主流。
CXMT 進入 HBM(MS,2026-08-26) - MS 檢查認為 長鑫存儲CXMT(未) 可用 wafer-on-wafer 做出 12-Hi 堆疊(單顆 24GB),2027 年可產 3-4mn 顆 HBM3E stack(即使良率偏低),足以支撐中國 AI GPU 出貨約 0.8-1.0mn 顆。路線為 HBM2E(2026)→ HBM3E 12-Hi(2027)→ HBM4(2028),HBM TSV 產能 20kwpm(2026e)→ 40k(2027e)→ 70k(2028e),占全球 HBM 位元出貨 3.8%/4.4%(2026e/2027e)。 - HBM 的晶圓消耗懲罰持續加重:MS 估 HBM 每單位位元產出消耗的晶圓量由 2021-23 年的約 2.5 倍升至 2028e 的約 3.0 倍;HBM 占先進製程 DRAM 晶圓消耗比重由 2023 年約 6% 升至 2028e 約 34%。 - 即便納入 CXMT 產能,MS 仍估 全球 HBM+DRAM 供給不足 17%(2026e)/15%(2027e);三大廠 HBM 年底產能由 2026e 約 500kwpm 增至 2027e 約 600kwpm。 - 現行出口管制禁止獨立 HBM stack 輸中,但內含 HBM 的處理器與加速器在符合效能門檻下仍可出貨——這是中國必須自建 HBM3E 供給的直接原因。
與庫內既有 HBM4 敘事的關係
報告_MS_AI供應鏈_20260810(2026-08-10)記 Rubin Ultra 以多 SKU 分層因應 HBM 短缺(高階 HBM4e 8-Hi、低階 HBM4 12-Hi 或 8-Hi,3Q26 底定案)。Cantor 專家會(08-27)的「HBM4 整體降規至 8 層、11Gbps 以下」是同一趨勢的更強版本,且點明成本壓力來自雲端業者 TCO。兩者方向一致,本節為最新狀態。
GFHK 轉多 DRAM:HBM4 定價、de-spec 幅度與 NVHBM 價值移轉(2026-09-06)
廣發香港(GF Securities HK,Jeff Pu)在 7/3、8/6 兩份看空記憶體報告後(期間記憶體股表現落後),因供應鏈參訪與 SEMICON 2026 見聞而轉為看多 DRAM;該行已於 8/12 停止覆蓋記憶體個股,本篇為產業觀點。
DRAM 價格與庫存穩健 - TrendForce 於 9/1 上調 3Q26 PC DRAM 價格預期(自季增 15–20% 上修至 18–23%),伺服器與行動維持不變。 - GFHK 供應鏈研究顯示美系 hyperscaler 庫存偏低,且隨 CPU 供給改善,3Q26 底前可能再降。 - 據此估 4Q26 綜合 DRAM 價格季增約 10%(3Q26 為高十位數季增)。
NAND 相對疲弱 - 維持 3Q26 NAND 價格高十位數季增,但 4Q26 轉為低個位數季增,壓力來自行動需求偏弱與行動/PC 庫存偏高。 - Hyperscaler NAND 庫存約 14 週(正常約 15 週)仍屬健康,但價格展望轉弱可能拖慢提前拉貨。
HBM 穩健,de-spec 幅度小於預期 - 2027 年 HBM 觀點維持建設性:供給仍緊、中國 GPU 需求加持、DRAM 與 HBM 價差擴大。 - HBM4 定價要到 4Q26 初才會定案;目前三家供應商開價 US$2.9–4.5/Gb,GFHK 預期最終落在 US$3.5–4.0/Gb,對照 NVIDIA 2026 年的 US$1.8–1.9/Gb。 - 規格面維持 8-Hi 為主流的看法,涵蓋 NVIDIA CPX、TPU Humufish/Triggerfish/Whalefish 與客製 MI450;4-Hi GPU 版本機率低;Rubin Ultra 目前仍同時以 8-Hi(HBM4、4E)與 12-Hi/384GB 兩路開發。SOCAMM 的 de-spec 仍在,1Q27 前趨向 64GB。
SEMICON 2026:cHBM、zHBM 與 NVHBM - Samsung 正在把 cHBM4E 制式化,鎖定 workload-specific 應用,目標 HBM4E 每 GPU(4 顆堆疊)達 16 TB/s,並預期 HBM5 效能再翻倍。 - zHBM 走出 2.5D,改以 WoW(wafer-on-wafer)與混合銅接合追求進一步增益。 - 2454_聯發科(市) 宣布與 NVIDIA 合作 NVHBM。GFHK 判斷 NVHBM 架構(更高頻寬、更大 die 面積、更低功耗)是為未來 ASIC 採用鋪路,可能自 NVIDIA Feynman 世代開始。 - 結構性影響:NVHBM 把 base die 的設計價值從 HBM 供應商移轉到 NVIDIA 與聯發科手上——這是本報告最值得追蹤的一條,牽動的是記憶體廠在 HBM 價值鏈中的分潤位置,而不只是價格。
風險:AI 需求放緩、基礎建設部署、供給限制、競爭。
HBM4 定價與供需(同券商 2026-11-05 更新,取代上述 9/6 區間為最新口徑;來源 報告_廣發香港_記憶體產業_20261105): - HBM4 2027 年最終價預估分廠:Samsung 約 US$5.0–5.5/Gb(11.7Gbps 速度最穩,核心與 base die 皆採先進製程,要價最高)、Micron 約 US$4.5–5.0/Gb(談判策略較積極、客戶分散)、SK hynix 約 US$3.3–3.5/Gb(約低同業 30%,12nm base die 高速表現不足、重新設計與換料造成良率問題約 9 月底解決,為保主力客戶市占而讓價);皆遠高於 2026 年的約 US$2.6/Gb(廣發口徑,與上方 9/6 引用之 NVIDIA 2026 年 US$1.8–1.9/Gb 基準不同,待核對)。 - 規格:Rubin Ultra 的 HBM de-spec 已穩定在 8-Hi(如 HBM4E 8-Hi 256GB),市場已消化;下一世代仍有 12-Hi 可能;中國 GPU 需求強勁使供給更緊。 - 需求/供給:HBM 需求 4,746/7,944/10,299M GB(2026/27/28,占 DRAM 需求 10%/13%/13%);三大廠 HBM TSV 產能 4Q26/27/28 為 480/670/950K wpm(占 DRAM 總產能 22%/27%/32%),HBM 位元出貨 4,037/6,430/9,773M GB,供需缺口 -15%/-19%/-5%,為記憶體中最緊的品類;CXMT TSV 估 20/40/60K,僅能滿足中國需求一小部分。 - ⚠️ 與 9/6 版(開價 US$2.9–4.5、預期 US$3.5–4.0/Gb)相比,11/5 版預期明顯上修,且分廠差異拉大。
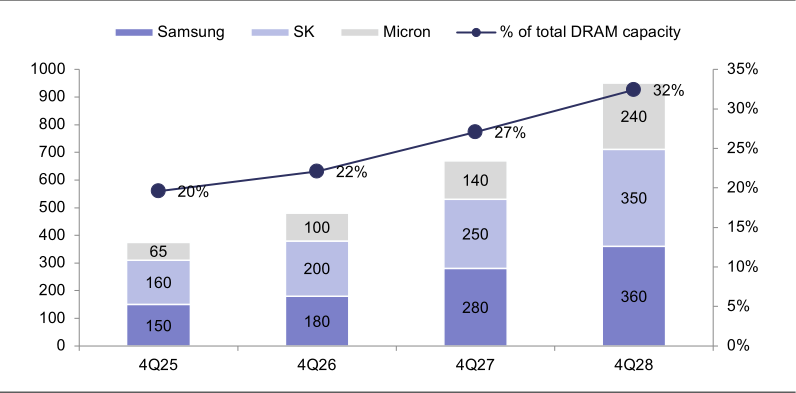
圖說:三大 HBM 廠 TSV 月產能堆疊長條(KWPM),Samsung 150/180/280/360、SK 160/200/250/350、Micron 65/100/140/240(4Q25/26/27/28),折線為占 DRAM 總產能 20%/22%/27%/32%(廣發香港,2026-11-05)。
HBM 供需模型上修與客製化路徑(JPM 2026-09-22)
S-D 缺口略收斂,但 TAM 大幅上修 - JPM 延續 CoWoS 模型更新後的 HBM 產業模型:三年累計 HBM bit 需求大致不變(163bn Gb),但 HBM S-D glut ratio 由 2026E 的 -20% 逐步收斂至 2028E 的 -16%(前估為 -15%/-14%/-22%,2028E 反而轉差,反映 8-Hi 組合占比提高、16-Hi 遞延至 2029E 最早)。 - 因累計缺口惡化(超過 4 個月的採購缺口),JPM 上修定價與 HBM TAM:2027E/2028E HBM 產業營收上修至 US$160bn/US$282bn(+10%/+12%),占三大原廠合計 DRAM 營收比重達 18-24%。 - HBM bit 需求 2026E-28E CAGR 達 63%,僅次於 AI 伺服器級 DRAM/SOCAMM 的 92%,高於非 HBM 伺服器 DRAM(+37%)與 PC/Mobile(-3%);HBM 占 DRAM 產能比重估由 2025 年 19% 升至 2028E 的 31%。
ASIC 於 2027 年起取代 NVDA 成為最大 HBM 消耗者 - 2026E NVDA 仍占 HBM bit 需求 58%(respective HBM-grade chip 內部占比),但 2027E 起 ASIC(48%)反超 NVDA(43%),主因 ASIC 系統出貨量年增 102%(NVDA 僅 +15%);NVDA 每系統 HBM 含量溢價將由 2026E 的 1.44x 收斂至 2027E/28E 的 1.33x/1.25x。
HBM 定價與獲利結構 - JPM 模型植入 54%/25% 混合 HBM ASP 漲幅至由上而下產業模型;HBM OPM 估落在中 60% 至低 70%,低於 LTA 保障之伺服器 DRAM(>80%),但較前一年明顯改善;非 LTA 部分 HBM 訂價可望續漲至 2028E。 - 16-Hi 因多重技術驗證與成本問題遞延至 2029E 最早上市,TCB(熱壓接合)在可見未來仍為 HBM 封裝主流方案(優於 HCB)。
客製 HBM:NVHBM 與前沿 AI 模型實驗室需求 - 首個官方客製 HBM 專案為 NVIDIA 主導的 NVHBM,預計 2028 年底發布、2029E 量產,base die 可能採用台積電 3nm 邏輯製程(不同於多元化的 HBM4 邏輯 die 供應鏈);記憶體廠負責最終驗證與相容性測試。 - Anthropic、OpenAI 等前沿 AI 模型實驗室探索自研客製晶片(自建資料中心租賃模式之外),若確認自研晶片將採 HBM4/4E(密度估 144-288GB,視 8-Hi 或 12-Hi 與 cube 數配置),為現行需求模型未反映的長期上行風險。
評等與市場表現 - JPM 重申看多記憶體:SK hynix(OW)> Samsung Electronics(OW)在股東回饋題材上更具吸引力,但三星在條件成熟下(提高股東回饋池、加碼買回/股利)評價可望改善。 - 記憶體三雄股價於 6-7 月大跌後(-36% vs SOX -19%)已反彈 39%(至 9/21,vs SOX +19%),HBM de-spec 疑慮已部分反映在股價。 - SEC + MU 合計 HBM value share 估由現行約 54% 升至明年 59%,逐步逼近整體 DRAM 市占結構;SKH 仍為現行 value share 領先者。
WSTS 月追蹤補充:產能分配與價格假設(JPM 2026-10-12,報告_JPM_亞洲半導體月營收追蹤_20261012) - 重申 2027E ASIC(48%)超越 NVIDIA(43%)成為最大 HBM bit 需求方;ASIC 系統出貨 +102% YoY vs NVIDIA +15%。 - HBM 晶圓占 DRAM 總產能比重 2028E 年底 31%;2025 年底至 2028 年底 DRAM 新增產能 930k WSPM 中 58% 配置於 HBM 等級前段晶圓。 - 價格假設:HBM ASP 2027E/28E +54%/+25%(2027E 前估 +43%,上修因供需較預期更緊);DRAM ASP +29%/+7%;NAND ASP 2027E +23%、2028E -4%(eSSD 與消費級 SSD 走勢分歧)。 - 8 月 WSTS 實績:記憶體營收 YoY +412%(7 月 +435%)、ASP +210%、出貨量 +65%(7 月 +80%),價格主導成長;JPM 預期缺貨程度 2027E 惡化、2028E 略改善。
圖說:全球記憶體廠與 SOX 指數股價表現長條圖(1M/3M/YTD/1Yr),SEC/SK hynix/Micron/南亞科(NYT)/Kioxia/SanDisk(SNDK)/SOX;SanDisk 1Yr 漲幅 1617% 居冠,記憶體類股整體遠優於 SOX(1Yr +96%)。
Micron F4Q26 法說:SCA 長約覆蓋與 2027 供給承諾(公司口徑,2026-10-01)
來源:報告_富邦_美光MU_FQ4法說memo_20261001(富邦證券法人業務處轉述,非研究報告)
美光公司法說口徑與上方產業模型(JPM/GFHK/MS)方向一致、提供更細的長約結構:
- SCA 覆蓋:美光共簽署 26 份 Strategic Capacity Agreement(SCA),預估涵蓋至 2030 年逾 35% 營收,客戶財務承諾達 US$32bn(多為現金存款),部分延伸至 2031 年;2027 年超過 75% 總產出已獲客戶承諾(SCA+非 SCA),多數客戶討論已轉向 2028 年供應。
- 供需看不到平衡點:Clean Room 建置時間長、先進製程 Bit Growth 效益下降、HBM Trade Ratio 提高,公司自承目前仍看不到供需恢復平衡的時間點;FY2027 新增 CapEx 主要投入 Clean Room 建設(Construction CapEx)而非立即裝機,短期不會直接轉化為大量 Bit Supply。
- NVHBM 時程交叉參照:公司表示 HBM4E 與 NVIDIA 共同開發已逾一年,應用於下一代 GPU 與 NVLink Fusion 平台;與 報告_JPM_HBM市場_20260922(2026-09-22)估計的 NVHBM 2028 底發布/2029E 量產時程方向一致,屬同一客製化趨勢的公司端確認。
- 券商 HBM 量價模型(2026-10-01):凱基估 Micron HBM 投片由 2026 年底 100kwpm 增至 2027 年底 140kwpm,2027 年 HBM 位元出貨 +74% 至約 106.9 億 Gb;HBM3e/HBM4 均價 2026 年約 US$1.5/2.2 per Gb → 2027 年約 US$3.0/4.16,HBM4e 較 HBM4 溢價約 20%,HBM 營收 CY2026/2027 約 US$11.5bn/45.4bn(報告_凱基_美光MU_20261001)。與上方 GFHK(HBM4 US$3.5–4.0/Gb)為不同口徑,並列觀察。兆豐補充:HBM4 放量速度為 HBM3E 12Hi 的兩倍、HBM4E 於 CY27 放量,客製化 NVHBM 導入 Rubin Ultra 與 NVLink Fusion(報告_兆豐_美光MU_20261001);中信、玉山、群益確認 2027 年 HBM 產能已簽約售罄、HBM 營收增速高於公司平均
Samsung 3Q26 法說:HBM4 放量與 2027 售罄(公司口徑,2026-10-29)
來源:活動_Samsung_3Q26法說memo_20261029
- HBM4 放量:3Q26 HBM4 銷售 QoQ 逾 3 倍、占 HBM 銷售 60%;HBM 市占已對齊 DRAM 整體市占(原訂 2H26,提早達成)。
- HBM4E 時程:5 月全球首家出貨 HBM4E 樣品;2027 上半年開始量產、下半年放大量。晶圓代工部門以 4 奈米與記憶體共同開發 HBM4 base die,稱達業界領先 HBM4 效能與 base die 良率(量產初期)。
- 2027 供給:HBM 供給量已以反映產品競爭力的目標價格全數售罄,主要客戶仍要求追加供給;供給吃緊預期延續至 2028(HBM4E、HBM5 晶粒更大、金屬層數大增,位元產出由一般 DRAM 轉向 HBM 形成物理限制)。
- 多年期合約:已與 10 家主要客戶簽多年期供貨合約、另 10 家洽談,目標占中長期產能 60–70%;與 Micron 的 SCA 長約(上節)方向一致,皆為公司口徑。
HBM 降規與測試端觀察(FormFactor/Teradyne 3Q26 法說,2026-10-28)
來源:活動_FormFactor_3Q26法說memo_20261028、活動_Teradyne_3Q26法說memo_20261028
- FormFactor(探針卡):HBM 降規(12 層改 8 層等)未見重大衝擊,3Q26 HBM 探針卡營收下滑為客戶投片組合轉向 DDR5;HBM4E、HBM5 設計案與客戶預測支撐持續成長,最終堆疊測試與高速測試為差異化點。
- Teradyne(ATE):記憶體供給限制使 AI 加速器轉向較低 HBM 堆疊高度(同樣 DRAM 晶圓可產出兩倍的 4 層堆疊 vs 8 層),預期擴大 HBM 效能測試 TAM,公司該市占高於 DRAM 晶圓分選;客戶對降規與測試影響的回饋有限。
- 兩家測試端說法一致:降規對測試需求偏中性至正面,與上節 UBS 的「降規不影響總需求」互相印證。
HBM 堆疊高度、薄化極限與 Hybrid Bonding 效益(國泰證期講座,2026-10-29)
來源:memo_國泰證期_先進封裝HBM矽光子技術解析_20261029(講座 Memo,講者口述,數字為講者口徑)
- Logic Die:HBM 取代部分 L3 快取角色;底層 Logic Die 彙整 DRAM 資料、經 PHY 與 GPU 溝通並負責自我測試,電路日趨複雜、需以先進製程製作。講者提及三星新世代 HBM Logic Die 可能委由台積電代工,未來晶圓代工、記憶體廠與 AI 晶片廠合作更緊密。
- 供應與認證:HBM3E 由 SK hynix 領先;HBM4 三星、美光、SK hynix 皆已通過 NVIDIA 認證,市占預計今年底較明確(講者)。
- 高度限制與薄化:TSV 先做導電通道、再以晶圓薄化露出。HBM 高度需與 GPU(約 775 µm,與 12 吋晶圓厚度相當)一致以利散熱;HBM3E 以前限 720 µm,12-Hi 共 13 層晶粒、單層約 40 µm,已近薄化極限;HBM4 16-Hi 共 17 層、單層需約 35 µm,JEDEC 將高度放寬至 775 µm。薄化、對準與多層堆疊 know-how 目前由三星、美光、SK hynix 掌握。
- Hybrid Bonding 效益(16 層計,講者):無凸塊使堆疊厚度由 755 µm 降至 595 µm(約 −20%);電極間距由 20 µm 縮至 10 µm,通道密度由 2,500 增至 10,000/mm²(約 4 倍)。講者認為 HBM4 16 層堆疊時 Hybrid Bonding 將成關鍵,更高層數亦有機會;見 技術_混合鍵合。
- 台廠定位:講者稱台廠以較成熟技術與較少堆疊層數發展客製化 AI 記憶體,鎖定高頻寬中容量的 Edge AI 應用。
與本頁其他口徑並列
① Samsung Logic Die:本講座稱「可能委由台積電」,而上方 Samsung 3Q26 法說(公司口徑)為晶圓代工部門以 4 奈米與記憶體共同開發 HBM4 base die;以公司口徑為準,講座說法待核對。② 16-Hi:本節為技術規格路線(JEDEC 高度放寬、Hybrid Bonding 動機),上方 Cantor/UBS/JPM 記 HBM4 降至 8 層、16-Hi 遞延至 2029E 最早、TCB 仍為主流,屬量產時程判斷,兩者並存、不互蓋。
來源
-
memo_國泰證期_先進封裝HBM矽光子技術解析_20261029 — 國泰證期研究部講座 Memo,2026-10-29;HBM 高度 775 µm 限制與 12-Hi/16-Hi 單層厚度、Hybrid Bonding 厚度 −20%/通道密度約 4 倍、HBM4 三家通過 NVIDIA 認證、Logic Die 委外說法
-
活動_AI晶片封裝講座_珩石筆記_20261014 — 珩石 kevin 講座筆記,2026-10-14;HBM 製造流程、TC-NCF/MR-MUF/混合鍵合世代、HBF(講者未載明)
- 分析_記憶體超級週期_AI推論與排擠效應_凱基專題_20261001 — 凱基(珩石筆記),2026-10-01;HBM 占 DRAM 投片 2026 年 19% → 2027 年 24%、HBM 需求 1.28 億顆 → 1.96 億顆(+53%)、40-50% HBM 採 8-Hi,降規視為供給瓶頸而非需求轉弱
- 活動_Samsung_3Q26法說memo_20261029 — Samsung 3Q26 法說,2026-10-29;HBM4 占 HBM 銷售 60%、HBM4E 2027 上半年量產、2027 供給售罄、多年期合約 10 家
- 活動_FormFactor_3Q26法說memo_20261028、活動_Teradyne_3Q26法說memo_20261028 — 2026-10-28;HBM 降規與較低堆疊高度對測試需求的看法
- 報告_富邦_美光MU_FQ4法說memo_20261001 — 富邦證券法人業務處(非研究報告),2026-10-01;Micron F4Q26 法說 memo:SCA 26 份長約、2027 逾 75% 產出已承諾、NVHBM 與 NVIDIA 開發逾一年
- 報告_凱基_美光MU_20261001 — 凱基投顧,2026-10-01;Micron HBM 投片、位元出貨與均價模型、HBM 營收預估
- 報告_JPM_HBM市場_20260922 — J.P. Morgan(Jay Kwon/Sangsik Lee),2026-09-22;HBM S-D 模型更新、TAM 上修至 US$282bn(2028E)、ASIC 2027 起取代 NVDA、NVHBM 時程、16-Hi 遞延至 2029E
- 報告_JPM_亞洲半導體月營收追蹤_20261012 — J.P. Morgan,2026-10-12;8 月 WSTS 記憶體營收 +412% YoY;HBM ASP 2027E 假設上修 43%→54%、HBM 占 DRAM 產能 2028E 31%、ASIC 反超 NVIDIA(2027E 48% vs 43%)
- 報告_廣發香港_記憶體產業_20261105 — GF Securities (HK),2026-11-05;HBM4 2027 定價分廠(Samsung 5.0–5.5/Micron 4.5–5.0/SK hynix 3.3–3.5 US$/Gb)、HBM 供需缺口 -15%/-19%/-5%、TSV 產能
-
報告_GFHK_記憶體DRAM_20260906 — GF Securities (HK),2026-09-06;轉多 DRAM、4Q26 DRAM 價格季增約 10%、HBM4 定價 US$3.5–4.0/Gb(三家開價 2.9–4.5)、8-Hi 為主流、NVHBM 把 base die 價值移轉向 NVIDIA/聯發科
-
報告_MS_CXMT_20260826 — Morgan Stanley,2026-08-26;CXMT HBM3E 12-Hi 2027 量產 3-4mn stack、HBM 晶圓懲罰 2.5x→3.0x、HBM 占先進製程晶圓 6%→34%、全球供給不足 17%/15%
-
報告_富邦_Cantor_AI儲存與HBM專家電話會_20260827 — 富邦證券法人業務處轉述 Cantor 專家電話會,2026-08-27;HBM4 降規至 8 層/11Gbps 以下、HBM3E 仍占 8 成出貨、記憶體占 AI 伺服器內容值 3 成、prefill/decode 分離架構
-
活動_力積電法說_2026Q1_20260630,力積電 2026 Q1 法說(HBM PWF 美光委託、預付 3 億美元、2027 Q2–Q3 量產)
- 產業_SEMIVISION_3D堆疊SRAM_20260520,SemiVision Research,2026-05-20(capture)
- 產業_SemiAnalysis_BroadcomTPU_Pumafish取消_20260518,SemiAnalysis,2026-05-18(HBM4E / TPU)
- 報告_HSBC_韓國AI供應鏈科技巡禮_20260602,HSBC,2026-06-02(HBM 市場規模、Samsung/SK Hynix 競爭、Vera Rubin HBM 比例)
- 報告_OCP2026_Marvell_客製HBM系統_20261015、報告_OCP2026_創意_AI運算記憶體連接擴展_20261015、video_OCP2026_Samsung_高擴展記憶體_20261015,OCP 2026(2026-10-12~15;HBM5 預測、熱通量、zHBM)
- 報告_SemiAnalysis_ECTC2026先進封裝_20260702,SemiAnalysis,2026-07-02(HBM4E 中介層/功耗衝擊、Marvell 客製 HBM、NVIDIA Feynman cHBM、TCB vs HCB 熱阻)
- 報告_UBS_記憶體月報_20260807,UBS,2026-08-07(Rubin Ultra HBM de-specing、HBM 終端需求/ASP 上修、供應商位元出貨與市占模型)
- 報告_MS_AI供應鏈_20260810,Morgan Stanley,2026-08-10(Rubin Ultra 多 SKU 分層規格:高階 HBM4e 8-Hi/低階 HBM4 12-Hi 或 8-Hi,3Q26 底前定案;de-spec 對 decoding 影響大於 pre-fill)
- web_Damnang_記憶體客製晶片轉型_20260709,Damnang(Substack),2026-07-09(HBM4 base die 三廠製程分工、sHBM/cHBM 分界、2026 產能售罄與 LTA/預付款結構)
相關頁面
- FORM.US(formfactor)
- 分析_CoWoS_2028產能模型與CSP資本支出電力_富邦_20261022
- 3443_創意電子(市)
- 分析_OCP2026_AI記憶體階層與客製晶片
- 技術_Chiplet
- 分析_半導體月營收與AI需求能見度_JPM_WSTS與Citi月報_20261012
- 7947_補丁科(興)
- 技術_NAND近記憶體化_KV Cache卸載與HBF
- 分析_群益4Q26產業展望_20260923
- 分析_記憶體去週期化與客製晶片轉型_Damnang_20260709
- 技術_Underfill底部填膠
- 分析_ECTC2026先進封裝五大戰線_260706
- 技術_VCS銅柱堆疊
- 技術_XPU
- 分析_記憶體創新六大路徑與TAM_MS_20260720
- 000660.KR(sk_hynix)
- 005930.KR(samsung)
- MU.US(micron)
- 分析_記憶體估值重置_大摩閉門_20260612
- 分析_Computex2026_GS半導體Day2重點_20260602
- 分析_晶圓到先進封裝全流程技術報告
- 分析_韓國AI供應鏈_HBM與FC-BGA上游_HSBC_20260602
- 技術_CXL
- 技術_I-Cube與X-Cube
- 技術_晶圓薄化
- 分析_記憶體月度供需與價格追蹤_UBS_20260807