定義
客製 HBM(Custom HBM, cHBM)是打破 JEDEC 標準介面邊界的 HBM 架構:DRAM core die 不變,但 base die(基底邏輯晶粒)改用先進邏輯製程客製化,把 HBM controller、標準 PHY、管理監控、甚至客製邏輯與擴充介面從加速器(XPU)搬進 HBM 堆疊底部。
JEDEC 標準固定了 HBM 堆疊與 host 之間的介面——好處是互通性(任何記憶體廠的 HBM 配任何相容 host),代價是功耗、效能與面積:host ASIC 必須實作標準 HBM PHY 並繞出超寬平行介面,pad 位置與 breakout 規則都被綁死。封裝越大、HBM 越快,這條固定邊界對 shoreline(晶粒邊緣可用長度)、繞線密度、供電與訊號完整性的限制越痛。
業界把仍遵循 JEDEC 標準的傳統 HBM 稱為 sHBM(standard HBM),與 cHBM 對稱。
圖解
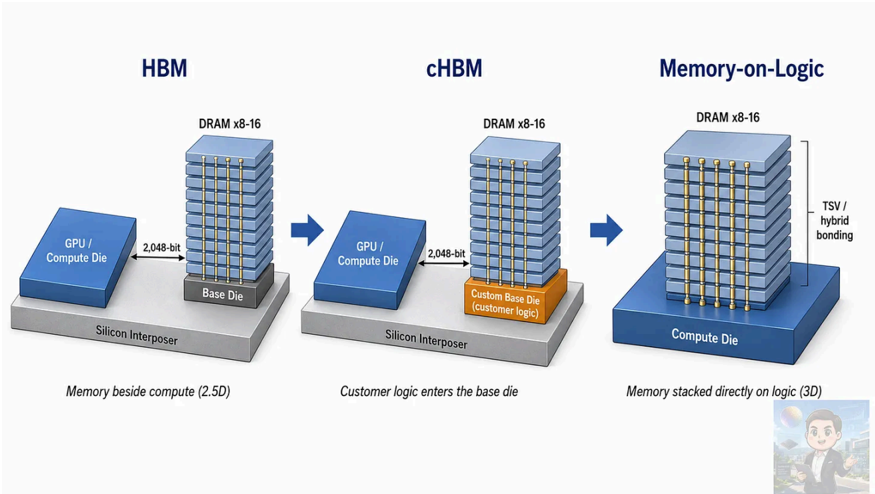
圖說:三段結構對比——HBM(GPU/Compute Die ↔ 2,048-bit ↔ DRAM x8-16 + Base Die,同置 Silicon Interposer,Memory beside compute 2.5D)→ cHBM(base die 換成橘色 Custom Base Die,customer logic enters the base die)→ Memory-on-Logic(DRAM 以 TSV/hybrid bonding 直接疊在 Compute Die 上,中介層消失)。來源:web_Damnang_記憶體客製晶片轉型_20260709 © Damnang
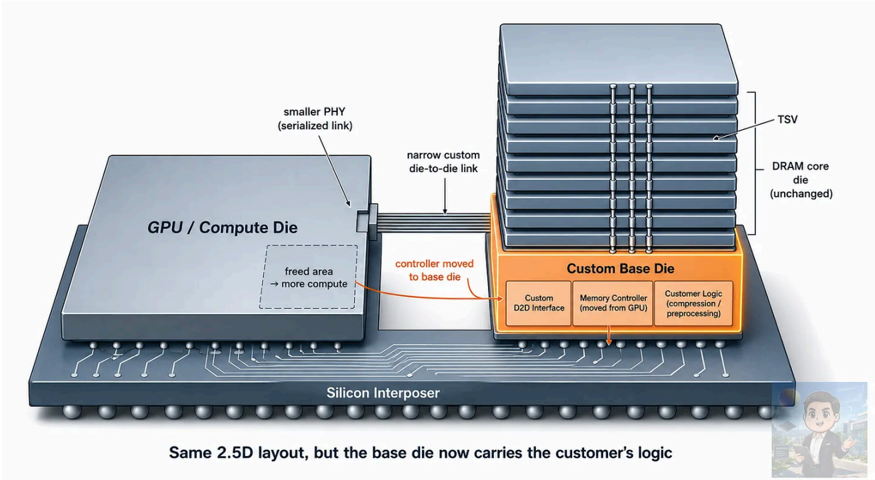
圖說:cHBM 剖面——GPU 側縮為 smaller PHY(serialized link)、留白標 freed area → more compute;中間為 narrow custom die-to-die link;右側 Custom Base Die 內含 Custom D2D Interface/Memory Controller (moved from GPU)/Customer Logic (compression / preprocessing),DRAM core die 標註 unchanged。底注:Same 2.5D layout, but the base die now carries the customer's logic。來源:web_Damnang_記憶體客製晶片轉型_20260709 © Damnang
base die 製程:三廠分工(2026-07 現況)
base die 的負擔逐代加重——介面位元數從 HBM3 的 1024-bit 翻倍到 HBM4 的 2048-bit,單腳速度同步提升,訊號處理/通道管理/電源管理複雜度一起上升。DRAM 製程為高電容密度而設計,拿來做邏輯電路會又大又慢,因此從 HBM4 起 base die 開始改用邏輯製程:
| 記憶體廠 | HBM4 base die 製程 | 備註 |
|---|---|---|
| SK hynix | 2330_台積電(市) 12nm | 最早外包邏輯代工 |
| Samsung | 自家代工廠 4nm | 唯一自產 |
| Micron | 沿用既有 DRAM 製程(成本考量) | 計畫自 HBM4E 起轉台積電邏輯製程 |
製程換了不等於客製化
即使 base die 改用邏輯製程,只要設計仍屬記憶體廠、產品仍符合 JEDEC 規範,它就還是 sHBM 標準品。cHBM 的分水嶺是「客戶的設計進入 base die」,不是製程節點。
Marvell 揭露的架構與量化效益(ECTC 2026)
Marvell 自 2024 年 Analyst Day 提出概念、Hot Chips 2025 揭露 base die floorplan,至 ECTC 2026 補齊封裝級細節:
| 項目 | 數據 | 意義 |
|---|---|---|
| host ASIC 的 HBM PHY 面積 | −60% | 釋放給運算/快取/IO |
| 範例組態頻寬 | 1024 通道 @32Gb/s = 4.1 TB/s | 等效 2048-bit JEDEC HBM4E @16Gb/s |
| 中介層通道長度 | 6.5mm → 1.5mm | beachfront 深度 −67%,繞線壅塞大減 |
| 中介層 | 有機 RDL 取代矽中介層 | 降成本;9 層 2/2µm L/S 維持不變下頻寬提升 |
有機 RDL 線寬遠粗於矽中介層/矽橋,Marvell 靠分區客製遮蔽與繞線 pattern 控制串擾、最大化頻寬密度。
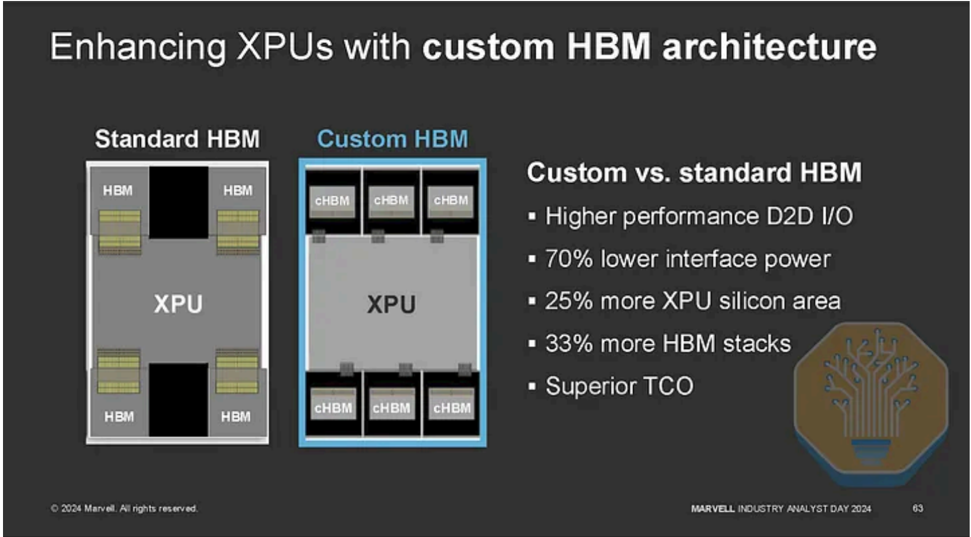
圖說:Marvell 投影片——Standard vs Custom HBM 的 XPU 佈局對比,列 70% lower interface power、25% more XPU silicon area、33% more HBM stacks、Superior TCO。來源:Marvell Industry Analyst Day 2024 © SemiAnalysis
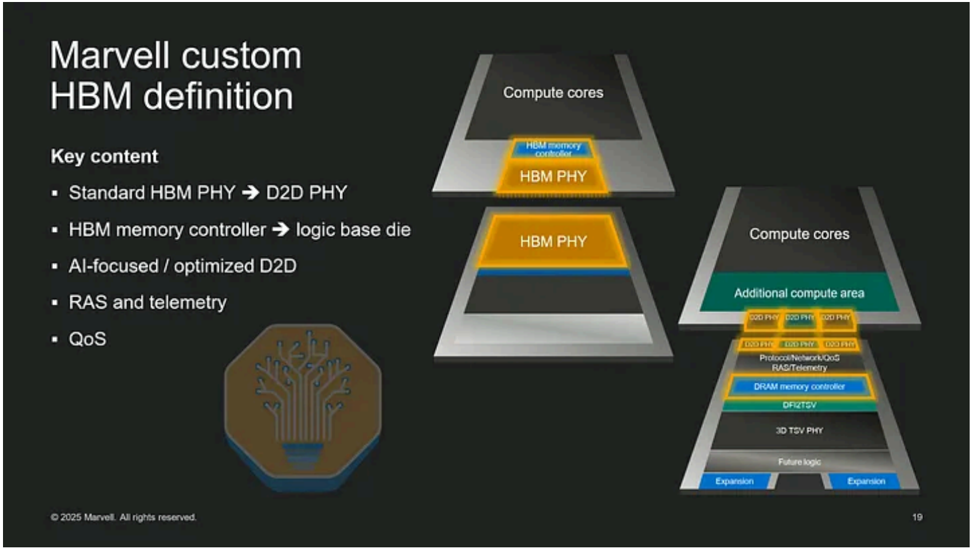
圖說:Marvell custom HBM 定義投影片——Standard HBM PHY→D2D PHY、HBM controller 移入 logic base die、3D 堆疊分層示意(D2D PHY/Protocol/QoS/RAS/DRAM controller/DFI2TSV/3D TSV PHY/Expansion)。來源:Marvell Hot Chips 2025 © SemiAnalysis
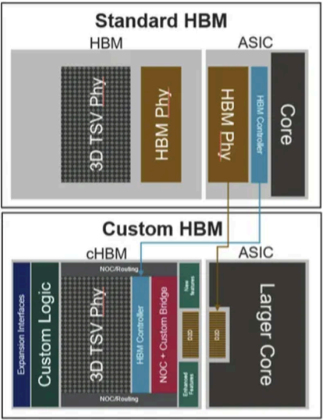
圖說:Standard vs Custom HBM 的 base die 與 host ASIC floorplan 對比——cHBM base die 含 Custom Logic、NOC+Custom Bridge、Expansion Interfaces,host 側 core 面積放大。來源:Marvell, ECTC 2026 © SemiAnalysis
Marvell 的 OCP 2026 論述:面積、D2D 與熱(2026-10)
Marvell 在 OCP 2026 以「客製 HBM 當成系統」為題(報告_OCP2026_Marvell_客製HBM系統_20261015,2026-10),為廠商論述,簡報未提客戶、量產時程、base die 製程節點:
| 項目 | 數據(Marvell 口徑) | 與本頁他處的基準差異 |
|---|---|---|
| HBM 佔比 | HBM 約占 XPU die 面積 30%、XPU 成本 >50%;記憶體 BOM 在許多 GPGPU/ASIC 占 60–80% | SemiAnalysis 估 Rubin 約 16% die 面積為「HBM 相關邏輯與 PHY」,對象與基準不同,不互相覆蓋 |
| 搬進 base die 的回收 | PHY 與 controller 移入客製 base die,回收至多 25% 面積、至多 30% 更多運算 | ECTC 的 host PHY −60% 是 PHY 自身面積,25% 是整體 die 面積,不衝突 |
| D2D | 稱 UCIe 非為 HBM 級頻寬密度設計;推 SBD:64 Gbps/wire 同時雙向、PHY 面積 15%、D2D 功耗最多 −75%(尖峰 −42%)、>7 TB/s 密度(引 2025-08 新聞稿,2nm);HBM5 需約 6.4 Tbps/mm | D2D 標準尚未收斂:創意主推自有 GLink、聯發科仍用 UCIe/Mlink,見 技術_UCIe;三者皆為 IP 賣方立場 |
| 每堆疊頻寬 | HBM4 2.0–3.3、HBM4E 3.6–4.1、next-gen 5.3–7.2 TB/s(至 28 Gbps) | 簡報引 JEDEC、Hot Chips 等二手資料,未獨立驗證 |
| 熱 | HBM 熱通量超過 JEDEC 約 1.7 W/mm²,HBM5 >2.0 W/mm²(>28 Gbps);HBM5 約 100W/stack,D2D PHY 最熱;8-hi→16-hi 約 2028 逼近熱預算;混合鍵合降 D2D 熱阻 23–47%、堆疊高度縮 >15%;SK hynix iHBM 矽 ICE 熱阻約 −30% | 創意(GUC)HBM5 估約 90W(32 Gbps),同量級;詳見 技術_HBM |
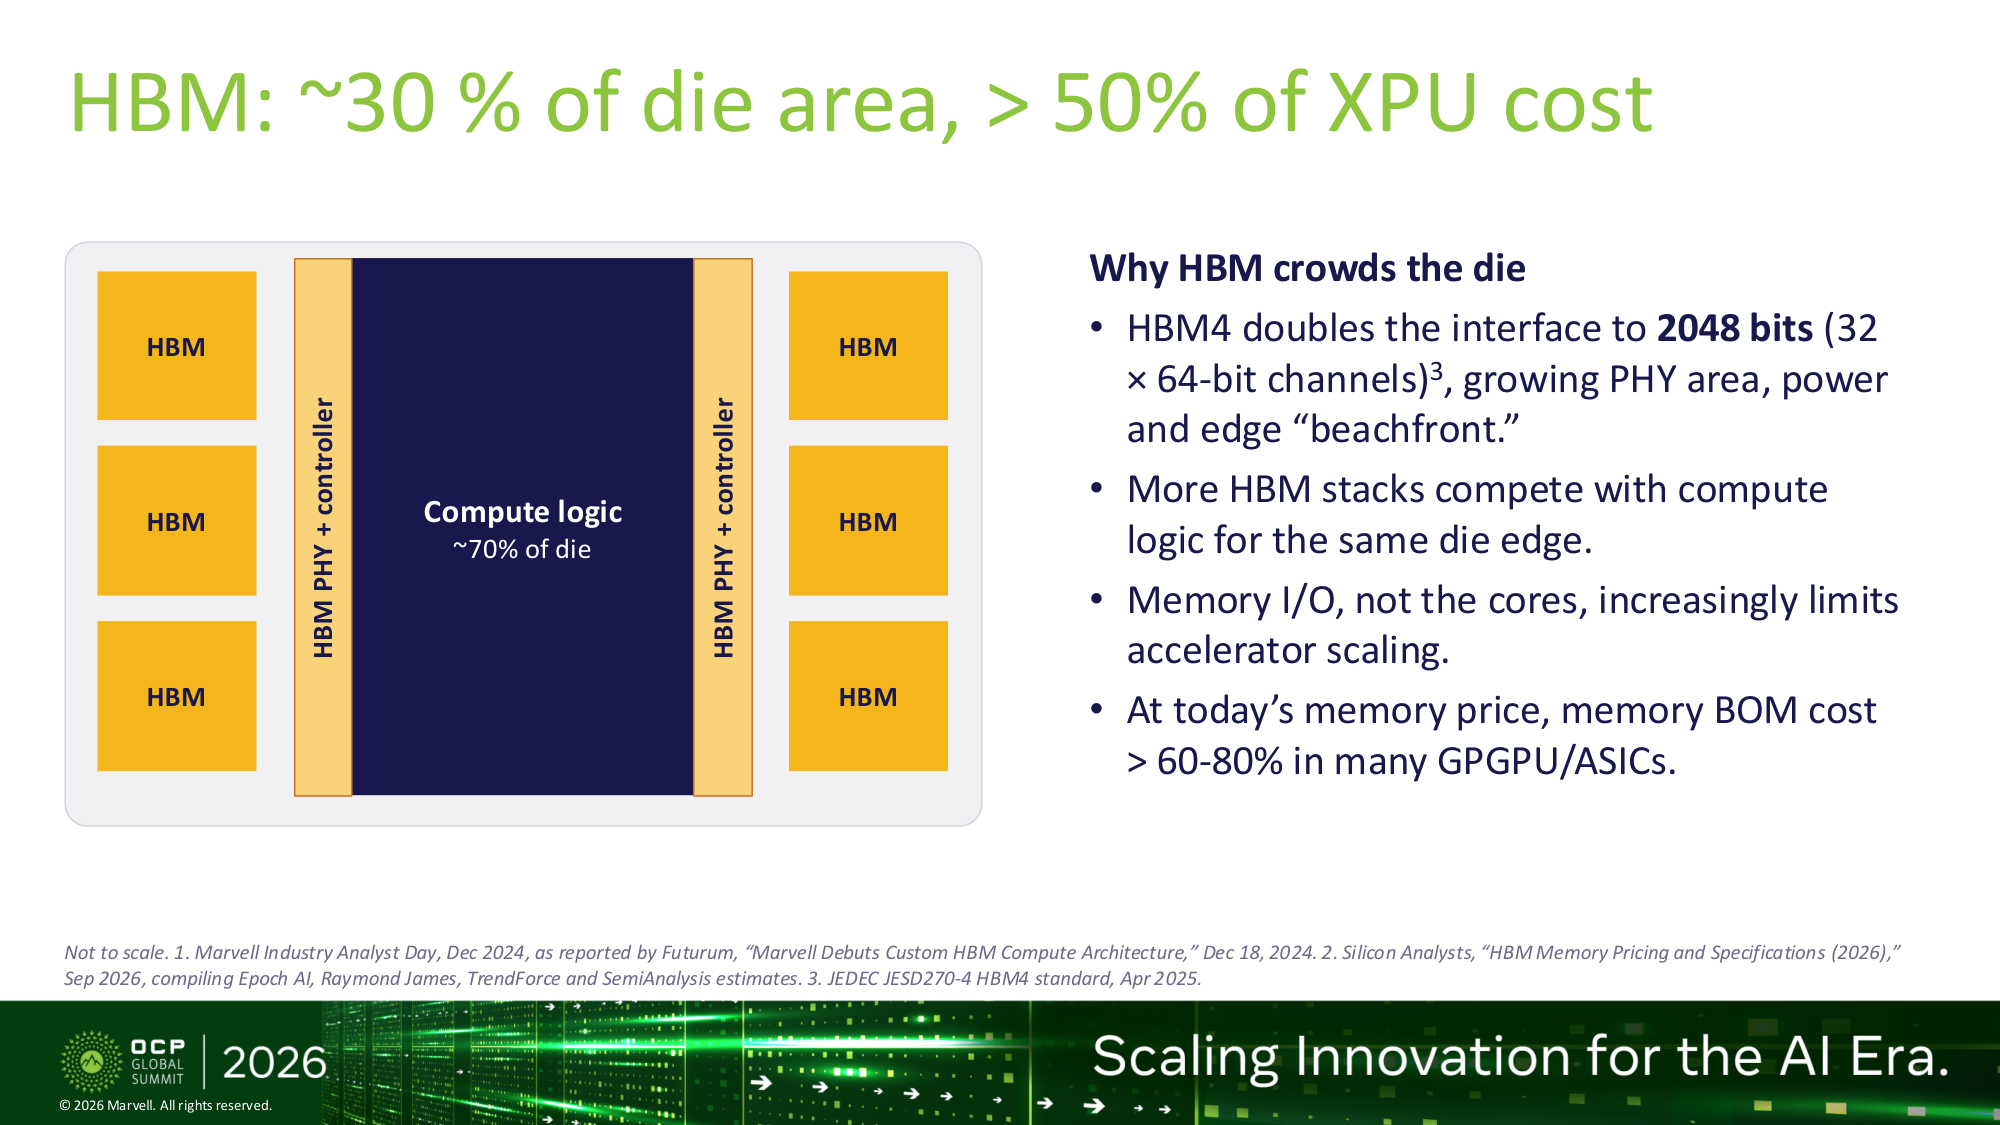
圖說(Marvell 簡報 p3):HBM 在 XPU 的面積與成本占比;來源 報告_OCP2026_Marvell_客製HBM系統_20261015。
產業採用
- NVIDIA:GTC 宣布 Feynman 世代採用客製 HBM。SemiAnalysis 估 Rubin GPU 約 16% die 面積花在 HBM 相關邏輯與 PHY(與上節 Marvell 的 30% 基準不同)——cHBM 把這塊負擔移到 base die,動機與 Marvell 相同(更高頻寬、更低功耗、省加速器面積)
- 擴充介面:base die 可作第二記憶體控制器,外擴 LPDDR 或第二層 HBM,不占加速器 die shoreline——與 AMD MI450/未來 MI500 支援 LPDDR 擴容的路線直接相關
- 三家記憶體廠皆已把客製 HBM 列入官方路線圖;MRVL.US(marvell) 宣布正與三家共同開發客製 HBM 架構(2026-07)
誰主導 base die 設計:三種模式
cHBM 沒有單一分工樣板,實際落地至少三種:
| 模式 | 主導方 | 代表 | 對記憶體廠的意涵 |
|---|---|---|---|
| 記憶體廠依客戶規格設計 | 記憶體廠 | 三雄各自對大客戶 | 設計價值仍留在記憶體廠,最接近現況延伸 |
| ASIC 夥伴共同定義 | 設計服務/ASIC 廠 | MRVL.US(marvell) 與三家記憶體廠 | 介面與 controller 價值讓渡給 ASIC 廠 |
| 客戶直接設計 base die 邏輯 | 終端客戶 | NVDA.US(nvidia) | 記憶體廠退回「DRAM core + 製造」角色 |
不論何種模式,記憶體堆疊與邏輯電路必須當成一個整體驗證,規格必須在設計最初階段雙方共同定義——這是商業模式改變的起點,而非結果。
商業模式:從量的合約變成產品的合約
商品化前提的瓦解
載有客戶客製電路的 HBM 是該客戶專用件,不能轉賣給其他買家;對客戶而言,嵌入自身電路的記憶體也難以更換供應商。從 cHBM 起,「規格相符即可互換」的商品前提不再成立。
| 面向 | sHBM + LTA(現況) | cHBM |
|---|---|---|
| 合約性質 | 量與價的長期協議(LTA) | 產品合約,規格與量提前 2–3 年鎖定,近似邏輯 ASIC 的訂單積壓 |
| 收入項目 | 位元 × ASP | 新增 NRE(非經常性工程)收入回收共同設計投入 |
| 定價機制 | 跟隨市場供需波動 | 依設計成本與價值談判 |
| 鎖定層級 | 認證 + 產能預留(合約到期即重談) | 綁定客戶自身設計,換供應商=重新設計;沿用既有設計反而提高下一代勝率 |
| 溢價上限 | HBM 已是同容量 DDR5 的 5–6 倍 | 替代品消失,溢價上限再開 |
時間節奏:綜合 Samsung 與 SK hynix 高層公開說法,客製 HBM 自 2027 年起加速,2028–2029 前後成為 HBM 市場的重要支柱。
風險面:客製化=客戶集中。產能一旦分配給某客戶專屬設計,該客戶晶片若在市場失敗,這批產能無處可去;設計競標失敗則直接失去該客戶整個世代的訂單。營收波動性從「市場驅動」轉為「訂單驅動」,波動本身並未消失——但邏輯 ASIC 業者的歷史顯示,訂單型週期在資本市場拿到的評價倍數高於不可預測的市場週期。
熱設計連動
cHBM 把 controller 與更多邏輯搬進 base die → base die 功耗放大 → HBM 堆疊的熱瓶頸從 GPU-HBM 串擾轉向堆疊本身(Samsung 量測:base die 功耗 ×3 時,GPU-HBM 串擾占總熱阻比例從 13% 掉到 5%)。這使混合鍵合(HCB)取代 TCB 的熱效益更關鍵,詳見 技術_HBM 與 技術_混合鍵合。
投資判讀
- base die 從 DRAM 製程升級為先進邏輯製程 = 在記憶體三雄之外新增一塊先進邏輯代工 TAM,2330_台積電(市) 是天然受惠者(base die 代工 + GPU 面積釋放給運算 = 更高 wafer 價值)
- 記憶體廠角色轉變:DRAM core 仍是三雄的,但介面價值部分讓渡給邏輯代工與設計服務——對 Samsung/SK hynix/Micron 中性偏正(cHBM 單價更高),對 IP/設計服務(Marvell、可能含台系設計服務)是新戰場
- 有機 RDL 中介層替代矽中介層的示範,長期利多 panel 級 RDL 與 CoWoS-R 類平台(見 技術_RDL)
來源
- 報告_SemiAnalysis_ECTC2026先進封裝_20260702,SemiAnalysis,2026-07-02(Marvell cHBM 封裝細節、NVIDIA Feynman、AMD LPDDR 擴容、−60% PHY 面積、4.1TB/s)
- web_Damnang_記憶體客製晶片轉型_20260709,Damnang(Substack),2026-07-09(sHBM/cHBM/Memory-on-Logic 三段演進、三廠 base die 製程分工、base die 設計主導三模式、合約從量約轉產品約與 NRE 收入、2027 加速/2028–29 成主力)