定義
Scale-up 是在同一 computing unit 內增加 GPU / XPU / switch / memory 等資源,讓它們以極高頻寬、低延遲方式互連。傳統定義多指同一 rack 內;新一代 AI supernode 會把 scale-up 延伸到跨 rack,但目標仍是讓跨 rack 連線速度接近 rack 內連線。
GS 2026 AI 光網路報告將 scale-up 定義為在同一設備 / computing unit 內增加 GPU 與運算資源;NVIDIA Vera Rubin / Rubin Ultra 將 scale-up 從 NVL72 擴到 NVL576 等 supernode。
主要互連方式
| 階段 | 代表互連 | 說明 |
|---|---|---|
| Rack 內短距 | PCB trace、DAC、AEC、NVLink cable | 低延遲與可維修性優先 |
| Rack / tray 結構 | PCB midplane、CPC | 初期成本高,但高速與組裝效率改善 |
| 更高頻寬 | NPO / CPO、parallel optics、BiDi optics | 光逐步靠近 ASIC / switch,降低長銅通道損耗 |
| 下一代 | scale-up OCS、photonic fabric | 仍待插損、SOA 噪聲、SiN / SiPh 製程驗證 |
與 TFF / DWDM 的關係
Scale-up 追求極低延遲、短距高頻寬與可維修性,不等於必然採用離散 DWDM / TFF。若平台商採多光纖 parallel optics、BiDi、多排 FAU 或 on-chip WDM,傳統離散 TFF MUX/DEMUX 用量可能低於 CPO 題材想像。
| 架構選擇 | 對 TFF / DWDM |
|---|---|
| 多光纖 parallel optics | 單纖多波長需求下降,TFF 槓桿較低 |
| BiDi / 多排 FAU | 仍需光學耦合與濾光,但不一定是高階 DWDM TFF |
| 離散 WDM MUX/DEMUX | TFF 需求上升 |
| on-chip AWG / ring / echelle | MUX/DEMUX 需求存在,但可能不由離散 TFF 承接 |
| ELS / 光源濾鏡 | TFF 可作光源濾波、帶通、邊緣濾光或 PBS/PBC,需看平台設計 |
圖解
flowchart TD
    A["Scale-up:同一 computing unit 內<br>GPU / XPU / switch / memory 互連"]
    A --> B["Rack 內短距<br>PCB trace / DAC / AEC / NVLink cable"]
    B --> C["Rack / tray 結構<br>PCB midplane / CPC"]
    C --> D["更高頻寬<br>NPO / CPO、parallel optics、BiDi optics"]
    D --> E["下一代<br>scale-up OCS、photonic fabric"]
    D --> F["架構選擇對 TFF/DWDM 的影響"]
    F --> F1["多光纖 parallel optics<br>TFF 槓桿較低"]
    F --> F2["BiDi / 多排 FAU<br>不一定是高階 DWDM TFF"]
    F --> F3["離散 WDM MUX/DEMUX<br>TFF 需求上升"]
    F --> F4["on-chip AWG / ring / echelle<br>可能不由離散 TFF 承接"]
中國廠商 SuperPod 案例(2026 上海 WAIC)
MS(報告_MS_上海WAIC_20260721,2026-07-21)觀察 WAIC 2026 展場:中國本土 AI 運算競爭已從單顆晶片規格轉向 SuperPod 系統級整合,幾乎每家本土加速器廠商都展示 64 卡或 128 卡的 scale-up 系統,由中國廠商自有 scale-up 協定支撐(相對 NVIDIA NVLink、AMD UALink)。
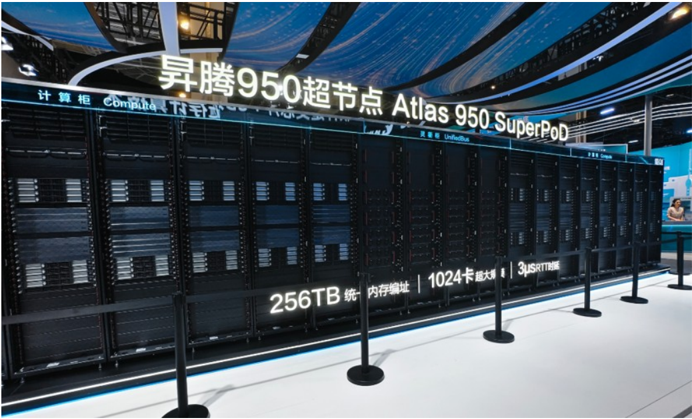
圖說:華為 Atlas 950 SuperPod 展場實拍,看板顯示「256TB 統一內存編址」「1024卡 超大規模」「3μs RTT 時延」。來源:報告_MS_上海WAIC_20260721
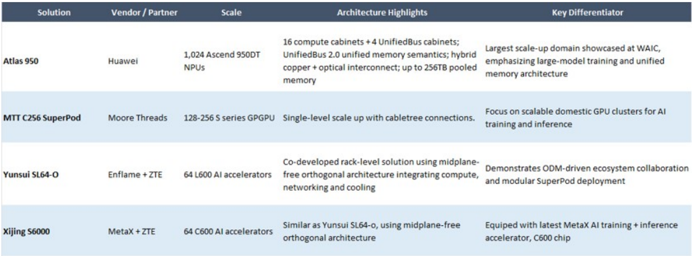
圖說:主要 SuperPod 方案比較表(Atlas 950/MTT C256 SuperPod/Yunsui SL64-O/Xijing S6000),列出廠商/夥伴、規模、架構亮點與關鍵差異化。來源:報告_MS_上海WAIC_20260721
| 方案 | 廠商/夥伴 | 規模 | 架構亮點 |
|---|---|---|---|
| Atlas 950 | 華為 | 1,024 顆 Ascend 950DT NPU | 16 個運算櫃+4 個 UnifiedBus 互連櫃;UnifiedBus 2.0 統一記憶體語義;銅+光混合互連 |
| MTT C256 SuperPod | 摩爾線程(Moore Threads) | 128-256 顆 S 系列 GPGPU | 單層 scale-up,cabletree 連接 |
| Yunsui SL64-O | Enflame(燧原)+ ZTE | 64 顆 L600 加速器 | ODM 共同開發機櫃級方案,midplane-free 正交架構整合運算/網路/散熱 |
| Xijing S6000 | MetaX(沐曦)+ ZTE | 64 顆 C600 加速器 | 架構近似 Yunsui SL64-O,搭載最新 MetaX AI 訓練+推論晶片 |
觀察重點: - 64-128 卡 scale-up 架構成為常態:相較過往以 8 卡伺服器為主的小型叢集,本土廠商更強調 collective communication 效率、記憶體共享與系統級稼動率。 - midplane-free orthogonal(無中板正交)設計漸成主流:華為、中興等採此設計取代傳統大型中央 PCB 背板,降低製造與良率挑戰,但連接器設計複雜度與訊號完整性要求提高。 - GPU:CPU 配比仍集中在 4:1 或 8:1:反映當前工作負載仍以傳統推論/部分訓練為主,agentic AI 尚未大規模放量;隨 agentic workload 增加資料前處理/orchestration 需求,CPU 配比可能提升。 - P/D(Prefill/Decode)disaggregation 成為新推論架構主題:將運算密集的 prefill 與頻寬/延遲敏感的 decode 分離部署於不同加速器池,WAIC 現場一案例將約 90% 本土加速器容量配置 prefill、10% H20 容量配置 decode,回報 throughput +54%、P90 TTFT -64%(單一案例,效益依模型架構/排程/互連而異)。
全球 scale-up 互連技術對照(MS,2026-07-27)
什麼是 scale-up networking:同一伺服器或機櫃內 GPU/加速器之間的高速通訊。把加速器互連起來,讓它們像單一超級電腦一樣運作、存取相同記憶體、處理同一個工作負載。這與 scale-out(跨資料中心基礎設施連接多個系統)不同。
MS 觀察:scale-up 正在成為架構差異化的主戰場,而 scale-out 仍是大規模叢集的骨幹。系統方案普遍以專用 fabric 連接超節點內的加速器,再以乙太網路類 fabric(RoCE、UBoE)或 InfiniBand 連接跨超節點的叢集——NVIDIA 以 NVLink 搭 InfiniBand 或 Spectrum-X 乙太網路;AMD Helios 以 UALink 搭乙太網路 scale-out;華為在 SuperPoD 內用 UnifiedBus、SuperPoD 之間用 UBoE 或 RoCE。
| 廠商 | 超節點/加速器 | Scale-up 方案 | 技術基礎 | 單通道速率 | 每加速器總頻寬 | 超節點加速器數 | 實體介面 | 銅纜 | CPO | NPO |
|---|---|---|---|---|---|---|---|---|---|---|
| NVDA.US(nvidia) | GB300 NVL72(144 die) | NVLink 5 + NVSwitch | 專有 | 實體通道速率 N/A;每條 NVLink 5 鏈路 100GB/s | 1.8TB/s | 72 | 被動銅;NVLink cable-cartridge/背板 | 是 | scale-up 否(scale-out 是) | 否 |
| AMD.US(amd) | Helios/MI455X | UALink 1.0/UALoE | 乙太網 PHY 基礎、記憶體語義 UALink fabric | 200Gb/s per lane(212.5GT/s raw) | 3.6TB/s | 72 | 電氣/銅 | 是 | 否 | 否 |
| ALAB.US(asteralabs) | — | Scorpio X-Series | PCIe Gen6 | 未揭露 | 未揭露 | 每 switch 最多 80(merchant 方案) | 電氣/銅 | 是 | 否 | 否 |
| 華為 | Atlas 950 SuperPoD | UnifiedBus 2.0 | 專有 | 106.25Gb/s PAM4(UB2.0 規範) | 2TB/s | 1,024 NPU 已展示/宣稱可達 8,192 | 混合:櫃內正交無纜電互連、跨櫃光互連 | 否(無纜) | 未揭露 | 未揭露 |
| 摩爾線程 | MTT C256/MTT S5000、PH100 | MTLink 2.0 | 專有 | 112Gb/s per lane | 800GB/s | 單櫃 128/雙櫃 256 | 全銅 Cable Tray | 是 | 否 | 否 |
| 曙光(Sugon) | scaleX640 | scaleX fabric | 開放多供應商系統架構 | 未揭露 | 未揭露 | 640(單櫃) | 電氣/銅 | 未揭露 | 未揭露 | 未揭露 |
| 沐曦(MetaX) | 曦晶 S600/C600 | MetaXLink/MetaXLink-E | 專有 | 未揭露 | 未揭露 | S600 櫃 64/經 C600 MetaXLink-E 128 | 無纜 OEX 電互連 | 否(無纜) | 否 | 否 |
| 阿里巴巴 | 磐久 AL128/震旦 M890 | ALink system;M890 實作 ICN + ICN Switch 1.0 | 支援專有協定與 UALink | 平台層支援 112G/224G SerDes | 800GB/s | 每櫃 128;已揭露全頻寬 ICN 域 64 | 無背板正交電互連;NPC 互連 | 是 | 否 | 否 |
| 燧原(Enflame) | 雲燧 ESL64-O | GCU-LARE | 專有 | 未揭露 | 未揭露 | 64 | 無纜 OEX 電互連 | 否(無纜) | 否 | 否 |
| 燧原(Enflame) | NPO 光學原型 | 未揭露 | 未揭露 | 未揭露 | 未揭露 | 512 以上 | NPO 光學 | 否 | 否 | 是 |
| 壁仞(Biren) | LightSphere 128/Bili 166L | 未揭露 | SiPh OCS(曦智科技供應) | 未揭露 | 未揭露 | 128 | SiPh 光路交換 | 否 | 否 | 否 |
| 壁仞(Biren) | BR2xx NPO 超節點(已發表) | BLink 2.0 | 專有 | 未揭露 | 未揭露 | 1,024 | NPO 光學 | 否 | 否 | 是 |
來源:報告_MS_AI網通_20260727(Exhibit 4,Company data/Morgan Stanley Research)。表中「未揭露」為原表 Undisclosed,非資料缺漏。
中國 scale-up 的技術分界線:櫃內以電互連為優先(短電氣鏈路成本低、板/tray/單櫃整合簡單),跨櫃則光互連更有吸引力(銅的傳輸距離、訊號損耗與功耗成為限制)。華為 Atlas 950 SuperPoD 即以光互連把 UnifiedBus 延伸到同一 SuperPoD 內的跨櫃連線。中國廠商在光互連與機櫃系統設計上具競爭力,但在晶片層受限於晶圓製程——這正把中國 AI 運算市場的競爭從「單顆晶片規格」推向「系統解決方案」,WAIC 2026 的晶片發表變少、超節點方案變多即為此現象。NPO/CPO 的中國實作細節見 技術_NPO。
開放標準三陣營:ESUN/SUE-T、UALink 與專有(OCP 2026,2026-10)
OCP 2026 峰會(2026-10-12~15)上,乙太網路陣營與 UALink 陣營各自公布進度;NVIDIA NVLink 與華為 UnifiedBus 等專有協定仍並行(見上方對照表)。
| 項目 | 乙太陣營(ESUN+SUE-T) | UALink |
|---|---|---|
| 定位 | ESUN 為 OCP fabric 層(Meta、Microsoft 主導);SUE-T 為 XPU 端傳輸(Arista、Broadcom),疊在 UET SES+RODL 與 ESUN 標頭之上 | 聯盟制定的記憶體語義 fabric(load/store/atomic),AMD 任董事長 |
| 規格進度 | ESUN 1.0 於 2026-03 發布(Broadcom 稱 2026-02,口徑見 技術_ESUN);1.1 目標 2026-10~11;SUE-T 目標 2H26 | 200G 1.0(2025-04)、2.0 加 Collectives(2026-04)、Compliance 1.0(4Q26)、3.0(2027) |
| 產品現況 | Broadcom 稱 5 家以上 hyperscaler 已量產乙太 scale-up,未來 6 個月多個客製/商用 XPU 乙太 scale-up 機櫃量產(廠商自述,未具名客戶);Meta Tahan 為公開實例 | 簡報稱交換器生態仍在早期,未宣布交換器出貨;AMD Helios 以 UALoE 承載 |
詳見 技術_ESUN、技術_UALink。(報告_OCP2026_Microsoft_Meta_ESUN乙太網路ScaleUp_20261015、報告_OCP2026_Arista_Broadcom_SUE-T_20261015、報告_OCP2026_UALink生態系_20261015、報告_OCP2026_Broadcom_主題演講_開放創新擴展AI_20261015,2026-10)
Meta Tahan:乙太 scale-up 交換器實例
Tahan 為 Meta MTIA 300 訓練加速器專用:Broadcom Tomahawk5 51.2T、1OU 混合液冷;16 顆加速器各 2×800G,4 台 Tahan 達 6.4Tbps/加速器/單向 non-blocking;任兩加速器 1 hop,單跳 <1µs。次世代以 Tomahawk6 102.4T 連 72 顆加速器(24×400G),每加速器 9.6Tbps(1.5 倍)。規格將貢獻 OCP,無日期;簡報未提 ODM 與量產時程,僅明講 MTIA 300。(報告_OCP2026_Meta_Tahan乙太網路ScaleUp交換器_20261015,2026-10)
AMD Helios:UALoE 與輕量 NIC
Helios 72 顆 MI455X:UALoE 每 GPU 1.8 TB/s/方向、12 顆 TH6 交換、260 TB/s scale-up;AMD 將 Infinity Fabric/UAL 的 load/store 直接封進乙太封包,輕量 NIC 整合在 GPU fabric 內;UALoE 有鏈路層重試與 vPod 故障域隔離。AMD 機櫃首席架構師稱這可能是最後幾代全電氣 scale-up 之一。(報告_OCP2026_AMD_HPE_開放標準AI機櫃_20261015、video_OCP2026_AMD_Helios機櫃設計_20261015,2026-10)
銅背板路線與 Broadcom 預告
Broadcom 主題演講:機櫃內銅背板現世代 1.04 Pbps(72 XPU、每 XPU 14.4 Tbps、512×200G PAM4、9–12 顆交換器、約 250 kW,TH6 量產中);「可能的」次世代 2.08 Pbps(28.8 Tbps/XPU、576×400G PAM6、9 顆交換器、約 500 kW),twinax 密度皆為每 OU 1,024 條 26 AWG、銅距約 2 m;次世代標示 Possible、無年份,PAM6 400G 是否為實際 SerDes 規劃未確認。跨櫃改用 OCI 光學(576 規模域,光纖延遲每公尺 5 ns),200G 連結功耗 DAC 7 pJ/bit/2 m、Integrated OCI 7 pJ/bit/500 m、DR LRO 可插拔 23 pJ/bit/500 m(廠商自述)。(報告_OCP2026_Broadcom_主題演講_開放創新擴展AI_20261015,2026-10)
銅光分界:各家口徑(OCP 2026,2026-10)
| 來源 | 銅的可用距離 | 光的切入條件 | 口徑 |
|---|---|---|---|
| Celestica | 224G:被動 DAC ≤1.0m、ACC 1.2–2m、AEC 2–5m、LPO 2–10m+、LRO/FRO 10–500m | 主張 XPO+socketed NPO 第一階段,再上光運算 fabric | 224G 世代 |
| Astera Labs | Passive DAC 至 3m、ACC 4m、AEC 7m | pod ≤144 顆銅背板;72–576 顆銅加 NPO 混合;>576 顆全光 NPO/CPO | 一般距離,非 224G |
| Dell | 200G/lane 被動銅數公尺;400G/lane 以上 <1m | 銅光混合,XPO/Open CPX 光解耦 | 系統商願景,不給日期 |
| Amphenol | 封裝直接 launch 可讓 cartridge 銅段達 2m、全櫃 0.8m(224G,預算 22 dB/40 dB) | 256 GPU 四櫃範例:櫃內 4,096 銅 lane、跨櫃 12,288 光纖 lane,銅 25%/光 75% | 通道預算推演,單一來源 |
Celestica 與 Astera 差 2–3 倍,主因是 Celestica 為 224G、Astera 為一般距離;群益 ECOC 的「200G 銅線約 2.5 公尺」較接近 ACC/主動銅口徑,並非被動銅。(報告_OCP2026_Celestica_ScaleUp互連轉折點_20261015、報告_OCP2026_AsteraLabs_NPO與CPO_ScaleUp_20261015、報告_OCP2026_Dell_ScaleUp光學機會_20261015、報告_OCP2026_Amphenol_銅光協同設計_20261015,2026-10)
Soitec(基板商,SEMICON Taiwan 2026-08-31;產業_SEMICON2026矽光子論壇_Soitec簡報_20260831)給出時程口徑:scale-out 與 scale-across 已 100% 光學,2027 年起 scale-up 逐步轉光;機櫃先走「櫃內銅、跨櫃光」的混合階段,2029 年起可能出現運算與網路拆解的全光機櫃(講者看法,逐字稿 產業_SEMICON2026矽光子論壇_Soitec逐字稿_20260831,非預測模型)。
光纖用量不可互比
群益稱 Tomahawk 7 串 1,024 XPU 需 131,072 光纖(BiDi,每 XPU 128 光纖);Amphenol 256 GPU 為 12,288 光纖 lane(每 GPU 48)。拓撲與 lane 定義不同,不可直接比。
Flap 與爆炸半徑:光化 scale-up 的可靠度門檻(OCP 2026,2026-10)
- Microsoft:flap=微秒至數分鐘的鏈路中斷,交換器已處理數十年,GPU 不能容忍;光共用雷射與 PIC,失效「爆炸半徑」遠大於銅:共用雷射源到模組 100%,光板雙雷射 25–50%,CWDM 4 波長 25%,NPC 搭 interleaving 25%(皆為目標與示意)。示例(非現場資料)Flap-FIT 10K、1K GPU pod 約 0.8 小時 MTBF。(報告_OCP2026_Microsoft_光學ScaleUp架構_20261015、報告_OCP2026_Microsoft_Marvell_ScaleUp光鏈路可靠度_20261015,2026-10)
- Marvell 風險模型(非現場數據):約 3M GPU、>10M 光鏈路,等於每 48 秒一次 flap;其目標為「可能 flap 的鏈路 <1%」,成功指標是作業不中斷而非鏈路可用率;主張 NPO now、CPO next。(同上)
- Broadcom 另自述 CPO 超過 1M 裝置小時零 link flap,與以上顧慮為不同視角。(報告_OCP2026_Broadcom_CPO與OCI_20261015,2026-10)
OpenAI Jalapeño 拓撲
OpenAI 在 Celestica/Broadcom 聯合場以「同等 SLA 延遲下的每瓦請求數」定義 fabric 需求,並展示自研 Jalapeño:host 加加速器機櫃成對、half flattened 兩層 Clos,本地域 128 顆 Jalapeño 接 Broadcom TH6,全域 2,048 顆經 8 個 TH6 rail;量產時點簡報未提。Celestica 稱單一 scale-up 機櫃約 5,000 條被動銅纜、約 1 MW 液冷,1.6T 銅距縮短須轉光。(報告_OCP2026_Celestica_Broadcom_OpenAI_光運算AI網路_20261015,2026-10)
Scale-up TAM
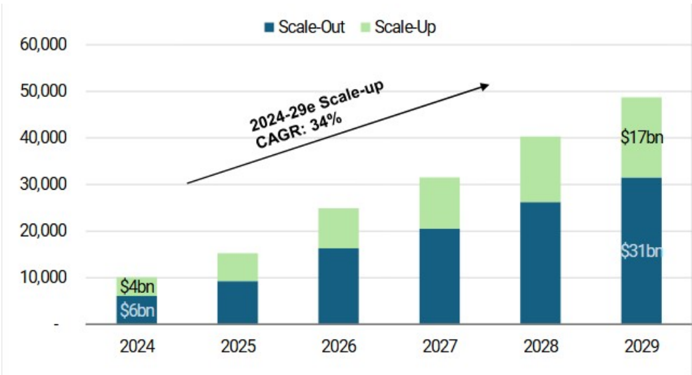
Exhibit 14:美系半導體 scale-up TAM 估計(US$mn)堆疊柱狀圖。深藍為 Scale-Out、淺綠為 Scale-Up:2024 年為 $6bn+$4bn,2029 年為 $31bn+$17bn;圖上標註 2024-29e Scale-up CAGR 34%。來源:報告_MS_AI網通_20260727(Company data, Morgan Stanley Research estimates)。
Scale-up 自 2024 年約 $4bn 成長至 2029 年約 $17bn,五年 CAGR 34%,成長速度高於同期 scale-out($6bn→$31bn)。生態系玩家橫跨 AVGO.US(broadcom)、MRVL.US(marvell)、Alchip 等,對應 Trainium2/MTIA v2/Maia custom/NeuronLink/PCIe 等平台世代。
中美 AI 產業相對強度
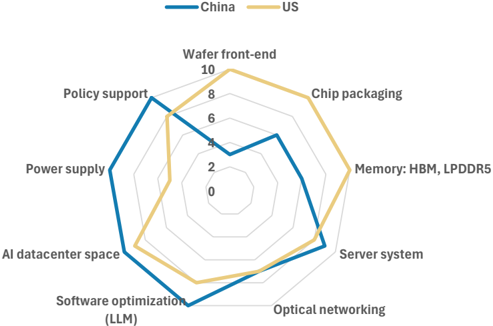
Exhibit 6:中美 AI 產業相對強度雷達圖(藍=China、黃=US),軸向為 Wafer front-end/Chip packaging/Memory: HBM, LPDDR5/Server system/Optical networking/Software optimization (LLM)/AI datacenter space/Power supply/Policy support。Optical networking 兩條線幾乎重疊;Wafer front-end 與 Memory 美國明顯領先;Power supply、AI datacenter space、Policy support 則中國領先。來源:報告_MS_AI網通_20260727(Morgan Stanley Research)。
這張圖是理解中國 scale-up 路線的關鍵:光網路是中國少數與美國並駕齊驅的環節,因此當晶片層受製程限制時,用光互連把更多卡串成超節點,是最合理的系統級補償路徑。
個股意涵(MS,2026-07-27)
- 瀾起科技(Montage,6809.HK/688008.SS,OW):更大、更分散的超節點會提高 PCIe 互連含量——系統跨櫃擴展後,CPU、xPU、switch、NIC 與周邊之間的 PCIe 鏈路變得更密、更長,支撐 PCIe retimer 與 PCIe switch 晶片需求。瀾起的 PCIe 6.x/CXL 3.x x16 AEC 已完成互通性測試,鎖定超節點與跨櫃部署;中國系統每單位算力配置更多 xPU,會進一步推升 PCIe 含量。
- 中國 AI GPU 廠:海光(Hygon,OW)與其生態夥伴曙光、寒武紀(Cambricon,OW)、天數智芯(Iluvatar,OW)預期將導入或運用 scale-up 技術以提升 AI 伺服器機櫃效能。
- 除了標準化的 PCIe 連接,多櫃 scale-up 也會加速中國本土光互連需求。
ECOC 2026:Scale-up 規模需求與拓撲(群益,2026-10-06)
來源 memo_ECOC2026_群益會後分享_20261006。
- 規模需求:為支援至少 3 兆參數(訪談另提 10T)的大模型,單櫃 72 顆 GPU 已不足,需要 576 顆(72×8)GPU 的 cluster;騰訊想串接 512 顆、華為想串接 384 顆,下一代 1,024 甚至 4,096 顆。ECOC 本屆主要議題即為 Scale-up 究竟用什麼方式實現。
- 拓撲:Google 將訓練與推論處理器分開,拓撲由 Torus 改用 Dragonfly 以大幅縮短延時(原文「Taurus」依脈絡為 Torus);OCS 約 95% 由 Google 使用,為最大 CSP 用戶(見 技術_OCS)。
- 銅的極限:200G per lane 銅線約僅能傳 2.5 公尺,400G 距離更減半;Broadcom Tomahawk 7 可串 1,024 顆 XPU、每顆 XPU 頻寬 25.6T,以 200G per lane 計算需 128 根光纖,整個 BiDi 光傳輸系統需 131,072 根光纖,光纖與連接器用量隨之暴增(見 技術_CPO光連接器)。
- 光進銅退:趨勢明確,Agent 上線後大型 scale-up 因應算力暴增為急迫需求;2026 年資料中心建置約 5-7 GW,2027 年更多。
- Optical Backplane 已在 OCP 提出。
投資觀察
- 2027 Rubin Ultra NVL576 是 scale-up 走光的重要驗證節點。
- 2028 Feynman / NVLink8 CPO 是 scale-up 真正光化的關鍵窗口。
- 對 技術_薄膜濾光片TFF 而言,不能把「scale-up 光化」直接等同於「DWDM TFF 放量」;要追蹤平台是否採少纖多波長,或改用多光纖 / on-chip WDM。
- 中國廠商 SuperPod 呈現「晶片製程受限、但系統整合(光網路、機櫃設計)具競爭力」格局,多家 ODM 展示相似或雷同設計,顯示差異化將更依賴互連效能、軟體最佳化與良率而非單純加速器數量。
- Scale-up 域規模是追蹤指標:從 64-128 卡(沐曦、燧原、阿里)→ 640(曙光)→ 1,024(華為已展示、壁仞 BR2xx)→ 8,192(華為宣稱),跨櫃門檻一被突破,光互連(先 NPO、後 CPO)就成為必要條件而非選項。
- NPO 先於 CPO:燧原與壁仞的下一代方案都選 NPO 而非 CPO,與 SemiAnalysis 對美系 Trainium4/Ascend 950 的判斷一致——首批把光用於 scale-up 的系統都先上 NPO 以降低量產風險。台股對應切入點見 技術_NPO「台股供應鏈」。
- PCIe 含量隨超節點分散化上升:MS 認為這是本輪 scale-up 擴散最直接的受惠處(retimer、PCIe switch、AEC)。
相關
- 技術_ESUN
- 技術_UALink
- 技術_MRC
- 技術_CPO
- 技術_CPC
- 技術_AEC
- 技術_Scale-out
- 技術_Scale-across
- 分析_TFF_DWDM與AI網路三種Scale關係_20260525
來源
- memo_ECOC2026_群益會後分享_20261006 — 群益投顧 ECOC 2026 會後分享,2026-10-06;scale-up 規模(576/1,024/4,096 顆)、Dragonfly 拓撲、200G 銅線 2.5 公尺極限、Tomahawk 7 光纖用量
-
報告_MS_AI網通_20260727 — Morgan Stanley(Ethan Jia/Charlie Chan/Daniel Yen/Daisy Dai/Tiffany Yeh),2026-07-27;「AI Networking: Scale-up Technology Enables China's AI Supernodes」;全球與中國 scale-up 互連技術對照表(Exhibit 4)、scale-up TAM(2024-29e CAGR 34%)、中美 AI 能力雷達圖、瀾起/海光/寒武紀/天數智芯個股意涵
-
產業_SEMICON2026矽光子論壇_Soitec簡報_20260831 — Soitec,2026-08-31;scale-up 2027 起轉光、2029 後全光機櫃的基板商口徑
- 報告_GS_AI光網路_20260417
- 分析_AI光互連百億美元押注_20260525
- 技術_CPO
- 技術_CPC
- 報告_MS_上海WAIC_20260721 — Morgan Stanley,2026-07-21;2026 上海 WAIC 展場觀察,中國 SuperPod 方案比較、P/D disaggregation