定義
DRAM-on-Logic(也稱 DoL 或 WoW DRAM)是將 DRAM 記憶體晶圓與邏輯 SoC 晶圓透過晶圓對晶圓(Wafer-on-Wafer,WoW)混合鍵合堆疊的技術。目標是在 AI 邊緣推論裝置中實現超高記憶體頻寬(~1 TB/s),同時降低功耗。
資料中心側同一架構被稱為 Memory-on-Logic(MoL):把 技術_客製HBM 的 custom base die 位置直接換成客戶的運算晶片,記憶體堆疊以 3D 疊在其上,中介層消失。兩者是同一技術譜系的兩端——邊緣端疊 LPDDR 上 AP/NPU,雲端端疊 DRAM 上 GPU/加速器。
與 HBM 的差異
| 比較維度 | DRAM-on-Logic(DoL) | HBM(High Bandwidth Memory) |
|---|---|---|
| 互連方式 | Cu-Cu W2W 鍵合(無中介層) | 微凸塊(micro bump)+ TSV |
| 頻寬 | ~1 TB/s | HBM3E:~1.2 TB/s |
| 目標平台 | 邊緣 AI(手機、車載、機器人) | 雲端 AI 加速器(GPU/NPU) |
| 封裝面積 | 更緊湊(直接鍵合) | 需要 2.5D 中介層 |
| 功耗 | 更低(短互連路徑) | 較高 |
| 成熟度 | 2028F 起(早期) | 目前量產 |
應用場景
AI 推論是記憶體頻寬受限(memory-bound)的工作,尤其在邊緣設備(智慧座艙、旗艦手機/PC、機器人): - 需要 45–100+ TOPS 算力,同時需要 高頻寬 + 低功耗 - DRAM-on-Logic WoW 可提供 1 TB/s 頻寬,支援 >100 TPS(每秒 token 數) - 傳統 LPDDR5:~200 GB/s,無法滿足 2028F 起的邊緣 AI 需求
技術架構
邏輯 SoC 晶圓(AP/NPU)
        ↓ Cu-Cu WoW 混合鍵合
DRAM 晶圓(LPDDR or 定製 DRAM)
關鍵製程: 1. DRAM 晶圓與 SoC 晶圓分別製造(DRAM 通常為 1X/1Y nm 節點) 2. 兩片晶圓透過 Cu-Cu W2W 鍵合堆疊,對準精度 <1µm 3. 鍵合後磨薄 + CMP + TSV 連接信號 4. 高 k 電容(DRAM cell 儲存)需要 ALD ZrO₂/HfO₂
圖解
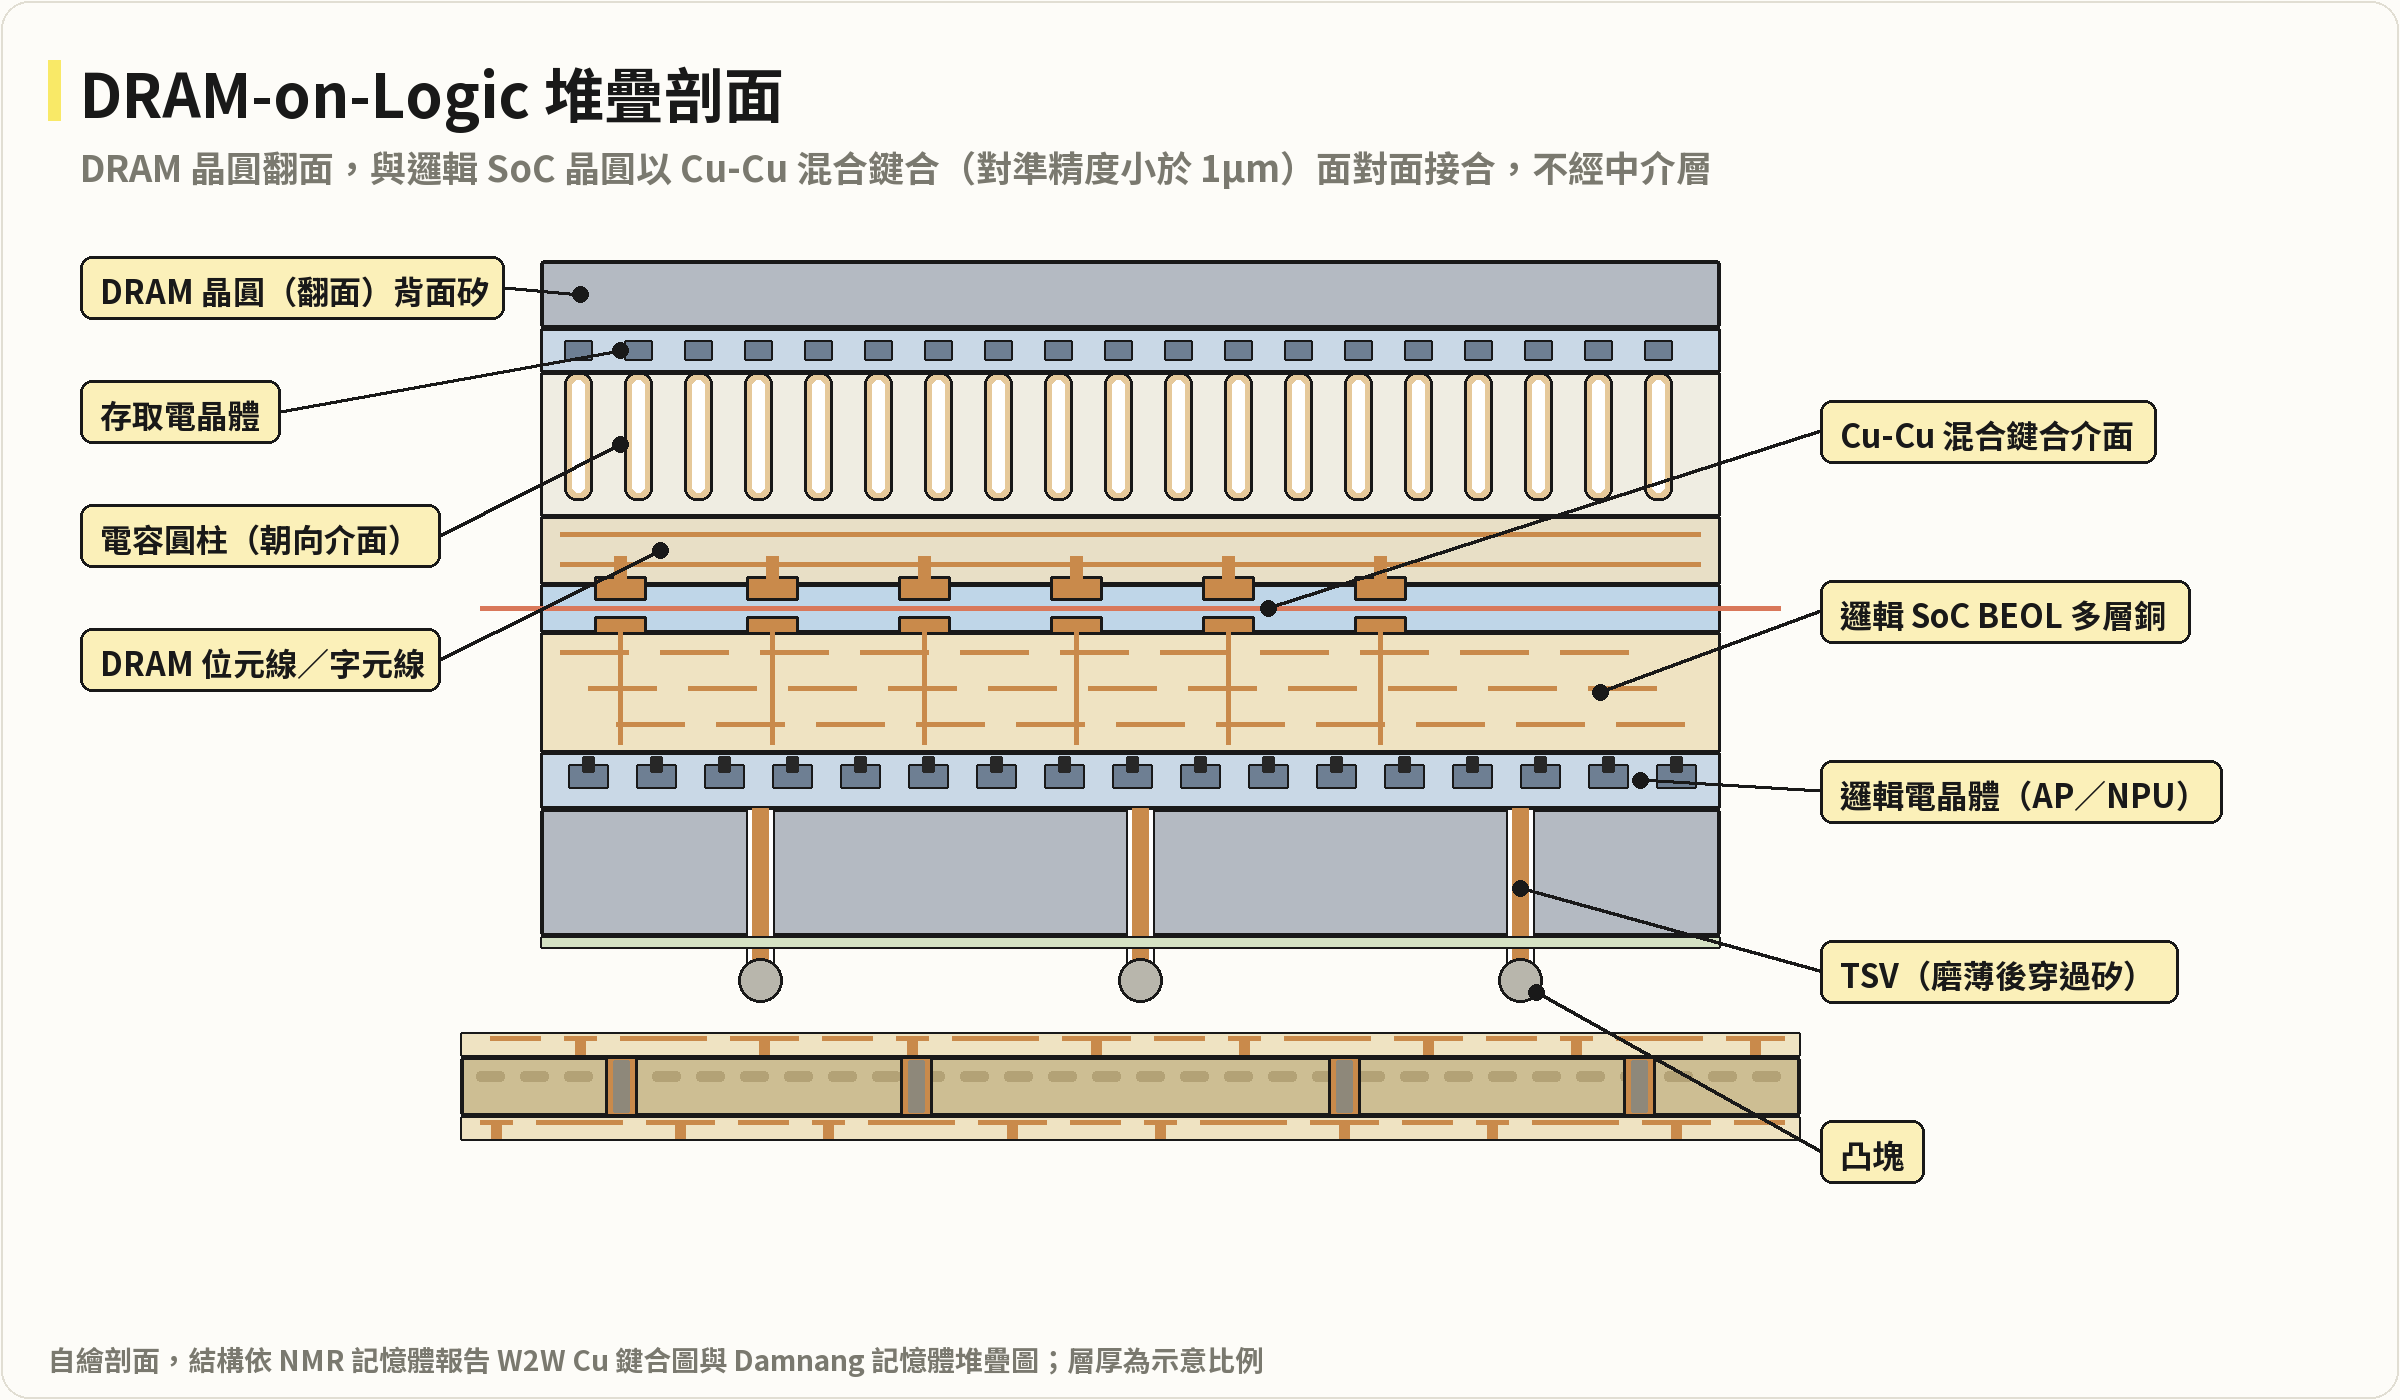
圖說:DRAM 晶圓翻面,電容層朝向介面,與邏輯 SoC 晶圓的 BEOL 銅 pad 以 Cu-Cu 混合鍵合面對面接合;邏輯晶圓磨薄後以 TSV 往下連到凸塊與載板。自繪剖面,結構依 NMR 記憶體報告 W2W Cu 鍵合圖與 Damnang 記憶體堆疊圖。
材料需求
| 材料 / 製程 | 需求 |
|---|---|
| 12" 矽晶圓 | 每個 SoC 需額外一片 DRAM 晶圓,用量增 |
| W2W 混合鍵合工具 | 新增製程設備(Besi、EVG、TEL) |
| ALD 高 k 電容介電(ZrO₂/HfO₂) | DRAM cell 的儲存電容 |
| CMP(鍵合前後平坦化) | 銅墊面平整度需 <1nm(RMS) |
| IGZO / 氧化物通道(未來) | 未來世代 DRAM cell 的通道材料 |
| Ru / Mo 互連金屬 | 更低電阻的細線互連 |
成長節奏(野村預估)
| 時間 | 里程碑 |
|---|---|
| 2025–27F | 技術驗證;小量樣品(Qualcomm、Apple、Google 等自研 SoC 廠商) |
| 2028F | 開始有意義的量產導入,AI 智慧座艙 + 旗艦手機 |
| 2029–30F | 擴散至機器人、工業邊緣 AI |
| CAGR >30%(2025–30F,從超低基期起) | 主要 2028F 後驅動 |
資料中心版:Memory-on-Logic(MoL)
演進順序是同一顆 base die 的三次身分轉換:base die 從 DRAM 製程轉邏輯製程(HBM4)→ 客戶邏輯搬進 base die(cHBM)→ base die 的位置直接被客戶的運算晶片取代(Memory-on-Logic)。
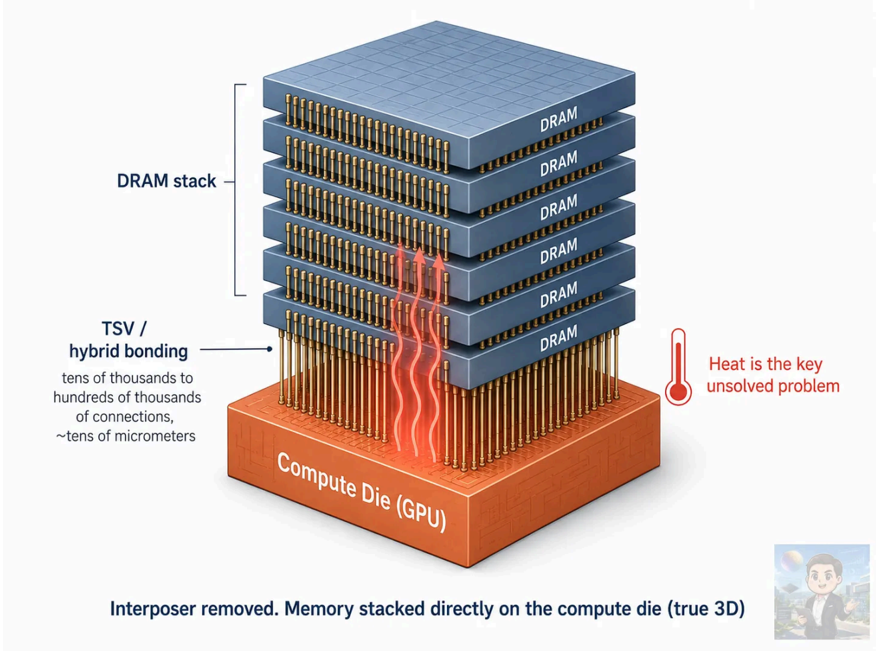
圖說:Memory-on-Logic 真 3D 結構——DRAM stack 直接疊在 Compute Die (GPU) 上,TSV/hybrid bonding 標註「數萬至數十萬個連接、約數十微米」;紅色熱流箭頭與溫度計標註 Heat is the key unsolved problem。底注:Interposer removed. Memory stacked directly on the compute die (true 3D)。來源:web_Damnang_記憶體客製晶片轉型_20260709 © Damnang
物理條件的改變:不再是 2048-bit 邊緣介面,而是連接點遍佈整個鍵合介面。TSV/混合鍵合把連接密度從數萬提升到數十萬,訊號傳輸距離從中介層佈線的毫米級縮到垂直方向的數十微米。喬治亞理工學院與 000660.KR(sk_hynix) 2025 年發表的論文分析一個 MoL 結構,可達 2.5D 架構的 64 倍吞吐量、3 倍能源效率(學術模型,不能直接外推,但足以說明量級方向)。
散熱是最關鍵的未解問題
把 DRAM 疊在功耗數百瓦的運算晶片之上,DRAM 同時阻擋運算晶片的散熱路徑又自身吸熱;DRAM 對溫度極敏感,高溫會縮短刷新週期並拉低效能。散熱能否解決,很可能直接決定 MoL 的成敗與時程。
cHBM 與 MoL 並非線性世代更替:未來數年 cHBM 是最現實的商業化路徑,MoL 屬更激進架構,需散熱與良率問題解決後才可能成為主流;兩者會依客戶的功耗預算、工作負載與封裝成本並行一段時間。
Qualcomm HBC:第一個公布時程的 MoL 產品
Qualcomm 於 2026 年 6 月投資人日發表 HBC(High Bandwidth Compute),屬 MoL 家族但有兩點關鍵差異:記憶體用 LPDDR 而非 HBM,堆疊下方是專用的近記憶體加速器而非 GPU 本身。
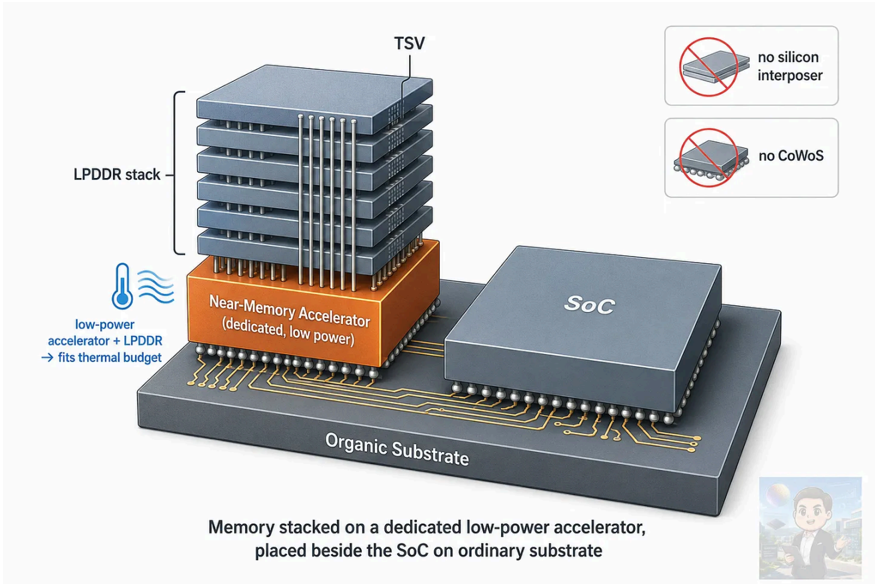
圖說:Qualcomm HBC 結構——LPDDR stack 以 TSV 疊在 Near-Memory Accelerator (dedicated, low power) 上,SoC 並排,兩者同置 Organic Substrate;右上兩個禁止符號標 no silicon interposer、no CoWoS;左標 low-power accelerator + LPDDR → fits thermal budget。來源:web_Damnang_記憶體客製晶片轉型_20260709 © Damnang
- 繞開兩個瓶頸:無矽中介層、不用 技術_CoWoS 等 2.5D 先進封裝,直接落在有機基板上——同時避開 HBM 供給短缺與先進封裝產能不足
- 散熱解法:不疊在發熱的 GPU 上,改用低功耗專用加速器+低功耗 LPDDR,讓整體落在熱預算內
- 廠商聲稱效能:每瓦頻寬為 HBM 的 6 倍,每瓦容量為片上 SRAM 的 200 倍(待白皮書與實機驗證)
- 時程:搭載第一代 HBC 的 AI250 加速器 2027 年中發表;第二代 HBC 在後續路線圖,AI300 2028 年送商用樣品
- 客戶動向:沙烏地阿拉伯 Humain 已將搭載 HBC Gen1 的 AI250 機架納入部署計畫;據報導微軟執行長 Nadella 亦表示將在 Azure 資料中心部署 Qualcomm HBC
其他 MoL 路線
| 廠商 | 方案 | 內容 |
|---|---|---|
| 000660.KR(sk_hynix) | HBM 直疊處理器 | 據報導自 2023 年起與含 NVDA.US(nvidia) 在內的數家 fabless 討論;提出以 2330_台積電(市) 晶圓鍵合技術將記憶體鍵合到邏輯晶圓的製造方式 |
| 3443_創意電子(市)(GUC) | DoL(DRAM-on-Logic) | 在邏輯層之上放置 1–4 層 DRAM;最上層是 LPDDR 或 HBM 式堆疊、最下層是專用加速器或 GPU 本身皆有可能 |
組織訊號:聖荷西數百人團隊(未經官方證實)
矽谷半導體業界傳出,一家韓國大型記憶體廠正在聖荷西組建數百人規模的 MoL 專責團隊。MoL 要求客戶運算晶片與記憶體堆疊從架構定義階段就協同設計,因此必須與客戶設計團隊同處一地(GPU 廠與超大規模業者的自研晶片團隊都集中在灣區);聖荷西人力成本高昂,承擔數百人招募=已有確定客戶專案的前期投資,而非探索性佈局。時點也吻合:cHBM 預計 2028 年前後上機,下一代往 MoL 過渡的協同設計必須提前 3–4 年啟動。 來源日期 2026-07-09,信心:中(媒體/業界傳聞,無官方公告,公司名未具名)。
台廠案例:補丁科 3D Stacked Near Memory
7947_補丁科(興)(南亞科持股約 35%)的 3D Stacked Near Memory 屬同一技術譜系,目標市場是 AI Inference 而非 Training(凱基投顧,2026-09-08,管理層說法):
- 架構:以 3D 堆疊加混合鍵合把記憶體堆疊與運算單元緊密整合;相較 HBM 以微凸塊互連,混合鍵合 pitch 可縮小逾一個數量級,I/O 數大增(頻寬約為 I/O 數×頻率)並改善能效。
- 產品:HiBaLL-M 以混合鍵合加 TSV 堆疊多層 DRAM 再與 SoC 3D 堆疊(拉高容量/密度);HiBaLL-S 以單層 DRAM 與 SoC 直接 3D 整合,約 2GB 容量可提供 >2TB/s 頻寬、能耗低於 0.5pJ/bit,延遲與能效接近 SRAM。
- KGD 是關鍵:單片晶圓良率 80% 時,未篩選修補的 4 層堆疊總良率約 41%(0.8⁴)、8 層約 16.7%,故需 KGD、Repair 與測試能力。
- 協同需求:完成專案需 AI 客戶、先進邏輯 Foundry、客製 DRAM Foundry(2408_南亞科技(市))與設計夥伴四方深度合作;專案自 2024 年洽談、2025 年進入設計,管理層預期 2027 年起陸續量產。
與上方 DoL/MoL 的差別:補丁方案以客製 DRAM 近記憶體對 Inference 的低延遲與能效為訴求,並與南亞科的 WoW 製程綁定;頻寬倍數與領先性均為公司說法,未經第三方驗證。
創意 DRAM on Compute 量化對照(OCP 2026,2026-10)
創意在 OCP 2026 簡報(報告_OCP2026_創意_AI運算記憶體連接擴展_20261015,2026-10,GUC 自述)給出 DRAM on Compute(即上表 DoL)與 6 顆 HBM4E 的量化對照:
| 項目 | DRAM on Compute | 6×HBM4E |
|---|---|---|
| 頻寬(全 reticle、四層) | 32 TB/s | 24 TB/s |
| 延遲 | 30 ns | 200 ns |
| 功耗 | 0.5 pJ/bit | 2.5 pJ/bit |
| 密度 | 110 MB/mm²(4 層) | 310 MB/mm²(12 層) |
- 混合鍵合 pitch 5–8 µm(HBM4E 約 20 µm);controller 與任何 DRAM 廠互通。
- 簡報自承成本與成熟度仍偏 HBM;密度比較是 4 層對 12 層,基準不同,為簡報原寫法。
- 無量產時程與客戶;3D 難點含 7.5 W/mm² 平均 TDP、功耗密度 5–10 W/mm²。
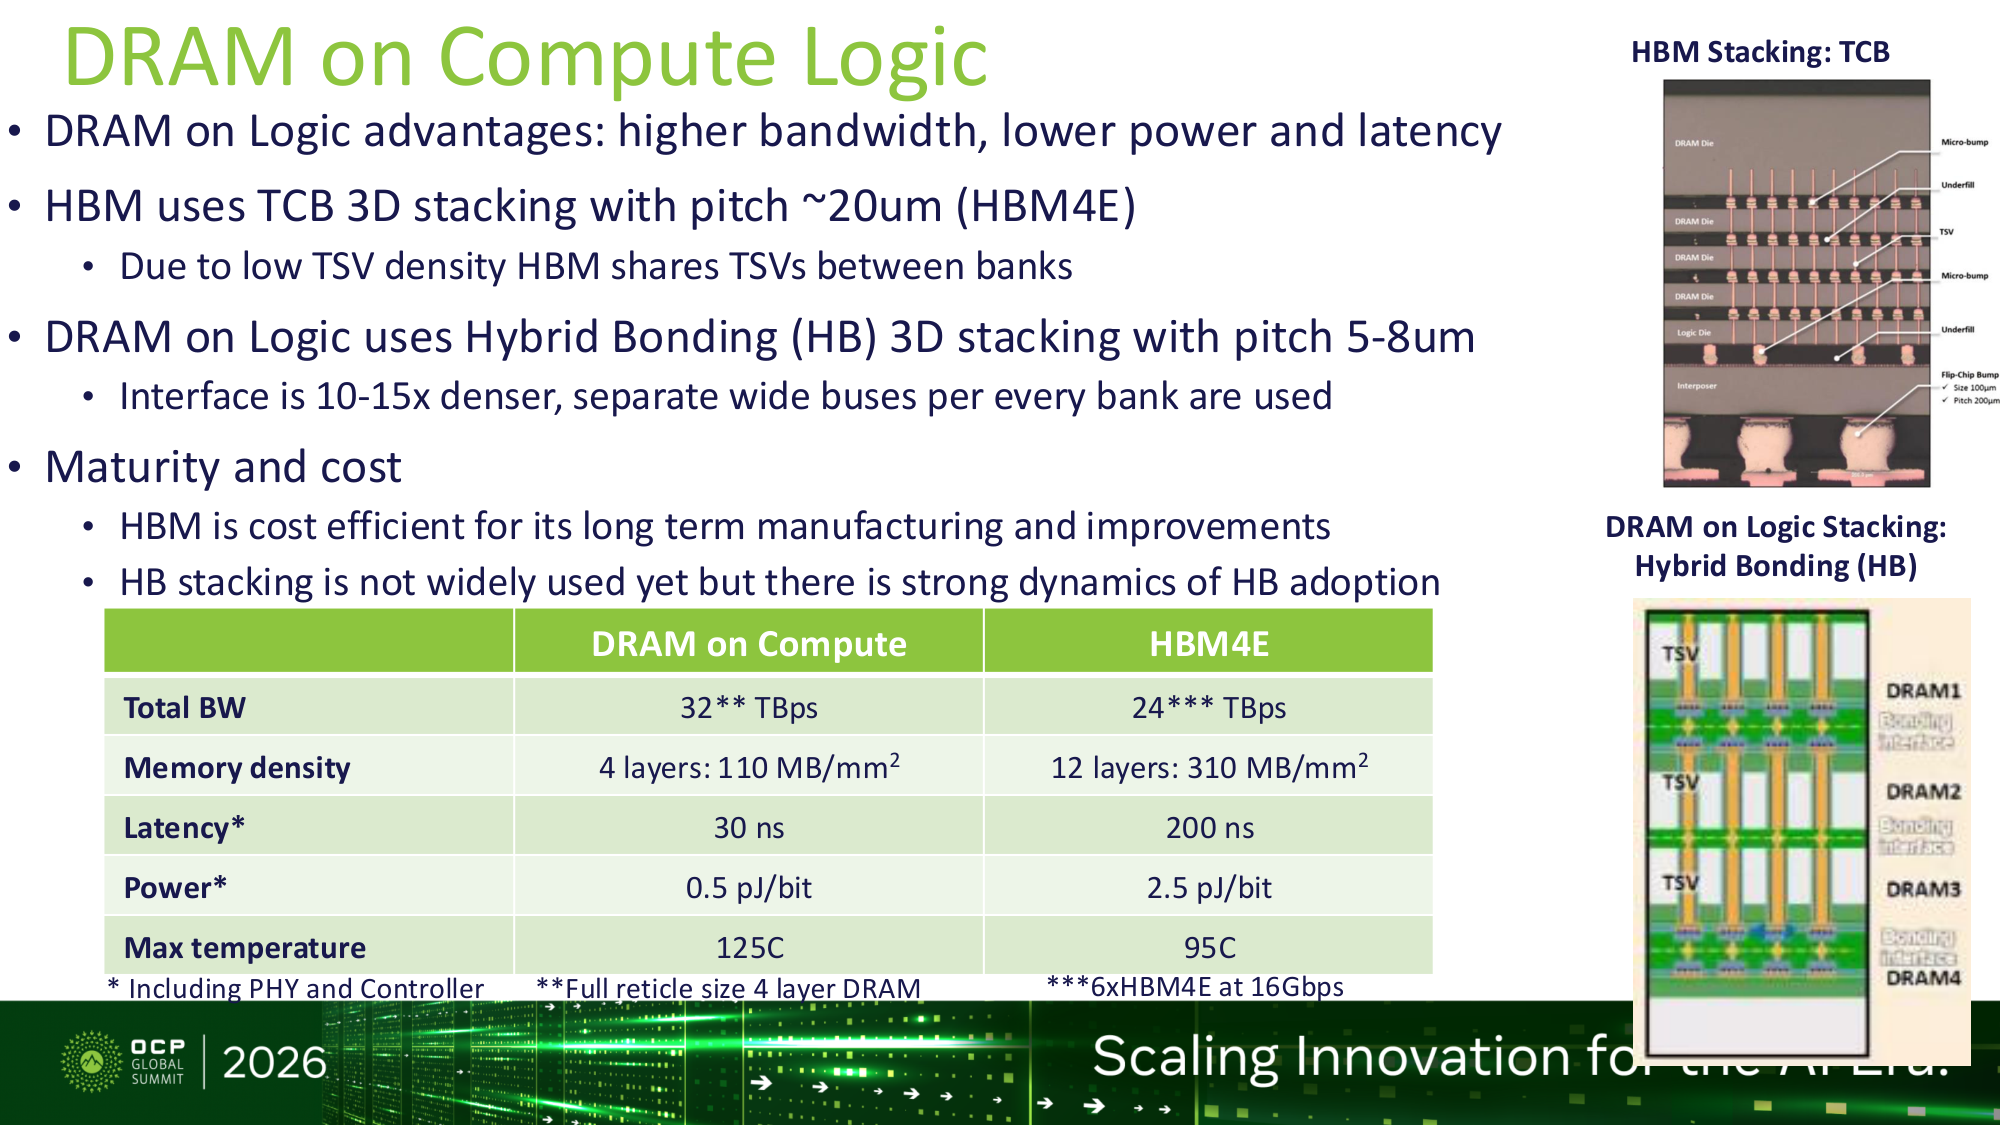
圖說(創意簡報 p8):DRAM on Compute 對 6×HBM4E 的頻寬、延遲、功耗與密度對照;來源 報告_OCP2026_創意_AI運算記憶體連接擴展_20261015。
重要限制
- 良率挑戰:兩片晶圓鍵合的任何一顆 DRAM die 壞掉,整個 SoC 報廢
- 客戶集中:初期只有旗艦等級 SoC 廠商(Apple、Qualcomm)有意願
- 成本:比傳統 LPDDR 方案貴很多,初期限高端市場
相關技術
- 技術_SoIC(同樣是 W2W 鍵合,但用於邏輯晶片而非記憶體)
- 技術_Wafer-bonded NAND(類似 W2W 鍵合架構)
- 技術_HBM(雲端 AI 的記憶體解法,目前主流)
- 技術_CMP(鍵合平坦化關鍵製程)
- 技術_3D堆疊SRAM(以 SRAM 疊在邏輯上的對照路線)
來源
- 報告_OCP2026_創意_AI運算記憶體連接擴展_20261015,創意電子(GUC)OCP 2026 簡報(2026-10-15;DRAM on Compute 量化對照)
- 260521_nmr_semi-renaissance,野村,2026-05-21(DRAM-on-Logic 架構、1 TB/s 頻寬、2028F 放量、邊緣 AI 應用場景)
- 報告_凱基_補丁科7947_20260908,凱基投顧,2026-09-08(補丁科 3D Stacked Near Memory/HiBaLL、KGD 良率算式、南亞科四方合作模式)
- web_Damnang_記憶體客製晶片轉型_20260709,Damnang(Substack),2026-07-09(Memory-on-Logic 定義與物理條件、喬治亞理工+SK hynix 64×/3× 論文、散熱為關鍵未解問題、Qualcomm HBC 與 AI250/AI300 時程、GUC DoL 1–4 層、聖荷西 MoL 團隊傳聞)