定義
MRC(Multipath Reliable Connection)是 OCP 發布的 AI 叢集乙太網路 RDMA 傳輸規格(OCP MSA,1.0 於 2026),把「一條連線固定走一條路徑、掉包就 go-back-N」改為逐封包噴灑到多路徑與多平面、選擇性重傳,使鏈路或交換器故障變成路徑選擇事件而非連線中斷。由 OpenAI 與 AMD、Broadcom、Intel、Microsoft、NVIDIA 共同制定,目標節點數 10^6。(報告_OCP2026_OpenAI_Broadcom_MRC多路徑可靠連線_20261015,2026-10)
本頁同時收錄與它並行的另外兩套 AI RDMA 傳輸:UEC/UET(Ultra Ethernet Consortium,clean slate 完整堆疊)與 MetaRoCE(Meta+AMD)。三者共同點是逐封包噴灑、亂序容忍與選擇性重傳;差異在範圍、網內功能與起點。
圖解
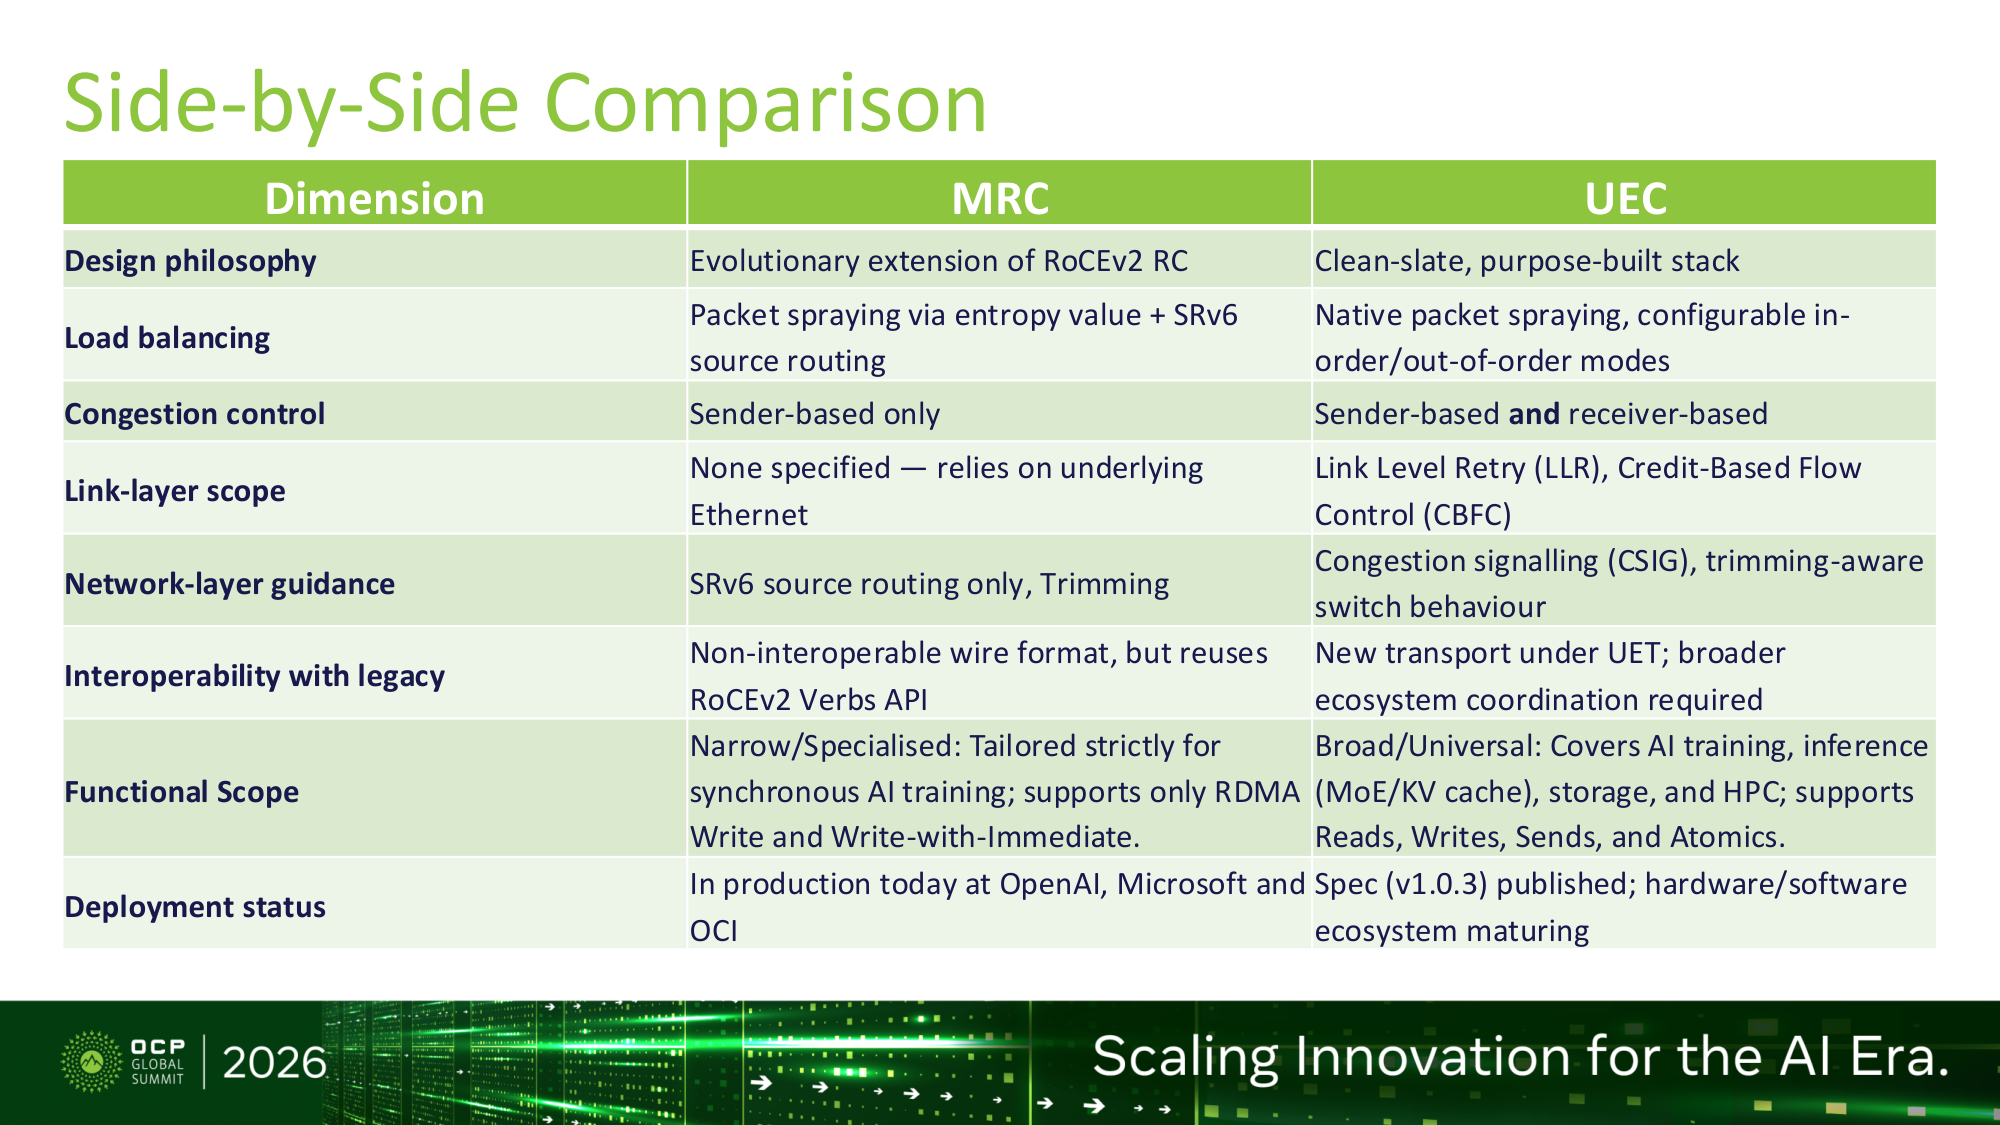
圖說:MRC 與 UEC 逐項比較表:設計哲學、負載平衡、壅塞控制(MRC 僅發送端;UEC 發送端加接收端)、鏈路層(UEC 有 LLR、CBFC)、功能範圍等。(報告_OCP2026_Broadcom_UEC與MRC比較_20261015,2026-10)
技術原理(MRC)
- 對應用保持 QP/CQ 與有序完成語意,亂序在 API 以下處理;封裝為 RoCEv2/UDP/IP、盡力而為乙太網。
- 逐封包 spray、受限 in-flight 狀態、SACK/NACK 選擇性重傳、可選 packet trim、probe。
- 路徑以 Entropy Value(EV)表示,可用隱含雜湊(每 QP 128–256 個 EV 分佈於 UDP source port 與 IPv6 flow label)或 SRv6 uSID 明確源路由;劣化路徑加入 denylist 重選,不等路由收斂。
- 每個封包帶虛擬位址與 remote key,亂序直接寫入;新 opcode 空間,與舊 RC 端點不互通,但沿用 Verbs 與 QP;僅支援 write 與 write-with-immediate(Broadcom 說法)。
- 壅塞控制:規格只標準化訊號(ECN、SACK 累計、網路 RTT、responder 背壓、反射 EV),演算法不強制。OpenAI 實作用 NSCC;Microsoft 實作用 SMaRTT+ReSS。
- API:mrc.h(應用)、mrc_ctl.h(特權控制器)。刻意不含接收端壅塞控制、鏈路層與 SRv6 以外的網路層規定。
(報告_OCP2026_OpenAI_Broadcom_MRC多路徑可靠連線_20261015、報告_OCP2026_Broadcom_UEC與MRC比較_20261015、報告_OCP2026_Microsoft_MRC_AI訓練RDMA傳輸_20261015,2026-10)
三套傳輸對照
| 維度 | MRC | UEC/UET | MetaRoCE |
|---|---|---|---|
| 組織 | OCP MSA;OpenAI 主導,AMD、Broadcom、Intel、Microsoft、NVIDIA 共同制定 | Ultra Ethernet Consortium,廣泛多廠商 | Meta 自家規格,AMD 實作;規格、參考軟體、合規測試套件開源 |
| 版本 | 1.0(2026) | 1.0(2025;Broadcom p15 標 v1.0.3) | 2026-08 公告、2026-10 開源 libsoftmetaroce、dpdkmetaroce |
| 起點 | 演進 RoCEv2,窄範圍 | clean slate,完整堆疊 | 重構 RoCEv2 |
| API | libibverbs(mrc.h) | libfabric 2.0;Verbs 於 1.1 加入 | 稱 full verbs 相容(指自身) |
| 語意 | write、write-with-immediate | Read、Write、Send、Atomics | verbs 完整相容 |
| 負載平衡 | 逐封包噴灑,EV/SRv6 明確路徑 | 逐封包噴灑 | 單一 QP 多路徑多串流,QWND=ΣPWND[p];ECN+ECMP |
| 壅塞控制 | 僅發送端(NSCC 等) | 發送端+接收端 credit;NSCC 或 RCCC | 逐路徑視窗 AIMD,接收端速率提示(RCN)加速 incast |
| 損失偵測 | SACK、NACK、逾時、可選 trimming | 同左,另有 LLR、CBFC | SACK;刻意不用 trimming |
| 網內功能 | 無(SRv6 外) | CSIG 網內遙測、可選 trimming、LLR、CBFC、端到端加密 | 無;交換器不需修改 |
| 目標 | AI 訓練 | AI+HPC+儲存 | 網路效率 >90%;設計目標一百萬加速器 |
(報告_OCP2026_MRC與UET專家座談_20261015、報告_OCP2026_Broadcom_UEC與MRC比較_20261015、報告_OCP2026_Meta_AMD_MetaRoCE_20261015,2026-10)
陣營
- MRC:OpenAI、Microsoft(正式環境使用者);AMD、Broadcom、Intel、NVIDIA 為規格共同制定方(logo 層級)。Broadcom 比較簡報另列 OCI 量產,僅此單一來源,不寫入結論。
- UEC:Broadcom、HPE、Arista 等講者出席;ESUN 借用其 LLR、CBFC,SUE-T 借用其 SES+RODL(見 技術_ESUN)。
- MetaRoCE:Meta 與 AMD(Pensando 可程式 AI NIC 已支援),NVIDIA 在 Meta 全端簡報中為「洽談中」。AMD Vulcano 800 AI NIC 支援 RoCEv2、MRC、MetaRoCE、UEC。(報告_OCP2026_AMD_HPE_開放標準AI機櫃_20261015,2026-10)
口徑差異(並列保留)
- 壓控演算法:座談表稱 MRC 用 NSCC;Microsoft 場稱其互通 L2 要 SMaRTT+ReSS。判讀為規格標準化訊號、演算法屬實作差異,並非矛盾。
- 語意範圍:Broadcom 稱 MRC 僅支援 write 與 write-with-immediate;MetaRoCE 稱 full verb compatibility(指自身);Microsoft 呼籲規格擴到 write 以外。三者範圍本就不同。
- UEC 版本:Broadcom p4 寫 v1.0(2025),p15 寫 v1.0.3,可能為勘誤版。
部署與實測
- OpenAI 正式環境:75K GPU 訓練作業,T1 交換器完全停轉,約 25% QP 受影響、約 580K 封包遺失;吞吐由約 12.5 Pb/s 下探約 10.5 Pb/s,約 1 分鐘內恢復(讀圖估計)。(報告_OCP2026_OpenAI_Broadcom_MRC多路徑可靠連線_20261015,2026-10)
- Microsoft Cluster A:GB200 叢集 50K 與 75K GPU 訓練;ConnectX-8 每 NIC 800Gb/s 拆 4×200G 平面;兩層 Clos(T0/T1);交換器混用 NVIDIA Spectrum-4 與 Broadcom Tomahawk-5;T0–T1 link flap 頻繁但對作業影響可忽略。前身為 Fungible FCP(fabric 延遲 99p 10.5µs、99.9p 13µs)。(報告_OCP2026_Microsoft_MRC_AI訓練RDMA傳輸_20261015,2026-10)
- 兩場都是 75K GPU,但簡報未明言是否同一叢集。
- MetaRoCE:64 GPU 對比 RoCEv2,All Reduce 完成時間多數減 5%–27%;All To All 小訊息減 15%–28%,部分大訊息反增約 5%–20%(讀圖估計)。8×100G 多平面下單平面失效,吞吐約 780→680Gbps、約 65 秒回復。(報告_OCP2026_Meta_AMD_MetaRoCE_20261015,2026-10)
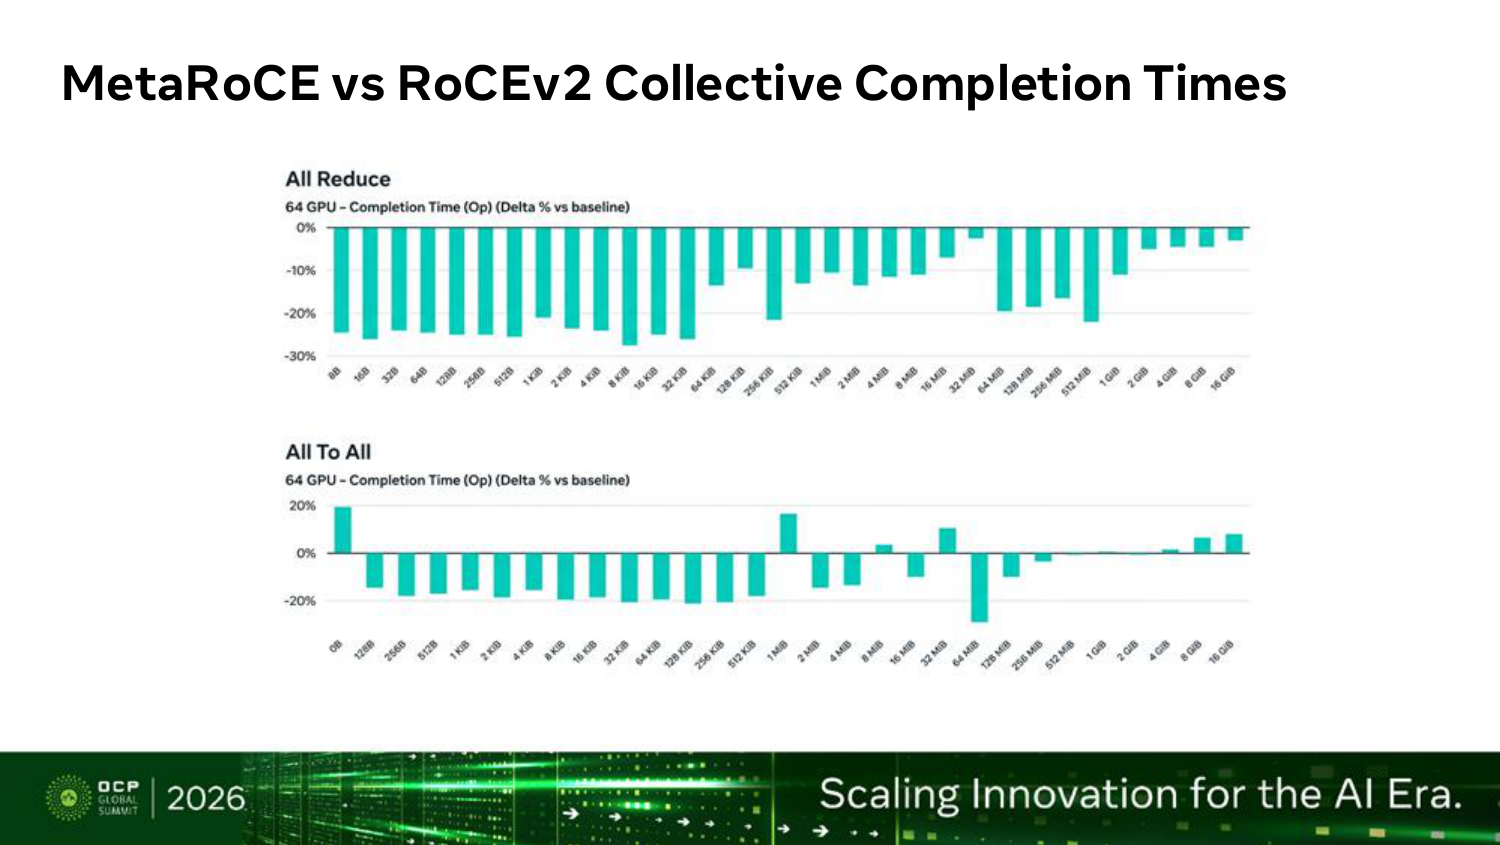
圖說:MetaRoCE 與 RoCEv2 在 64 GPU 的集合通訊完成時間差異(相對 baseline),All Reduce 多數訊息大小約減 5%~27%,All To All 小訊息約減 15~28%,少數大訊息反增(讀圖估計)。(報告_OCP2026_Meta_AMD_MetaRoCE_20261015,2026-10)
互通性缺口
Microsoft 指出 MRC 規格有三處缺口:保留位元定義不清(有人用於 plane health)、可靠性與重傳行為未定義、RTT 量測來源未定。互通分三級:L1 標頭一致;L2 加 SMaRTT、ReSS、禁 Go-Back-N、RTO;L3 再加窗口增減速率與故障反應時間一致,完整互通需 L3。行動呼籲為建立共識、共用互通實驗室、辦跨廠商 plugfest(無日期)。MRC 與 UEC 的互通性、與 NVIDIA Spectrum-X 的關係,簡報均無明確結論。(報告_OCP2026_Microsoft_MRC_AI訓練RDMA傳輸_20261015,2026-10)
Scale-out 與 Scale-across 並用(MetaRoCE)
MetaRoCE 同時涵蓋兩個尺度:scale-out RTT 5–15µs、Max Cwnd 約 75、Max Path 約 12;scale-across RTT 常達毫秒(50–100 倍)、Max Cwnd 3,500–7,000、Max Path 約 30–50(4K MTU),圖示遠端站 RTT 1.5ms。(報告_OCP2026_Meta_AMD_MetaRoCE_20261015,2026-10)
技術瓶頸/風險
- 三套傳輸並行,互通與認證尚未完成,多廠商 NIC/交換器混用時需 L3 級對齊。
- MRC 是 NIC/交換晶片層協定,直接受惠者是 Broadcom、NVIDIA、AMD 等晶片商,台股為間接。
- 簡報均為廠商或雲端自述,部分數值為讀圖估計。
關鍵廠商
| 環節 | 廠商 | 角色 |
|---|---|---|
| 規格發起與使用 | OpenAI、MSFT.US(microsoft) | MRC 共同提案與正式環境 |
| 晶片 | AVGO.US(broadcom) | MRC 共同制定方、UEC 成員;Tomahawk-5 於 Microsoft 叢集 |
| 晶片 | NVDA.US(nvidia) | ConnectX-8、Spectrum-4 於 Microsoft 叢集;MRC 共同制定方;MetaRoCE 洽談中 |
| NIC | AMD.US(amd) | Pensando AI NIC 支援 MetaRoCE、MRC、UEC |
| 自研規格 | META.US(meta_platforms) | MetaRoCE |
相關技術
來源
- 報告_OCP2026_OpenAI_Broadcom_MRC多路徑可靠連線_20261015 — 2026-10
- 報告_OCP2026_Broadcom_UEC與MRC比較_20261015 — 2026-10
- 報告_OCP2026_Microsoft_MRC_AI訓練RDMA傳輸_20261015 — 2026-10
- 報告_OCP2026_MRC與UET專家座談_20261015 — 2026-10
- 報告_OCP2026_Meta_AMD_MetaRoCE_20261015 — 2026-10
- 報告_OCP2026_AMD_HPE_開放標準AI機櫃_20261015 — 2026-10