PDF 原檔:報告_凱基_電子硬體產業_20260930_original.pdf
圖片清單(已驗證 2026-10-03)
≥40KB 候選逐張 Read;<40KB 未讀。
| 檔名 | size | 分類 | 親眼所見內容 |
|---|---|---|---|
報告_凱基_電子硬體產業_20260930_002.png |
45KB | 真資料圖 | 圖3:TPU 8i Boardfly 分層拓撲:左 4 顆 TPU 全互連為 building block(BB),中 8 個全互連 tray/BB 成一個 group(BB-BB 以 Cu links 連接),右 36 個 group(G)全互連 |
報告_凱基_電子硬體產業_20260930_010.png |
315KB | 真資料圖 | 圖12:TPU v8 tray 俯視:紅色主板上標示 4× Power(液冷)、4× TPU ASIC(液冷)、4× Transceiver/Optics(液冷),底部註記 4 Power + 4 ASIC + 4 Optics = 12 cold plates / tray |
報告_凱基_電子硬體產業_20260930_013.png |
737KB | 真資料圖 | 圖15:TPU 機櫃正面雙櫃照片,紅框標示頂部兩排 BBU 與下方 Power shelf(左右各一組) |
報告_凱基_電子硬體產業_20260930_020.png |
570KB | 真資料圖 | 圖23:Google TPU 供應鏈關鍵零組件與台廠布局圖:ODM(鴻海、英業達、Celestica)、晶片(聯發科、Broadcom)、散熱(奇鋐、富世達、健策;Cooler Master、BOYD、Furukawa)、電源(台達電、光寶、Flex)、PCB/CCL/載板(金像電、台光電、金居、欣興)、網通光通訊(聯亞、光聖、Lumentum)、CoWoS(台積電)、測試(京元電、日月光) |
報告_凱基_電子硬體產業_20260930_001.png |
56KB | 真資料圖 | 圖2:TPU 8t 的 Virgo Network 與 Jupiter Network:左 Virgo 2-layer switching(fully non-blocking、redundant fabric、可擴展至多資料中心),右 Jupiter 含 Optical Circuit Switch 與 aggregation blocks;影像模糊,僅輪廓可辨 |
報告_凱基_電子硬體產業_20260930_003.png |
55KB | 真資料圖 | 圖4:Google 投影片「TPU 8t: The Training Powerhouse」:8t Superpod 2PB Memory、9,600 Chips;121 Exaflops(3x over Ironwood)、Native FP4、2x Perf-per-Watt;晶片 2.4 TBps I/O BW per chip |
報告_凱基_電子硬體產業_20260930_004.png |
96KB | 真資料圖 | 圖5:Google 投影片「TPU 8i: The Low-latency Inference Powerhouse」:384MB SRAM(2.4x prior gen)、288GB HBM(12-Hi HBM3E stacks)、ICI 19.2Tb/sec(2x);SRAM vs HBM 頻寬約 150-200 TB/s vs 10-15 TB/s、存取延遲 1-2ns vs 150-200ns |
報告_凱基_電子硬體產業_20260930_005.png |
299KB | 真資料圖 | 圖6:TPU 需求結構圖:Google 自用(Gemini 等全生命週期、Training/Post-training/Inference,AI 工作負載趨勢:更大模型規模、MoE、長 Context、Agentic AI)與外部雲端客戶(Anthropic:2025 年最高 100 萬顆 TPU、超過 1GW;2026 年 4 月與 Google、Broadcom 簽 TPU v8 數 GW,2027 年上線,支援 Claude) |
報告_凱基_電子硬體產業_20260930_006.png |
78KB | 真資料圖 | 圖8:TPU 8i tray 實體照片,投影片標題 Specialized engine for real time inference,板上 4 顆 TPU 與前端 4 組散熱模組 |
報告_凱基_電子硬體產業_20260930_007.png |
89KB | 真資料圖 | 圖9:TPU 8t tray 實體照片,投影片標題 Powerhouse for pretraining throughput,4 顆 TPU 與前端散熱模組 |
報告_凱基_電子硬體產業_20260930_008.png |
184KB | 真資料圖 | 圖10:TPU v7 機櫃示意:標示 Power In、DCN Uplinks、Optical inter-rack ICI、CPU Host、TPU、Copper Intra-rack ICI Interconnects、Liquid cooling/Heat Out |
報告_凱基_電子硬體產業_20260930_009.png |
198KB | 真資料圖 | 圖11:TPU v7 機櫃背面照片與標註:Upper drip pan、ToR、Rack Monitoring Tray、416V AC Input & AC/DC Rectifiers、Optical Patch Panels、TPU Tray、Host Tray、Cable Managers、ICI Optical Fiber、ICI Copper cables、PCIe Cable、Liquid manifolds、Battery Backup Unit |
報告_凱基_電子硬體產業_20260930_011.png |
305KB | 真資料圖 | 圖13:TPU 機櫃群正面照片(雙櫃、多層 tray 與大量光纖/線纜佈線),無文字標註 |
報告_凱基_電子硬體產業_20260930_012.png |
528KB | 真資料圖 | 圖14:液冷機櫃側面照片:不鏽鋼冷卻管路、快接頭與分歧管、每層 tray 水管,右側 CDU 面板與顯示螢幕 |
報告_凱基_電子硬體產業_20260930_016.png |
263KB | 真資料圖 | 圖19:MEMS 式 OCS 光路結構:光纖準直陣列(輸入端口)→ 雙軸 MEMS 傾斜反射鏡陣列 ×2 → 光纖準直陣列(輸出端口),紅綠光束示意 |
報告_凱基_電子硬體產業_20260930_017.png |
384KB | 真資料圖 | 圖20:Lumentum R300 Optical Circuit Switch 產品照(機箱前面板大量藍色光纖埠) |
報告_凱基_電子硬體產業_20260930_014.png |
18KB | 未 Read | <40KB:圖16/17 PCB 相關小圖,預設不讀 |
報告_凱基_電子硬體產業_20260930_015.png |
12KB | 未 Read | <40KB:圖17 TPU v8 PCB 小圖,預設不讀 |
報告_凱基_電子硬體產業_20260930_018.png |
26KB | 未 Read | <40KB:圖21 TPU ASIC 出貨顆數圖(2026 約 402 萬、2027 約 910 萬,數字已在內文) |
報告_凱基_電子硬體產業_20260930_019.png |
38KB | 未 Read | <40KB:圖22 TPU 供應鏈公司 2027 年營收占比圖(數字已在內文) |
原始內容
KGI
焦點內容
- Google (美) TPU v8首次分為8t與 8i 兩套針對不同工作負荷量最佳化的架 構,預計 4Q26 於硬體供應鏈進入量產 階段,將對 2027 年增添 AI 伺服器市場 硬體供應鏈動能
- TPU v8 機櫃設計雖分化為 8t/8i,但多 半為 v7 之延伸,放量嘉惠規格升即之 散熱、電源、PCB/CCL、載板與光通 OCS 業者。
- 2027 年將是 Google TPU 明顯放量 年,從晶片量的角度,預期TPU v8 出 貨量將由 2026年之約 402 萬顆增至 2027年之約 910 萬顆 (年增126%), v8機櫃總出貨量可望翻倍,將同步拉動 TPU晶片、ODM、散熱、電源、PCB/CCL 與光通訊需求。 主要受惠廠商且營收貢 獻度達10%以上之公司包括: 晶片設計 商聯發科(2454 TT)、主要L10/L11 系統組裝商 Celestica(CLS US)、電 源廠商台達電(2308 TT)、 ABF載板 供應商欣興(3037 TT)、CCL供應商 台光電(2383 TT)、PCB業者金像電 (2368 TT)、水冷板新進廠商奇鋐 (3017 TT)、 HVLP4 銅箔供應商金居 (8358 TT)。
凱基投顧
向子慧
886 2 2181 8726 angelah@kgi.com
林祐熙
886 2 2181 8725 jacklin.lin@kgi.com
涂憶君
886 2 2181 8742 esther.ic.tu@kgi.com
李承泰
886 2 2181 8729
terry.lee@kgi.com
余昀澄
886 2 2181 8013 alex.a.yu@kgi.com
重要免責聲明,詳見最終頁
電子硬體產業
TPU v8放量出貨,推升2027年 AI成長動能
重要訊息
Google (美) TPU v8預計4Q26於硬體供應鏈進入量產階段,將增添2027 年AI伺服器市場硬體供應鏈動能。
評論及分析
Google TPU v8首次分為8t與 8i兩套針對不同工作負荷量最佳化的架 構,預計4Q26於硬體供應鏈進入量產階段。Google TPU 已進入第八代 (v8),與前一代 TPU v7 (Ironwood) 同時承擔訓練與推論不同,TPU v8 首 次明確分化為 TPU 8t (Zebrafish) 與 TPU 8i (Sunfish)兩套針對不同工作負 荷量 (workload) 最佳化的架構。其中 TPU 8t(Training)定位大型模型 pre-training 與 embedding-heavy workload,延續 3D Torus scale-up 架 構,單一 Superpod 可擴展至 9,600 顆 TPU;而TPU 8i(Inference)則 鎖定 post-training、sampling、real-time inference 與 reasoning,導入全 新的晶片間互連 Boardfly inter-chip interconnect (ICI) topology,單一 pod 最多可配置 1,152 顆、其中最高 1,024 顆 active TPU。TPU 的需求來源 可分成 Google內部需求與外部雲端客戶兩大部分。內部需求主要來自 Google DeepMind 與 Google 自有 AI 服務,包括 Gemini 等 frontier models 的 training、post-training 與 inference;至於外部需求中,目前 最重要且公開規模最大的客戶之一為 Anthropic (US),2025 年 Anthropic 宣布擴大 Google Cloud TPU 使用規模至最高 100 萬顆 TPU、超過 1GW 產 能,於 2026 年陸續上線;而於2026 年 4 月更進一步宣布與 Google、 Broadcom 簽訂新的合作協議,取得數GW (multiple gigawatts) 的下一世 代TPU產能 (TPU v8),預計 2027 年開始上線,主要支援 Claude frontier 模型。
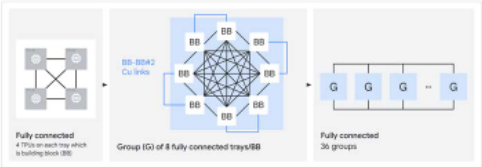
v8 機櫃設計雖分化為 8t/8i,但多半為v7之延伸。8t延續適合大型 training的3D Torus架構,但晶片間互連頻寬 (Inter-chip interconnect (ICI) bandwidth) 較前代提高2倍,並新增Virgo scale-out network,8i則改 採全新的Boardfly topology,每個tray以 4顆TPU形成building block, 8個board組成32-chip group,再由36個group透過OCS互連,形成 最多1,152顆physical TPU、最高1,024顆active TPU的pod。依目前供 應鏈資訊,v8 每層 L6 板子上除了 TPU 之外,還進一步整合 Power 與高速 Transceiver/Optics,並導入 Google 第四代(Gen4)液冷;因此 v8 機櫃 升級的核心已不只是 TPU 晶片效能提升,而是從運算、記憶體、網通、 電源、散熱與光通訊全面進入系統級之設計。目前主要 L10/L11 組裝廠商 仍為Celestica (美),鴻海(2317 TT, NT$251.5, 增加持股)繼v7組裝CPU 層與機櫃後,於v8增加TPU層與L11機櫃之組裝份額,而英業達(2356 TT, NT$59.5, 持有)則主要供應TPU之L6為主,亦將有機會擴及系統。
v8放量嘉惠規格升即之散熱、電源、PCB/CCL、載板與光通OCS業者。
水冷設計: TPU v8由晶片液冷升級至系統級液冷,CDU容量與液冷零組件 同步升級,市場資訊顯示由v7約 1.4MW升至v8t約2MW,並擴大 Manifold、QD、Tubing等液冷零組件需求,我們預估單櫃水冷價值(未
KGI
含CDU)估約4.5-5萬美元;8t水冷板主要供應商為奇鋐 (3017 TT, NT$3,435, 增加持股)、古河(日),8i則以Cooler Master(台)、Boyd(美)為 主。
電源方面: v8進入10kW PSU,並開始導入HVDC,單櫃電源價值明顯提 高,v8在50V架構下預估採3排Power shelf,每個含 6個10kW PSU, 相較v7的5.5k升規,PSU單櫃價值由約2萬美金增至2.8-3萬美金 (提 升40-50%),並開始相容±400V DC,主要受惠供應商為台達電 (2308 TT, NT$1,890, 增加持股),其次為Flex (美)、光寶科 (2301 TT, NT$279.5, 增 加持股)。
PCB/CCL/載板方面: v8同時受惠面積、層數、材料三重升級,ABF載 板由 v7 約 80-85mm/16L 放大至 v8 約 90-100mm/18-22L,估 ASP 提升40-50%,主要受惠欣興(載板)(3037 TT, NT$1,175, 增加持股); 新一代 v8t、v8i主板34-40 層,CCL 材料升級至 M8+ 等級並搭配 HVLP4 銅箔,使CCL/PCB平均售價增加70%-80%,主要受惠台光電(CCL)(2383 TT, NT$4,935, 增加持股)、金像電(PCB)(2368 TT, NT$1,120, 增加持股) 與 金居 (8358 TT, NT$495, 未評等)(HVLP銅箔)。
光通訊方面: 8t為Scale、8i為Latency的網路分流,帶動Optics/Fiber /OCS需求。8t維持3D Torus並新增Virgo scale-out,我們預估Optical Attach Rate最高可由v7的1.5提升至2.0/TPU(+33%),8i則以Boardfly 將最大network diameter由16降至7 hops、attach rate約1.25;TPU 放量仍將擴大光模組、MPO/高密度光纖與 OCS 需求,主要供應鏈包括 Lumentum(OCS)、光聖 (6442 TT, NT$1,490 未評等)(光纖/配線、 Scale-out)、聯亞 (3081 TT, NT$2,695, 未評等)/華星光 (4979 TT, NT$569, 未評等)/光環 ( 3234 TT, NT$173, 未評等)/聯鈞 (3450 TT, NT$523, 未評等)(LD相關)及全新 (2455 TT, NT$552, 未評等)/環宇-KY (4911 TT, NT$488, 未評等)(PD相關)。
投資建議
2027 年將是 Google TPU 明顯放量年,從晶片量的角度,預期TPU v8 出貨 量將由 2026年之約 402 萬顆增至 2027年之約 910 萬顆 (年增126%),其 中由聯發科設開發之 v8t 晶片量預計約為 360 萬顆,Broadcom 開發之 v8i 晶 片量預期約為550萬顆,v8機櫃總出貨量可望翻倍成長,將同步拉動 TPU晶 片、ODM、散熱、電源、PCB/CCL 與光通訊需求。相關受惠廠商包括: 晶片 設計商聯發科(2454 TT, NT$4,920 增加持股,TPU v8t ASIC,2027年營收 貢獻約40%)、Broadcom (美, TPU v8i ASIC,約45%)、主要L10/L11系統 組裝商 Celestica(CLS US,25-30%)、電源廠商 (Power Shelf/PSU/±400V HVDC) 台達電(2308 TT)(20-25%)、CCL供應商台光電(2383 TT,市佔率 70%)(20-25%)、PCB業者金像電(2368 TT,15-20%)、水冷板新進廠商 奇鋐(3017 TT,10-15%)、 HVLP4 銅箔供應商金居(8358 TT,5-10%), 其他營收貢獻較不顯著之供應商 (小於10%)尚有鴻海(2317 TT,TPU層與 L11機櫃 ODM)、英業達(2356 TT,L6 組裝)、健策(3653 TT,stiffener)、 富世達(6805 TT, NT$2,455, 增加持股,液冷零組件QD)、ABF載板供應欣 興(3037 TT)與光寶(2301 TT,PSU)。此外,光通訊相關業者應屬TPU需 求上揚之最大受惠族群,TPU 相關營收貢獻 2027 年皆有雙位數以上,包括聯 亞(3081 TT,LD)、光聖(光纖/配線與Scale-out)及 Lumentum(LITE US, OCS)皆為主要受益廠商。
投資風險
晶片供應順暢度;組裝與零組件瓶頸。
KGI
TPU v8晶片設計與迭代時程
Google TPU 已進入第八代,與前一代 TPU v7 (Ironwood) 同時承擔訓練 與推論不同,TPU v8 首次明確分化為 TPU 8t (Zebrafish) 與 TPU 8i (Sunfish) 兩套針對不同 workload 最佳化的架構。其中 TPU 8t(Training) 定位大型模型 pre-training 與 embedding-heavy workload,延續 3D Torus scale-up 架構,單一 Superpod 可擴展至 9,600 顆 TPU,並加入原生 FP4、 SparseCore、Virgo scale-out network 等設計;而TPU 8i(Inference)則 鎖定 post-training、sampling、real-time inference 與 reasoning,導入 384MB on-chip SRAM、Collectives Acceleration Engine(CAE)及全新 的 Boardfly ICI topology,單一 pod 最多可配置 1,152 顆、其中最高 1,024 顆 active TPU。Google 於 2026 年 4 月 Cloud Next 正式公布 TPU 8t/8i, 兩者預計於 2026 年陸續提供 Cloud 客戶使用;這代表 Google TPU 的發 展已從單純追求算力提升,進一步走向訓練 / 推論架構分流與工作負載特 定最佳化( workload-specific optimization)。
| 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - Year | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2023 - v5e | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2023 - v5p | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2024 - v6e | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2025 - v7x | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2026 - v8t | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2026 - v8i | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2027F - v8px | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2028F - v9 | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2028F - v9 | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2029F - v10 | 圖 1:TPU v8系列受memory wall限制,將其分為訓練(v8t)與推論(v8i)系列 - 2029F - v10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 晶片版本 | Viperlite | Viperfish | Ghostlite | Iroodwood | Zebrafish (A5921) | Sunfish | Whalefish (Upgraded Sunfish) | Humufish | Triggerfish (A5922) | Merope | Icefish |
| ASIC 合作夥伴 | Broadcom | Broadcom | Broadcom | Broadcom | 聯發科Broadcom | Broadcom | 聯發科 | 聯發科Broadcom/Marvell? | 聯發科 | ||
| 製成節點 | 台積電 N5 | 台積電 N5 | 台積電 N4 | 台積電 N3 | 台積電 N3 | 台積電 N3 | 台積電 N3 | 台積電 N3/N2 | 台積電 N3/N2 | 台積電 N2 | 台積電 N2 |
| 記憶體世代 | HBM2E | HBM3 | HBM3 | HBM3E | HBM3E | HBM3E | HBM4E | HBM4 | HBM4E | HBM4E/HBM5? | HBM4E/HBM5? |
| 記憶體容量 | 16GB | 95GB | 32GB | 192GB | 216GB | 288GB | 576GB? | 288GB | ? | ? | 768GB? |
| 2.5D 封裝 | CoWoS-S | CoWoS-S | CoWoS-S | CoWoS-S | CoWoS-S | CoWoS-S | CoWoS-S | EMIB-T | EMIB-T | CoWoS-L | EMIB-T |
| 混和鍵合/SoIC | N | N | N | N | N | N | N | N | N | Y? | ? |
資料來源:凱基
圖2:TPU 8t 機架級至 Virgo Fabric 的連接
資料來源:Google;凱基
圖 3:TPU 8i 採用分層 Boardfly 拓撲結構:以四個全互連晶 片構成的單元為基礎,組成全互連的八板集群;再將 36 個此類 集群全互連,構成一個 TPU 8i Pod
資料來源:Google; 凱基
KGI
圖4:TPU 8t 聚焦大規模訓練
資料來源:Google;凱基
資料來源:Google; 凱基
TPU 之主要需求包括Google 自用與外部客戶
TPU 的需求來源可分成 Google內部需求與外部雲端客戶兩大部分。內部 需求主要來自 Google DeepMind 與 Google 自有 AI 服務,包括 Gemini 等 frontier models 的 training、post-training 與 inference;隨著模型規模、 MoE、長 Context 與 Agentic AI 工作負載快速成長,Google 對 TPU 的需 求也從單純訓練逐步擴展至大規模推論。至於外部需求中,目前最重要且 公開規模最大的客戶之一為 Anthropic (US),2025 年 Anthropic 宣布擴 大 Google Cloud TPU 使用規模至最高 100 萬顆 TPU、超過 1GW 產能, 於 2026 年陸續上線;而於2026 年 4 月更進一步宣布與 Google、 Broadcom 簽訂新的合作協議,取得數GW (multiple gigawatts) 的下一世 代TPU產能 (TPU v8),預計 2027 年開始上線,主要支援 Claude frontier 模型。因此 TPU 的需求結構正在由過去以 Google 自用為主,逐步轉變成 「Google 自用 + 大型外部 AI Lab」雙引擎驅動,也使 TPU 開始具備更明 顯的人工智慧加速器之商業化特性。
資料來源:凱基
KGI
TPU v8 與 v7晶片之主要差異
第七代 Ironwood(TPU v7)仍採一套架構同時涵蓋訓練 (training) 與推 論 ( inference),每顆 TPU 配備 192GB HBM、7.38TB/s HBM頻寬,並透 過晶片間互連頻寬 (ICI) 3D Torus 架構進行大規模 scale-up;到了 v8, Google 則將不同工作負荷 拆分為 8t 與 8i。TPU 8t 擅長處理大規模、運 算密集的訓練工作負載,其設計旨在提供更大的運算吞吐量和更強的可擴 展頻寬,其配置 216GB HBM、6.53TB/s HBM bandwidth、128MB SRAM、 12.6 PFLOPS FP4,並加入 native FP4、SparseCore 與 Virgo Network,晶 片由聯發科設計;TPU 8i則具有更高的記憶體頻寬,旨在服務於對延遲最 為敏感的推理工作負載,強調記憶體容量(memory capacity) 與通訊延遲 性( communication latency),將 HBM提高至 288GB、8.60TB/s bandwidth、SRAM提高至384MB,並加入 CAE 與 Boardfly topology, FP4算力為10.1 PFLOPS,晶片則由Broadcom設計。相較v7 ( Ironwood), 8t大型 training 的 performance-per-dollar最高提升 2.7倍,8i針對大型 MoE低延遲 inference的performance-per-dollar最高提升 80%,兩者 performance-per-watt最高均提升約 2倍;因此 v7至v8 最重要的改變 並非單純提高 FLOPS,而是透過運算、記憶體、網路及工作負載專業化的 共同升級,提高整體系統效率。
| 圖 7:TPU v8系列透過運算、記憶體、Compute、Memory、網路及工作負載專業化的共同升級,提高整體系統效率 | 圖 7:TPU v8系列透過運算、記憶體、Compute、Memory、網路及工作負載專業化的共同升級,提高整體系統效率 - TPU v7 Ironwood | 圖 7:TPU v8系列透過運算、記憶體、Compute、Memory、網路及工作負載專業化的共同升級,提高整體系統效率 - TPU v8t | 圖 7:TPU v8系列透過運算、記憶體、Compute、Memory、網路及工作負載專業化的共同升級,提高整體系統效率 - TPU v8i |
|---|---|---|---|
| 設計合作夥伴 | Broadcom | MediaTek | Broadcom |
| 主要工作負載 | 大規模訓練、推論與服務 | 大規模預訓練 | 後訓練、推理 |
| 網路拓樸 | 3D torus | 3D torus | Boardfly |
| 每顆晶片HBM 容量 | 192 GB | 216 GB | 288 GB |
| 片上 SRAM(VMEM) | TBA | 128 MB | 384 MB |
| 峰值 FP4/晶片 | TBA | 12.6 PFLOPS | 10.1 PFLOPS |
| 每顆晶片 HBM 頻寬 | 7.38 TB/s | 6.528 TB/s | 8.601 TB/s |
| HBM 世代 | HBM3E | TBA | TBA |
| CPU host/header | TBA | Arm-based Google Axion | Arm-based Google Axion |
| 單一 Pod/rack | 9,216 顆 TPU | 9,600 顆 TPU | 1,152 顆( 1,024 顆在線) |
| Pod/機架 HBM 總容量 | 1.77 PB | 約 2 PB | 331.8 TB |
| 單一晶片功耗 | 1000w | <800w | 1300w |
| 散熱 | 液冷+氣冷 | 液冷 | 液冷 |
| 載板 | 80 x 85 mm /16L | 80~90 x 80~90 mm/18-20L(TBC) | 80~90 x 80~90 mm/18-20L(TBC) |
| CCL/PCB | 24L/M7 ; HVLP2 | 34L-40L/M8+ ; HVLP4 | 34-40L/M8+ ; HVLP4 |
| 光收發模組 | 800G (Scale Up) | 1.6T (Scale Up) | 1.6T (Scale Up) |
| 電源 | 5.5kW | 10kW | 10kW |
資料來源:凱基
KGI
圖8:TPU v8i tray示意圖
TPU v8機櫃設計多半為v7之延伸
TPU v7 Ironwood 的基本運算單元以 4顆 TPU為一個實體主機 (physical host),單一機櫃 (rack) 採左右對稱設計,共配置 64顆 TPU,也就是由 16 組4-TPU host組成。 每一層包括4顆TPU與4顆Axion CPU組成一個計 算單元,左右各 8 個單元,顯示機櫃內包含 64 顆 TPU,透過高速 ICI 連 接並形成一個 3D Torus Cube。當運算規模超越單一機櫃時,Google再 利用 Optical Circuit Switch(OCS)將多個64-chip Cube動態連接,例 如4個Cube即可形成256-chip pod,而最大Ironwood Superpod則由 144 個Cube × 64顆TPU = 9,216顆TPU組成,使數千顆晶片可以共同執行 大型模型的訓練與推論。OCS 除了負責 scale-up,也能在 Cube 或 link 發 生故障時重新配置光路並繞過故障節點,提高大型叢集的可用性。
至於v8 機櫃設計,則從單一架構進一步分化為 8t / 8i。TPU v8 在機櫃與 系統設計上最大的改變,是 8t 與 8i 在機櫃架構上不完全相同。8t 延續適 合大型training的3D Torus架構,但晶片間互連頻寬 (ICI bandwidth) 較 前代提高2倍,並新增Virgo scale-out network,單一Virgo fabric可連 結超過 134,000顆8t、提供最高47Pb/s non-blocking bisection bandwidth,再搭配 JAX 與 Pathways,可進一步形成超過 100 萬顆 TPU 的logical training cluster;8i則改採全新的Boardfly topology,每個tray 以 4顆TPU形成building block,8個board組成32-chip group,再由 36個group透過OCS互連,形成最多1,152顆physical TPU、最高1,024 顆active TPU的pod,將1,024-chip系統最大network diameter由3D Torus的16 hops降至僅7 hops,以降低MoE與reasoning workload的 all-to-all communication latency。依目前供應鏈資訊,v8每層L6板子上 除了 TPU 之外,還進一步整合 Power 與高速 Transceiver/Optics,並導入 Google 第四代(Gen4)液冷;因此 v8 機櫃升級的核心已不只是 TPU 晶 片效能提升,而是從運算、記憶體、網通、電源、散熱與光通訊全面進入 系統級之設計。目前主要L10/L11組裝廠商仍為Celestica (美),鴻海繼 v7 組裝 CPU 層與機櫃後,於 v8 增加 TPU 層與 L11 機櫃之組裝份額,而 英業達(2356 TT, NT$59.5, 持有)則主要供應TPU之L6為主,亦將有機會 擴及系統。
圖 9:TPU v8t tray示意圖
資料來源:公司資料;凱基
資料來源:公司資料;凱基
KGI
圖10:TPU v7 機櫃示意圖
資料來源:公司資料;凱基
圖 11:TPU v7基本運算單元以 4顆 TPU為一個實體主機,單 一機櫃採左右對稱設計,共配置 64顆 TPU
資料來源:公司資料;凱基
TPU v8散熱從「晶片液冷」走向「系統級液冷」
散熱架構是TPU v7 Ironwood升級至v8的重要變化之一。Ironwood採用 Google第三代液冷系統(Gen3),以CDU(Cooling Distribution Unit)將冷 卻液送至機櫃,再透過manifold、管路與水冷板 (cold plate) 直接帶走高功耗 晶片產生的熱量;Google官方也展示了Ironwood Superpod所使用的第三代 CDU,到了TPU v8,Google進一步升級至第四代液冷(Gen4),主要原因是 8t/8i 的運算密度與系統功耗持續提高,散熱需求已不再只集中於 TPU 本 身,而逐步延伸至整個高密度運算系統。 依目前供應鏈拆解資訊,v8每層水 冷板需要 12 片,包含 4 顆 TPU、4 組 Power 及 4 組 Transceiver,若以一機 櫃 16 層來計算,即相當於一櫃約 192 片水冷板,由於單層水冷板片數較多, 加上快接頭 (QD),預期單層水冷價值可望達2,500-3,000美元,單櫃價值可 望達4.5-5萬美金。 此水冷價值尚未包括CDU,Google同時已提出下一代 (第 五代) Project Deschutes CDU規格,散熱能力提升至約2MW、流量500 GPM、壓力達80-90 psi等級,為未來更高功率密度AI機櫃預留散熱能力。 由於 v8t 與 v8i 存在晶片與記憶體設計上之不同,因此液冷散熱之供應商也有 所區分,聯發科設計之v8t 之水冷板供應商以奇鋐與古河 (日)為主,而 Broadcom設計之v8i版本之水冷板供應商則以Cooler Master (台灣)與Boyd (美)為主。市場資訊表示,v7之CDU之設計有採用1.4MW CDU,而v8t開 始導入約2MW CDU,目前常見架構為一台CDU搭配約8個 機櫃,雖然CDU 額定容量不能直接視為機櫃實際功耗,但由 1.4MW 提升至 2MW 仍顯示 Google 必須為下一代 TPU 預留更大的散熱能力,此外,v8 的液冷範圍亦由 水冷板逐漸擴展至分歧管 (Manifold)、快接頭、Tubing、Rack distribution及 Optics cooling。
KGI
圖12:TPU v8系列在每一層tray將會有12片水冷板
資料來源:公司資料;凱基
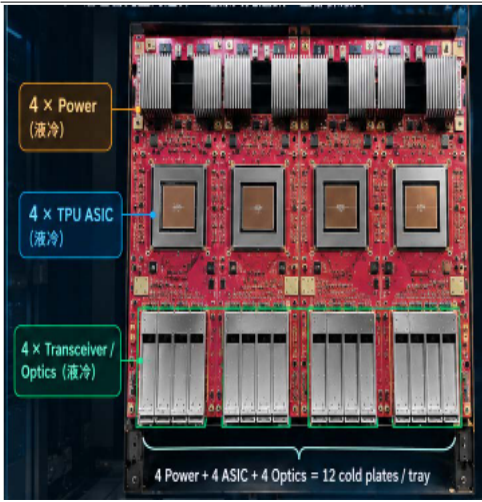
圖 13:TPU v8 系列在16層 tray 將採用類似設計,並採用第 四代CDU
資料來源:凱基
圖14:TPU v8升規搭配第四代液冷(Gen4)CDU
資料來源:Google; 凱基整理
KGI
v8版本開始採用高壓直流(HVDC)電源架構
隨著 TPU 的迭代升級,TDP(熱設計功耗)趨勢向上,v8 版本的電源系統規 格也持續提升。最顯著的變化在於相容±400V DC配置,惟現行50V DC方案 在本代產品中仍將佔據主流地位。在50V DC架構下,預計8i機櫃將採用3 排Power shelf,內含6個10kW的PSU;相較之下,v7機架則採用6排22kW 的Power shelf (每個包含4個5.5kW的PSU)。我們估算,單櫃的PSU總價 值將從 v7 版本的約 2 萬美元升至 8i 版本的 2.8 萬至 3 萬美元,增幅達 40-50%。此外,BBU(備用電池單元)和 DC-DC 電源模組預計將繼續作為 TPU機櫃電源系統的核心組件。我們認為台達電(2308 TT)是±400V DC電 源櫃的主要供應商,目前已開始出貨,並在電源市場享有高市佔率;Flex(美) 被視為第二供應商,而光寶科(2301 TT)據信也已於今年成功切入TPU供 應鏈。
圖15:電源架構隨TPU迭代持續升級,HVDC初步導入
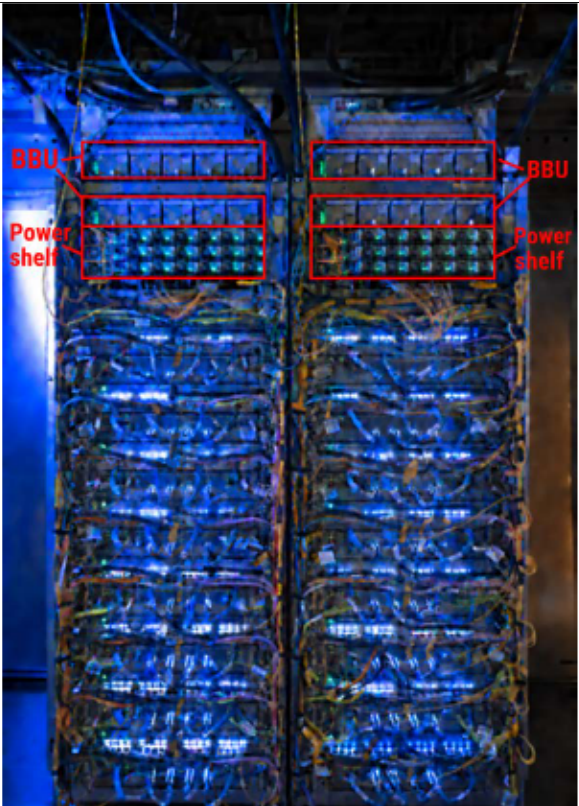
資料來源:凱基整理
KGI
圖16:TPU v8 載板大尺寸化
TPU v8 載板大尺寸化,PCB展現質、量雙軌成長
相較於TPU v7 Ironwood, v8同時受惠面積、層數、材料三重升級,ABF 載板由 v7 約 80-85mm/16L 放大至 v8 約 90-100mm/18-22L,估 ASP 提升40-50%;新一代 v8t、v8i主板34-40 層,CCL 材料升級至 M8+ 等 級並搭配 HVLP4銅箔,使CCL/PCB平均售價增加70%-80%,我們看好 市占率高達70% CCL之 台光電、 首度進入供應鏈的金像電(20-25% PCB 市 佔率)、 金居、ABF供應商欣興(3037 TT, NT$1,175, 增加持股) 將受惠此趨勢。
圖 17:TPU V8 PCB走高層數與多層HDI
資料來源:公司資料;凱基預估
資料來源:公司資料;凱基預估
Scale-Up 每顆TPU的光學用量正在上升
TPU v7 (Ironwood)為訓練與推論通用設計,採3D torus拓樸,每64顆ASIC 以 4×4×4 組成一個 Cube,對應一個機櫃,每個 Cube 對外拉出 96 條光纖; 總計一個 pod 有 144 個 Cube,合計 9,216 顆 TPU,故一個 pod 需要 13,824 條光纖、13,824 支光收發模組,以及 48 台 OCS,每顆 TPU 平均光學搭載率 (Optical Attach Rate)為1.5條光纖與1.5支光收發模組。
TPU v8世代把訓練與推論拆開,兩種晶片採不同拓樸設計。推論用的v8i, 沿用每個Tray 4顆ASIC,但拓樸從3D torus換成Boardfly,可使任兩顆距離 最遠的晶片,最多轉7次(hops)就可溝通,相較3D torus的16次,可讓延遲 少掉一半以上。
拓樸布建上,每個 Tray 對外使用 5 條光纖,一個 pod 則有 1,152 顆晶片,故 一個pod需要1,440條光纖、1,440支光收發模組,OCS預估使用5台,Optical Attach Rate為1.25。
訓練用的v8t則保留3D torus架構,每個Tray亦是4顆ASIC,惟Google尚 未公開單一機櫃的晶片組態,此將會決定3D幾何如何切分。
研究部產業調研,認為機櫃內以 4×4×2、32 顆 ASIC 為一個互連單元機率 高,因此每個機櫃對外將使用 64 條光纖;依此計算,一個 pod 有 9,600 顆 TPU 的狀況下,將對應 300 個機櫃、19,200 條光纖、19,200 支光收發模組、 64台OCS,Optical attach rate上升到2,比v7高33%。
KGI
圖 18:各TPU Pod的拓樸
| TPU v7 (Ironwood) | TPU v8i (推論) | TPU v8t (訓練) | |
|---|---|---|---|
| 【Scale-Up 拓樸】 | |||
| 拓樸架構 | 3D torus | Boardf ly | 3D torus |
| 每Tray晶片數 | 4 | 4 | 4 |
| 單元幾何 | 4×4×4 | - | 4×4×2/4×4×4* |
| 單元內晶片數 (顆) | 64 | 4 | 32/64 |
| 單元對外光纖數 (條) | 96 | 5 | 64/96* |
| 【Pod 規模】 | |||
| Pod實體晶片數 (顆) | 9,216 | 1,152 | 9,600 |
| 可用晶片數 (顆) | 9,216 | 1,024 | 9,600 |
| 備援晶片數 (顆) | 0 | 128 | 0 |
| 【每Pod光學用量】 | |||
| 光纖數 (條) | 13,824 | 1,440 | 19,200/14,400* |
| 光收發模組數 (支) | 13,824 | 1,440 | 19,200/14,400* |
| OCS 台數 (台) | 48 | 5(估) | 64/48* |
| 假設單台OCS埠數 (埠) | 300 | 300 | 300 |
| 【Optical Attach Rate】 | |||
| 每顆TPU光纖數 (條) | 1.50 | 1.25 | 2.00/1.50 |
| 每顆TPU光模組數 (支) | 1.50 | 1.25 | 2.00/1.50 |
| Attach Rate vs v7 (%) | - | -16.7% | 33.3%/-- |
低延遲、低功耗 Google大量使用OCS
Google採用OCS (Optical Circuit Switch)的原因,是因為OCS可直接在光纖 埠之間切換光束,不做光-電-光(OEO)轉換,因此可(1)降低傳輸訊號延遲、(2) 光收發模組從 400G、800G、升級到 1.6T,不須替換 OCS 本體、(3)省去 SerDes 與DSP,單埠功耗遠低於電交換器。
Google 使用的 OCS 採 MEMS 技術,主要由輸入光纖陣列、準直透鏡陣列、 兩組對向配置的2D MEMS微反射鏡陣列、輸出透鏡陣列、輸出光纖陣列等 元件構成。MEMS 本身是用半導體製程在矽晶圓上蝕刻出可雙軸偏轉的微反 射鏡,施加電壓控制偏轉角度,就能改變光束路徑,完成輸入埠到輸出埠的 切換。我們推測 Google 的 OCS 走自研與跟 Lumentum 合作兩條路線,台系 廠商在OCS本體上著墨有限。
整體而言,我們認為,隨著 TPU 出貨顆數放大,將帶動光收發模組、高密度 光纖陣列、MPO跳線與配線的用量,將有利台灣光纖集線、配線廠商光聖 (主 責Scale Out)、光收發模組內PD供應鏈全新(2455 TT)、環宇-KY (4991 TT)、 LD供應鏈聯亞 (3081 TT)、華星光 (4979 TT)、光環 (3234 TT)、聯鈞 (3450 TT)。
Scale Out拓樸資訊仍少;v8i尚未揭露互聯架構,v8t則在既有的Jupiter架 構之外,新增Virgo Network Fabric,可使交換器部署層級數由三層壓縮至兩 層。整體而言,TPU總部署量成長,仍將使Scale Out端的光收發模組、光纖 線纜與配線盒用量同步放大。
KGI
資料來源:Lumentum、凱基預估
圖20:Lumentum R300光路交換器
資料來源:Lumentum、凱基整理
KGI
2027年TPU晶片翻倍,預計機櫃量亦將翻倍成長
2027 年將是 Google TPU 明顯放量年,從晶片量的角度,預期TPU v8 出貨 量將由 2026年之約 402 萬顆增至 2027年之約 910 萬顆 (年增126%),其 中由聯發科設開發之 v8t 晶片量預計約為 360 萬顆,Broadcom 開發之 v8i 晶 片量預期約為 550 萬顆,因而預期 2027 年之 v8 機櫃總出貨量可望由 2026 年翻倍,將同步拉動 TPU晶片、ODM、散熱、電源、PCB/CCL 與光通訊需求。 相關受惠廠商包括: 晶片設計商聯發科(2454 TT,TPU v8t ASIC,2027年營 收貢獻約40%)與Broadcom (美, TPU v8i ASIC,2027年營收貢獻約45%)、 主要L10/L11系統組裝商 Celestica(CLS US, 25-30%)、電源廠商台達電 (2308 TT,Power Shelf/PSU/±400V HVDC,20-25%)、CCL供應商台 光電(2383 TT,20-25%)、PCB業者金像電(2368 TT,15-20%)、水冷 板新進廠商奇鋐(3017 TT,10-15%)、 HVLP4 銅箔供應商金居(8358 TT, 5-10%),其他營收貢獻較不顯著之供應商 (小於10%) 尚有鴻海(2317 TT, 機櫃 ODM)、英業達(2356 TT,L6 組裝)、健策(3653 TT, stiffener)、富 世達(6805 TT,液冷零組件QD)、欣興(3037 TT,ABF載板供應商)與光 寶(2301 TT,PSU)。此外,光通訊相關業者應屬TPU需求上揚之最大受惠 族群,TPU相關營收貢獻2027年皆有雙位數以上,包括聯亞(3081 TT,LD)、 光聖(6442 TT,光纖/配線與Scale-out)及 Lumentum(LITE US,OCS)皆 為主要受益廠商。
圖21:TPU ASIC 出貨顆數預計將於2027年翻倍成長
資料來源:公司資料;凱基預估
KGI
- 圖 22:TPU供應鏈中光聖、聯亞、博通、聯發科、Celestica、台達電、台光電、金像電子、Lumentum、奇鋐等公司占其2027年 營收比重達雙位數
資料來源:凱基預估
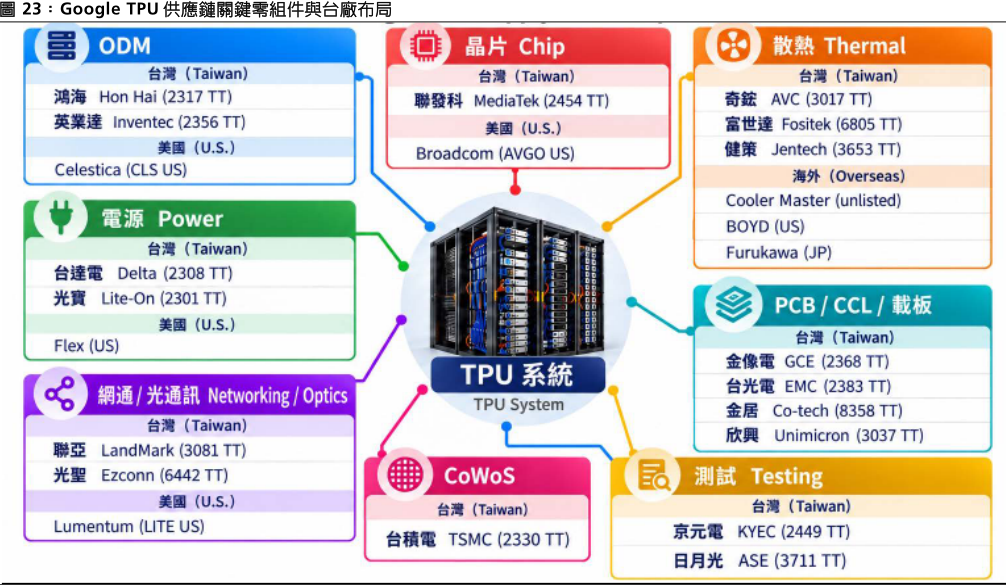
資料來源:凱基預估
凱基證券集團據點
| 中國 | 上海 | 上海市靜安區南京西路1601號越洋國際廣場1507室 郵政編號:200040 |
|---|---|---|
| 台灣 | 台北 | 104台北市明水路700號 電話 886.2.2181.8888‧傳真 886.2.8501.1691 |
| 香港 | 香港灣仔港灣道十八號中環廣場四十一樓 電話 852.2878.6888‧傳真 852.2878.6800 | |
| 泰國 | 曼谷 | 8th - 11th floors, Asia Centre Building 173 South Sathorn Road, Bangkok 10120, Thailand 電話 66.2658.8888‧傳真 66.2658.8014 |
| 新加坡 | 珊頓大道4號#13-01新交所第二大廈 郵政編號:068807 電話 65.6202.1188‧傳真 65.6534.4826 | |
| 印尼 | Sona Topas Tower Fl.11 Jl. Jend. Sudirman kav.26 JakartaSelatan 12920 Indonesia 電話62 21 250 6337 |
股價說明
等級
定義
增加持股 (OP)
對個股持正面看法,預期個股未來十二個月的表現超越凱基證券集團所追蹤的相關市場的總報
持有 (N)
酬。
對個股持中性看法,預期個股未來十二個月的表現符合凱基證券集團所追蹤的相關市場的總報
降低持股 (U)
酬。
對個股持負面看法,預期個股未來十二個月的表現低於凱基證券集團所追蹤的相關市場的總報
未評等 (NR)
酬。
凱基證券未對該個股加以評等。
受法規限制
未評等 (R)
受凱基證券集團內部政策和/或相關法令限制使凱基證券集團無法進行某些形式的資訊交流,其
中包括提供評等給投資人參考。
*總報酬 = (十二個月目標價-現價)/現價
凱基證券投資顧問股份有限公司(以下簡稱本公司)為凱基金控集團之成員。本報告之內容皆來自本公司認可之資料來源, 但不保證其完整性及精確性。報告內容所提及之各項業務、財務等相關檔案資料及所有的意見及預估皆基於本公司於特定 日期所做之判斷,故有其時效性限制,邇後若有變更時,本公司將不做預告或更新。本報告內容僅供參考,並不提供或遊 說客戶為買賣股票之投資依據。投資人應審慎考量本身之投資風險,並就投資結果自行負責。本公司及所屬集團成員,暨 其主管或員工皆有可能持有報告中所提及的證券。本公司及所屬集團成員並可能經常提供投資銀行或其他服務給報告中提 及之公司或向其爭取相關業務。本報告之著作權為本公司所有,非經本公司同意,本報告全文或部份內容,不得以任何形 式或方式引用、轉載或轉寄。