定義
AI 資料中心單站動輒數百 MW 到 GW,且負載由電力電子介面(PSU、UPS、VFD)與軟體控制,電網運營商因此開始對「大型運算負載」訂定專屬併網規範。內容分兩類(Google,OCP 2026-10-15):
- 非 ML 負載驅動:系統容量、故障穿越(VRT/FRT)、故障後有功恢復(PFAPR,Post-Fault Active Power Recovery,時間尺度為分鐘到小時)。
- ML 負載驅動:爬升率、分鐘內波動、強制振盪(秒到次秒)。
本頁彙整規範面(OCP 介面規格、NERC/FERC、ERCOT 與各區域電網要求)、功率波動的三層緩解,以及 NVIDIA MaxLPS 的軟體層位置。設施級儲能的產業面見 技術_AI_BESS。
圖解
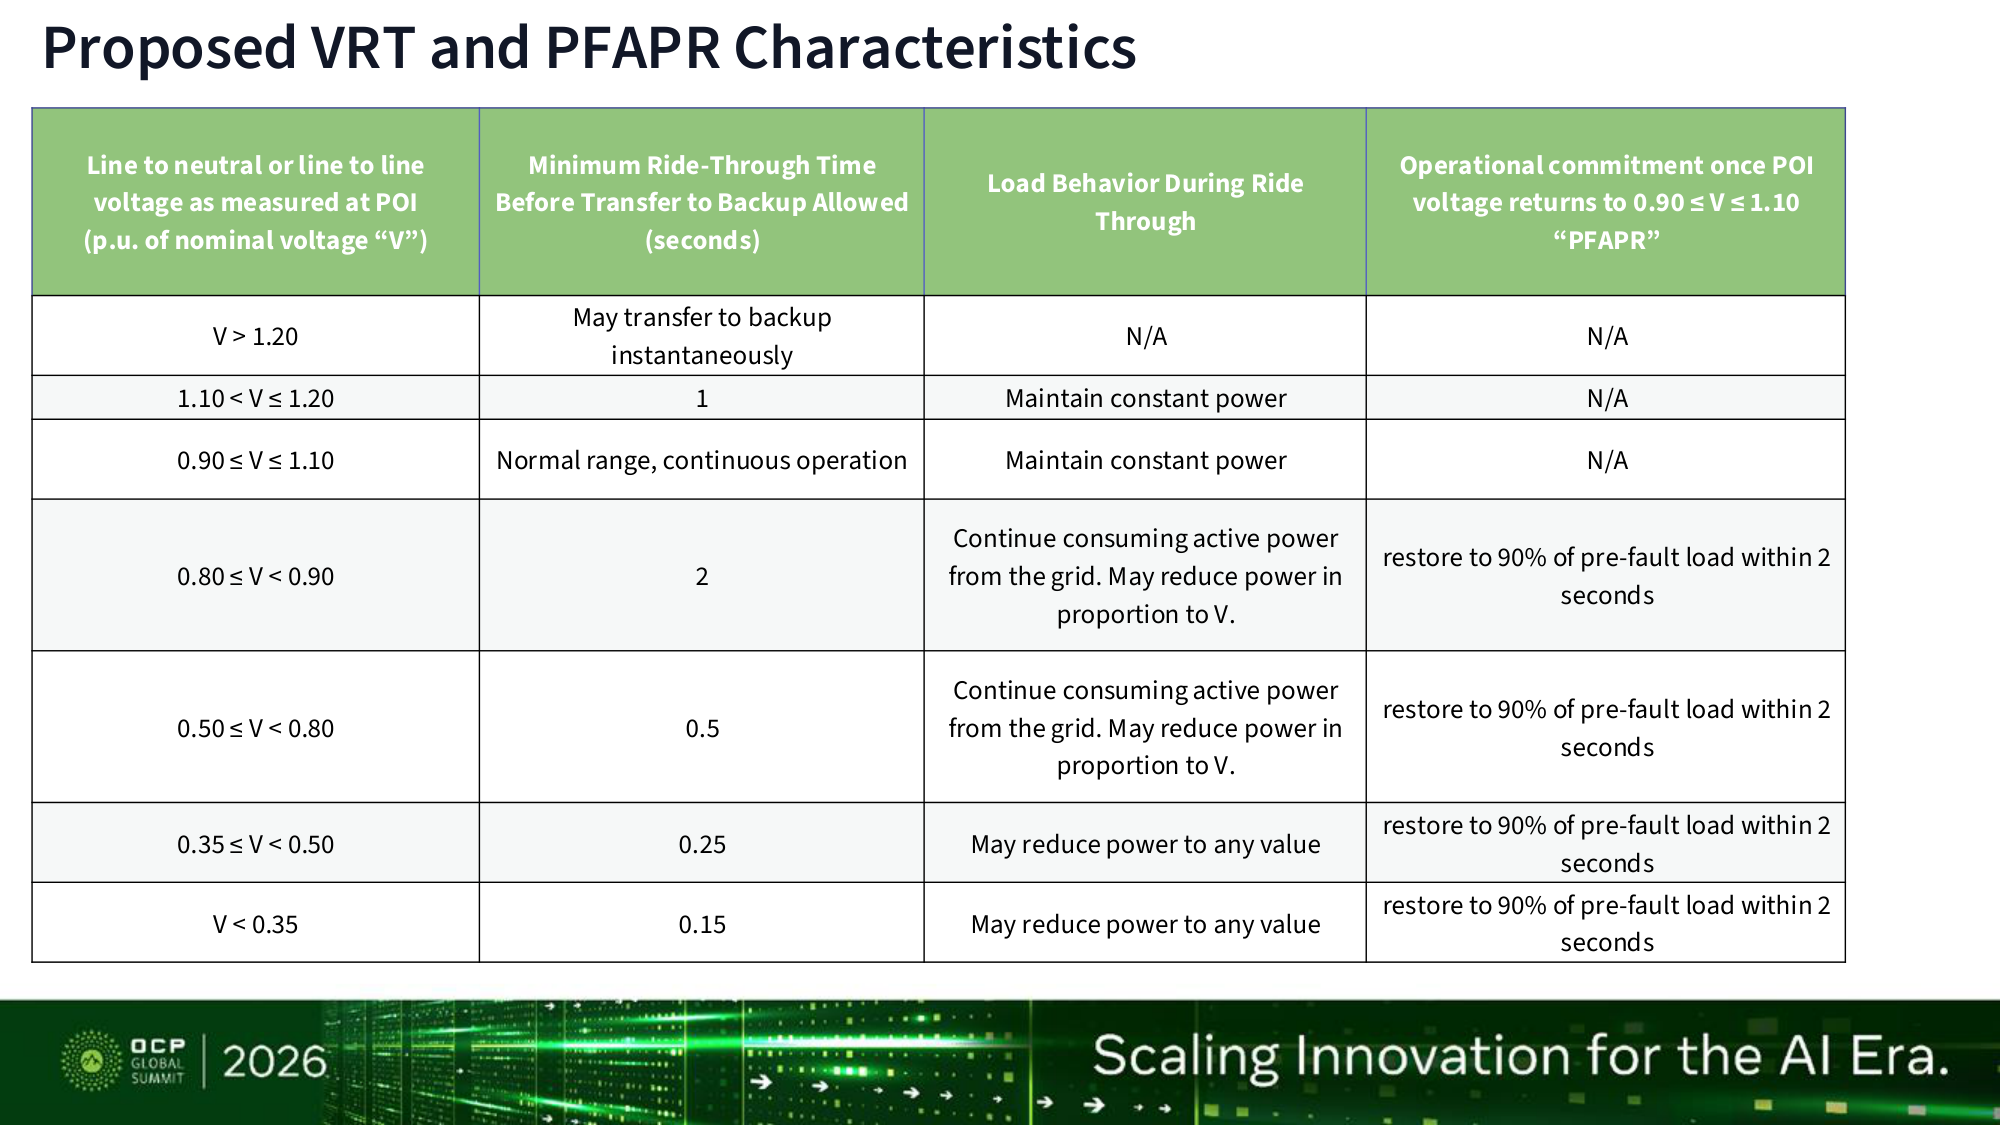
圖說:Google 提出的 VRT 與 PFAPR 建議特性表——依併網點(POI)電壓分七個區間(V>1.20、1.10–1.20、0.90–1.10、0.80–0.90、0.50–0.80、0.35–0.50、<0.35 pu),列最短穿越時間、穿越期間負載行為與恢復至 90% 負載時限(報告_OCP2026_Google_大型AI負載電網需求與緩解_20261015,2026-10)。
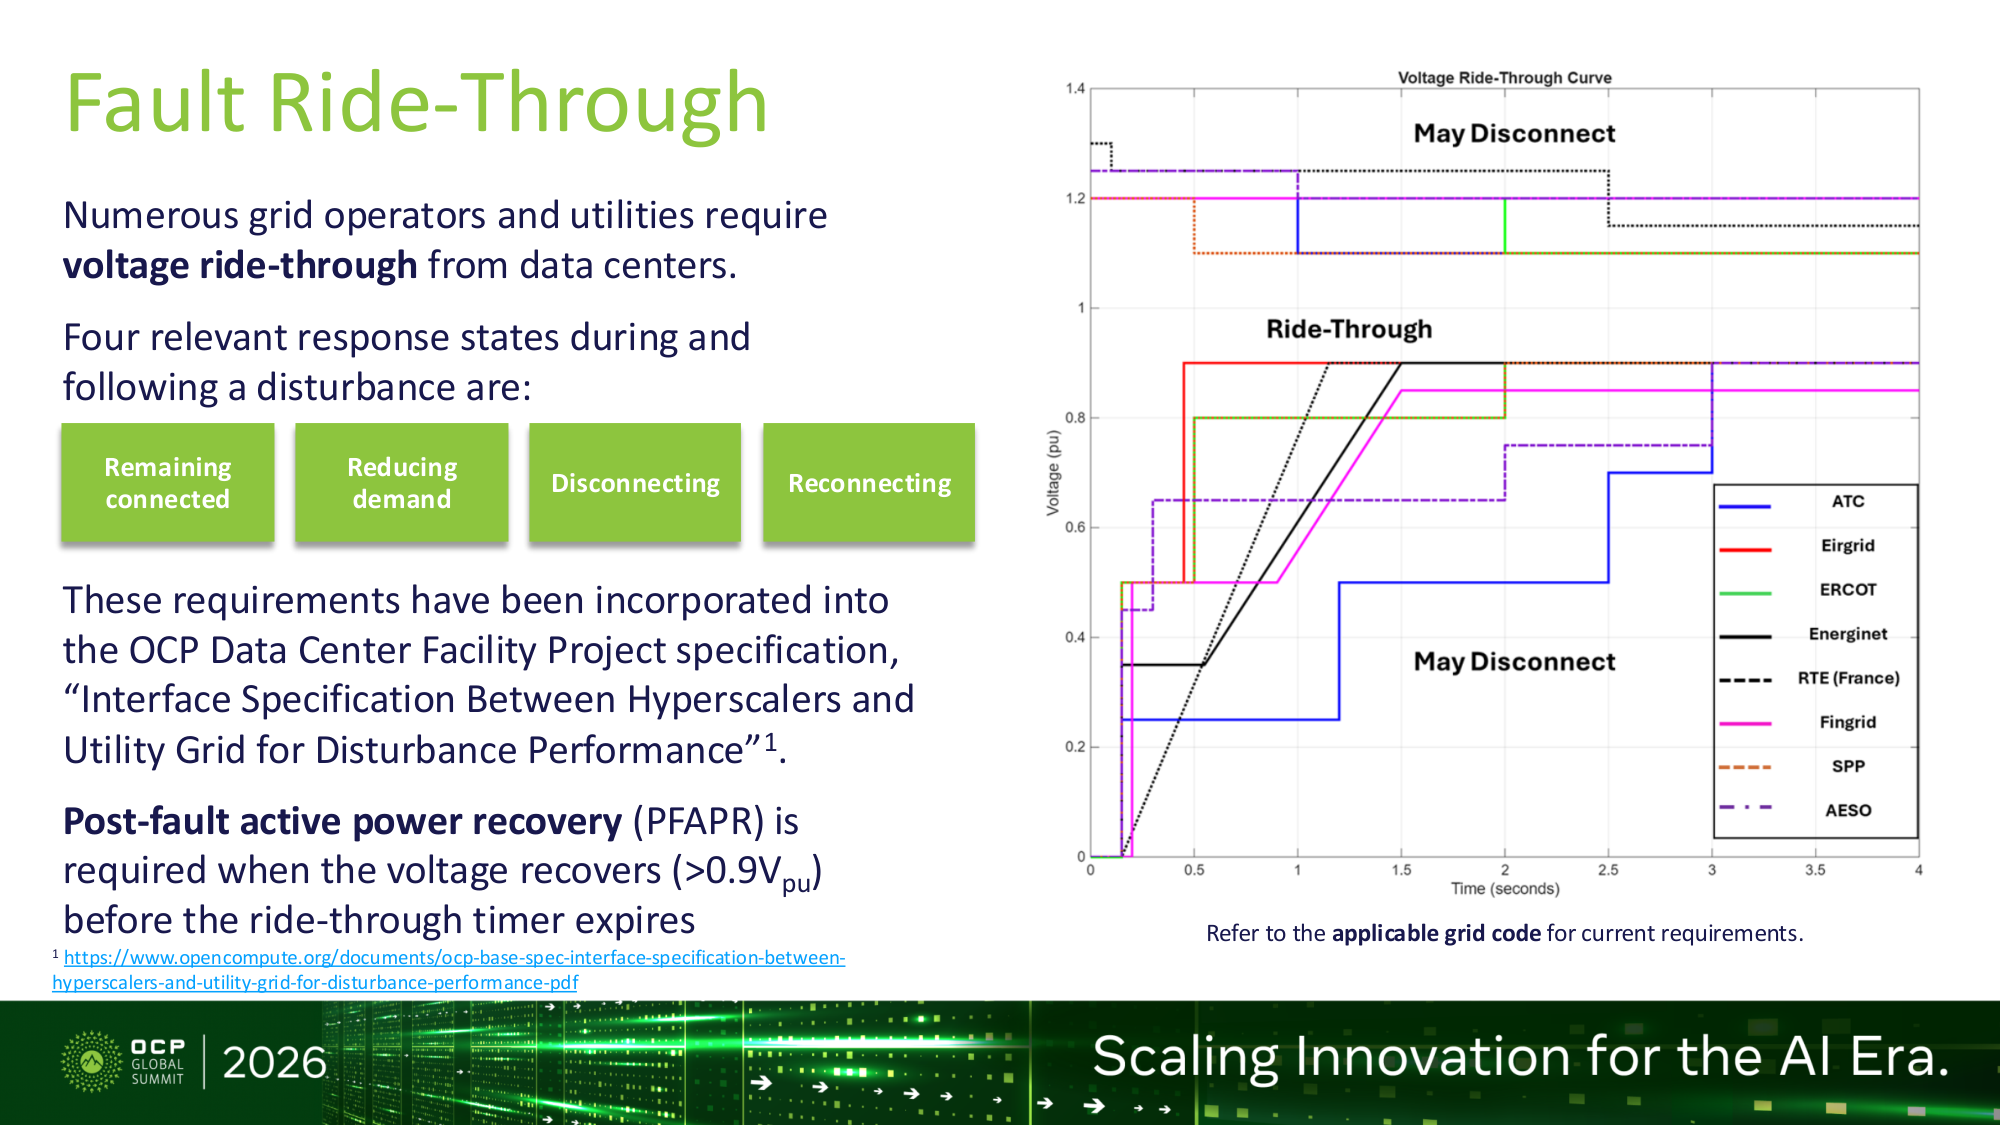
圖說:各電網運營商電壓穿越曲線疊圖(ATC、Fingrid、ERCOT、Energinet、RTE、SPP、AESO),標示可斷線與須穿越區,橫軸 0–4 秒、縱軸 0–1.4 pu(報告_OCP2026_NVIDIA_Equinix_大型負載併網需求_20261015,2026-10)。
技術原理
事件背景
- 2024-07 北維吉尼亞雷擊造成六次電壓跌落,約 1,500MW 電壓敏感負載同時掉線,電網運營商事先未預期(報告_OCP2026_Google_大型AI負載電網需求與緩解_20261015,2026-10)。
- NVIDIA/Equinix 簡報列東部互連自主減載(CILR)事件:2024-07 1,500MW、2025-02 1,800MW 與 428MW、2025-03 227MW、2025-05 540MW、2025-06 1,300MW、2026-07 3,800MW;德州 2023–2025 共 27 次、100–450MW。2026-07-22 Dominion 輸電故障正常清除後,資料中心減載約 3.8GW(簡報自述,未獨立查證;報告_OCP2026_NVIDIA_Equinix_大型負載併網需求_20261015,2026-10)。
VRT/PFAPR 建議特性(OCP 介面規格,Google 主筆)
| POI 電壓(pu) | 最短穿越時間 | 穿越期間負載行為 |
|---|---|---|
| V>1.20 | 可立即轉備援 | 無要求 |
| 1.10–1.20 | 1 秒 | 維持定功率 |
| 0.90–1.10 | 連續運轉 | 維持定功率 |
| 0.80–0.90 | 2 秒 | 持續取有功,可隨 V 比例降功率 |
| 0.50–0.80 | 0.5 秒 | 同上 |
| 0.35–0.50 | 0.25 秒 | 可降至任意值 |
| <0.35 | 0.15 秒 | 可降至任意值 |
電壓跌至 0.90 以下的各區,回到 0.90–1.10 後均須 2 秒內恢復至故障前 90% 負載。此要求超出 ITI(原 CBEMA)曲線(報告_OCP2026_Google_大型AI負載電網需求與緩解_20261015,2026-10)。
各區域恢復要求(同一簡報 p5):Fingrid 1 秒內 90%;ERCOT 2 秒內 90%;AESO 1.0–10.0 秒內 100%(可設);Energinet 5 秒內 80%、30 秒內 90%。
功率爬升與波動限制
ML 負載驅動類的電網限制(Microsoft 彙整,報告_OCP2026_Microsoft_訓練功率振盪與機櫃內濾波_20261015,2026-10):
| 電網 | 限制 |
|---|---|
| MISO | 10MW/5 秒滑動窗;爬升 30MW/min |
| ATC(MISO 內) | 25MW/5 秒,單頻不超過 10MW;30MW/min |
| ERCOT | 10MW/5 秒 |
| SOCO | 0.1–5Hz 單頻 10MW、5–55Hz 單頻 2.5MW;20MW/min |
| AESO | 10MW/min(原 0.16MW,改為研究為準) |
| LIPA | 0.1–5Hz 範圍 20MW、單頻 10MW;5–55Hz 單頻 3.5MW;20MW/min |
AI 訓練的週期性方波(運算段約 0.8–1.0、通訊重同步段約 0.1–0.2,週期約 20 秒量級)會落在電網共振頻帶:區間 0.1–0.5Hz、區域 0.5–0.8Hz、本地 0.8–2Hz、次同步與扭轉 5–55Hz;另有電網與資料中心介面阻抗穩定問題(13–27Hz)。Google 側的草案寫法為「每 5–10 秒不超過 [10–25]MW」,括號代表尚未定案。
規範時程
| 項目 | 時點 | 性質 |
|---|---|---|
| OCP「VRT 與 PFAPR」v1.0 | 2026-10 發布目標 | 規格 |
| OCP「功率爬升與波動」草案對齊/v1.0 | 2026 Q4/2027 Q1 | 規格預測 |
| NERC Project 2026-02 Computational Loads | 進行中(Phase 1 先訂基礎要求,後續階段處理故障穿越、多事件存活、PFAPR) | 規範 |
| FERC 令 NERC 提交標準與註冊準則 | 2026-12-31(FERC 於 2026-07-16 下令) | 規範 |
| NERC 工作計畫資訊報告 | 2027-03-01 | 規範 |
| ERCOT 大型運算負載 ride-through 要求 | 3Q26 起(庫內既有,見 技術_AI_BESS) | 規範 |
導入機制(OCP hyperscaler 提案):訂定特定生效日;既有或已簽併網協議的設施終身豁免;既有站增容僅增量部分適用;既有設施可自願遵循(可有電力公司獎勵);生效日後進入負載研究與簽約者須符合。
併網模型要求
NERC 擬議要求包含:提供穩態、短路、動態與暫態研究資料;提交驗證過的設施動態模型;通報「合格變更」;維持通訊並遵循調度;併網點安裝事件序列、故障、動態擾動記錄。ERCOT 單獨有 400+GW 大型負載併網申請,擬議指引要求每個大型負載提供 PSCAD 加 MQT(模型品質測試)。相量模型(PSS/E,時間步約 4ms)與 EMT 模型(PSCAD,1–50µs)各有適用範圍:ERCOT/TAMU 案例中,平均化 EMT(50µs)模擬 10 秒約 16 秒,開關模型(1µs)約 28 分鐘(報告_OCP2026_NVIDIA_Equinix_大型負載併網需求_20261015,2026-10)。
功率波動的三層緩解
| 層級 | 做法 | 位置主張 |
|---|---|---|
| GPU/機櫃 | NVIDIA Vera Rubin IPS(Intelligent Power Smoothing):GPU 韌體 ramp(範例 20 W/s)、電源架 AC ramp 限制(範例 400 W/s)、機櫃內 400J/GPU 儲能;NVL72 訓練實測 AC whip 峰值降 13%/51% | NVIDIA 偏機櫃內 |
| 機櫃電容、CBU、列級 BBU+CBU | Google 稱晶片與機櫃級(整合電容、機櫃內 CBU)→列級/sidecar(BBU+CBU 雙功能模組);Microsoft 主張機櫃內電容托盤主動濾波;Schneider 主張 800V 電源鏈上的功率電池 | Google 偏列級/sidecar;Microsoft 偏機櫃內;各家依自身產品線立場,非共識 |
| 設施 | BESS、MV-UPS(小時級與低頻成分)、站級 EMS;電網側 SVC、E-STATCOM | NVIDIA 把 BESS 與 EMS 歸「設施動態」,PCS 管振盪抑制 |
細節見 技術_超級電容CBU、技術_BBU備援電池、技術_AI_BESS。Google 的儲能需求為 ML 高頻循環約 100 萬次/年、10 年 100M+ 循環,LFP 僅 3k–10k 循環。
故障穿越另有三條路徑(Google):PSU(整流器)與低壓 UPS 韌體更新、儲能(超級電容、BESS)作穿越與負載模擬、MV-UPS(既有設施加裝受空間限制且多半太貴)。韌體路徑高度依 OEM,無法定全球時程。
MaxLPS(軟體層)
NVIDIA DSX 堆疊內的動態功率軟體 MaxLPS(全名簡報未展開),以閉環控制依工作負載重新分配節點功率上限;處理分鐘級以上的佈建餘裕與電網減載(load shedding),不處理秒級波動,也不涉及儲能硬體。範例:GB200 Kimi-K2.5 例,機櫃佈建功率 120kW→90kW、吞吐相同,同功率包絡多 33% 機櫃(120/90,算術例,非實測部署);540kW 預算下 4 櫃 GB300 實測 95/65/90/80kW,靜態分配閒置 210kW,動態分配可多放 1 櫃。Lambda 為採用客戶;Emerald AI(電網 ISV)、Phaidra(AI agents)為 DSX 合作對象(報告_OCP2026_NVIDIA_DSX_MaxLPS_20261015,2026-10)。
軟體定義電力(Microsoft Azure,字幕)
Microsoft Azure 運算效率團隊主張電力要像運算、網路、儲存一樣軟體化:現況是設施端按銘牌佈建(造成閒置電力)、排程器緊密打包(頂到階層上限)、硬體封頂只當後盾(不分關鍵與非關鍵),三者各自調校、合起來傷效率。做法是「觀察(電氣拓撲、功率遙測、工作負載屬性)→決策→執行」的閉環,並以硬體保護作安全網;控制迴路分速度——毫秒至秒級為封頂、路由與預算分配(保護),分鐘級為排程與擺放,月至年級為異質硬體與電網規劃(最佳化)。
- 功率導向(steering,把電力帶到工作):列、機櫃、伺服器、工作負載各層自管預算,遙測上行、預算下行;不再按最壞情況設計,餘裕(slack)可借給可卸載的內部彈性工作。推論時 prefill(算力密集、吃電、決定峰值)與 decode(記憶體受限、省電、留餘裕)分開配硬體並依需求調度,源自 Splitwise 研究。
- 功率塑形(shaping,把工作帶到有電的地方):把各電力域餘裕暴露給排程器與推論路由層,把請求導向未頂到上限的端點;Azure 資料中心各列溫差大,有的列很熱、有的很冷,可借此平衡。
- 緊急封頂:服務提供優先序、彈性與效能限制,讓封頂只動非關鍵工作;推論負載即使小幅降頻也能省下可觀功率。Microsoft 已把此邏輯做進自研 Cobalt Arm CPU 硬體(含作業系統提供的工作負載資訊),稱 Cobalt 200 在 Azure 上可超賣最多 20% 而不影響關鍵工作(技術文章,Microsoft 自述)。
- 背景數字(字幕,講者引述):IEA 預測 2035 年電力部署規模約為現今 2.5 倍(保守端,上看 3 倍);2026 年 AI 伺服器部署量預期 +31%,整體伺服器 +12.88%;大型雲端業者 2026 年資本支出約 6,500 億美元,講者稱效率若提升 1% 即省約 65 億美元。
- 對 OCP 的三項請求:開放遙測(統一功率與封頂訊號回報)、開放拓撲(以程式化方式暴露電力基礎設施)、開放控制(統一硬體控制介面);點名硬體管理與機櫃電力工作組為合適場域。每接一家新廠商都要重接遙測與控制系統,是目前無法規模化之處。
- 與 NVIDIA MaxLPS 同屬「軟體處理分鐘級以上佈建餘裕」,但 Microsoft 版涵蓋排程、推論路由與 CPU 硬體封頂;兩者皆為廠商自述,無第三方驗證,Microsoft 場次無簡報檔(video_OCP2026_Microsoft_雲端規模電力與效率_20261015,2026-10,自動字幕)。
關鍵參數 / 判斷指標
| 指標 | 數值 | 來源 |
|---|---|---|
| 穿越最短時間 | 0.15–2 秒(依電壓區間) | Google,2026-10 |
| PFAPR | 回到 0.90–1.10pu 後 2 秒內 90% | Google p6 表 |
| IPS 儲能 | 400J/GPU | NVIDIA,2026-10 |
| 儲能事件需求 | EDPP 37.5、低壓穿越 250、閒置 1 秒 1,000 J/kW;2 小時電網中斷 7.2MJ | NVIDIA 端到端簡報 |
| Schneider 成本估算 | 加掛功率電池 0.1–0.15 USD/W;新建 BESS 0.3–0.6 USD/W | Schneider,估算範圍寬 |
技術瓶頸 / 風險
- 規範仍在定稿:括號數值([10–25]MW)、NERC 後續階段未定,各區域差異大。
- 既有設施改造:PSU 韌體依 OEM、MV-UPS 加裝多半太貴。
- 位置之爭:各家依自身產品線主張機櫃內、列級或電源鏈,勿當共識。
- 事件數據(3.8GW、FERC/NERC 日期)出自簡報自述,未獨立查證。
口徑並列(無法判定者不裁定)
- Energinet 穿越:Google 大型負載場次寫「5 秒 80%、30 秒 90%」;Google 晶片到電網場次(報告_OCP2026_Google_晶片到電網協同設計_20261015)寫「5 秒 80%、20 秒 90%、30 秒 95%」。以原簡報圖為準,待查。
- PFAPR 恢復時間:Google p4 概述為 0.5–1 秒、p6 表為 2 秒;本頁採表值 2 秒。
- 規格狀態:本場稱 v1.0 於 2026-10 為「發布目標」,晶片到電網場次稱「2026-09 生效」,口徑為發布與生效之別。
- 縮寫:NVIDIA IPS 指 Intelligent Power Smoothing;Microsoft 整合電源方案報告的 IPS 指 Integrated Power Solution,兩者不同,見 技術_超級電容CBU。
- 機櫃功率單位:IPS 實測為 AC whip 的 kVA(約 40–60kVA,訓練穩態),與 TDP、佈建 kW 不同口徑,不可混用。
關鍵廠商
簡報幾乎全由 hyperscaler 與設備商主導,供應商多不具名。可連結的庫內線索:
| 環節 | 廠商 | 角色與證據強度 |
|---|---|---|
| GPU 韌體與軟體 | NVDA.US(nvidia) | IPS、MaxLPS、DSX(一手) |
| 電源架 | 2308_台達電(市)、2301_光寶科(市) | 列名 NVIDIA IPS AVL 電源架供應商(logo 加文字),僅 AVL 列名 |
| 設施 BESS | 見 技術_AI_BESS | DSX Ready 認證與台達電 PCS,本批簡報未重述 |
台廠證據偏薄,穿越規範對電容、BBU、BESS 與 PCS 的需求拉動多為推論。
應用場景
- 新建 AI 資料中心的併網研究與簽約(生效日後須符合)。
- 既有站增容的增量部分。
- 與現地發電、孤島運轉並行時的穿越與回流管理(見 分析_資料中心現地發電與許可時程_專家會議_20260901)。
相關技術
- 技術_AI_BESS、技術_超級電容CBU、技術_BBU備援電池
- 技術_HVDC、技術_固態變壓器SST(OCP SST 規格含 LVRT/OVRT 要求)
來源
- 報告_OCP2026_Google_大型AI負載電網需求與緩解_20261015 — Google,2026-10-15;VRT/PFAPR 數表、緩解選項、導入機制、OCP 時程
- 報告_OCP2026_NVIDIA_Equinix_大型負載併網需求_20261015 — NVIDIA/Equinix,2026-10-15;NERC/FERC 時程、事件清單、建模要求、緩解分層
- 報告_OCP2026_Microsoft_訓練功率振盪與機櫃內濾波_20261015 — Microsoft,2026-10-15;電網波動表、共振頻帶
- 報告_OCP2026_Google_AI負載功率波動硬體緩解_20261015 — Google,2026-10-15;三層儲能、循環需求
- 報告_OCP2026_NVIDIA_VeraRubin機櫃功率平滑_20261015 — NVIDIA,2026-10-15;IPS 參數與實測
- 報告_OCP2026_NVIDIA_DSX_MaxLPS_20261015 — NVIDIA,2026-10-15;MaxLPS
- video_OCP2026_Microsoft_雲端規模電力與效率_20261015 — Microsoft,2026-10;軟體定義電力(steering/shaping/封頂)、Cobalt 200 超賣、三項 OCP 請求
- 報告_OCP2026_Schneider_800VDC負載平滑與故障穿越_20261015 — Schneider,2026-10-15;功率電池與成本比較
- 報告_OCP2026_Google_晶片到電網協同設計_20261015 — Google,2026-10-15;區域恢復要求對照