定義
AI 推論的上下文(Context)越長,KV Cache 越大,DRAM 容量與成本成為瓶頸。「NAND 近記憶體化」指把部分原本放在 DRAM 的熱資料(KV Cache)卸載到速度與頻寬被大幅拉高的 NAND 儲存層,或把 NAND 直接與 SoC 封裝在一起,讓 NAND 扮演介於 HBM/DRAM 與傳統 SSD 之間的中間層。
高盛(GS)2026-10-12 的框架把問題界定為「記憶體牆」:上下文視窗由約 1.5M token 基準往 10M token 以上擴張(Exhibit 1,Llama 4 Scout 為 10M),KV Cache 隨之膨脹,瓶頸由純頻寬轉為「頻寬+容量」;HBM 每顆 GPU 約 192GB、受 DRAM 供給所限,業者只好多買 GPU 來湊近算力記憶體容量,造成算力閒置。HBF(High-Bandwidth Flash)由 SanDisk 與 SK Hynix 合作提出,是一種開放標準(OCP 治理,成員含 SanDisk、SK Hynix,ASIC 客戶 Alphabet、Meta)的近算力記憶體層:把高密度 3D NAND 以 TSV 與 UCIe chiplet 互連堆進 AI 加速器封裝,單堆疊最高 512GB(HBM 為 16-32GB)、循序讀取頻寬最高約 3.0TB/s(GS,2026-10-12)。
圖解
flowchart LR
  A["GPU / ASIC"] --> B["HBM(最高頻寬、最貴)"]
  A --> C["DRAM(RDIMM / LPDDR)"]
  C -. "KV Cache 卸載" .-> D["近記憶體 NAND<br/>XL-Flash / HBF / Z-NAND"]
  D --> E["Enterprise SSD(QLC)"]
示意圖,依凱基專題文字整理,非券商原圖。
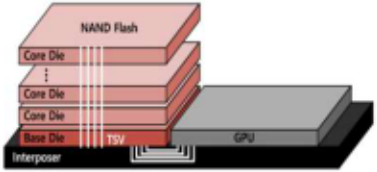
圖說(Exhibit 2):HBF 剖面示意圖,多層 NAND Flash Core Die 疊在 Base Die 上、以 TSV 垂直貫穿,與 GPU 並排放在同一 Interposer 上;來源 SK Hynix,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012(GS,2026-10-12)。
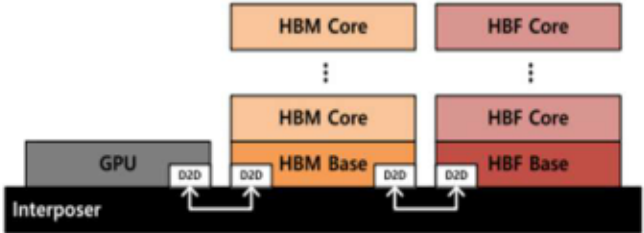
圖說(Exhibit 6):SK Hynix「H3」混合架構側視圖,GPU、HBM(HBM Base+HBM Core)與 HBF(HBF Base+HBF Core)並排於 Interposer,HBF 經 D2D 介面串接 HBM Base 與 GPU;來源 SK Hynix,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
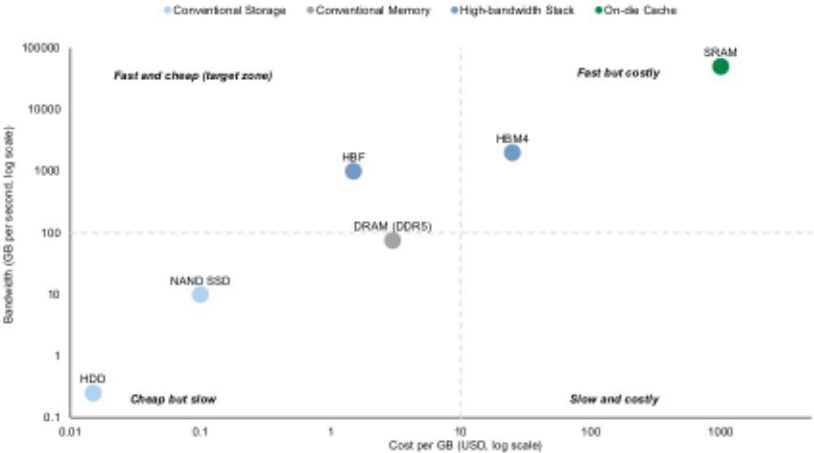
圖說(Exhibit 3):記憶體階層散布圖(X 軸每 GB 成本、Y 軸頻寬,皆對數座標),HBF 落在「Fast and cheap」目標區,介於 NAND SSD / DDR5 與 HBM4 之間;來源 GS Global Investment Research,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
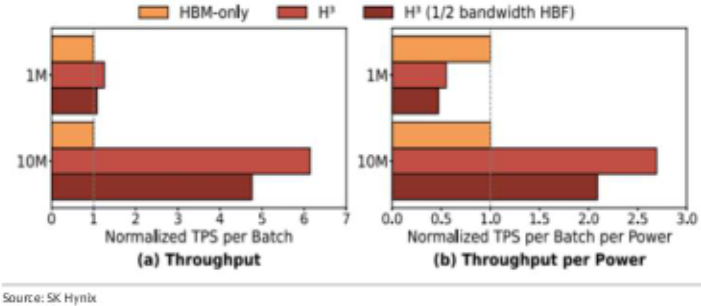
圖說(Exhibit 7):HBM-only、H3、H3(HBF 頻寬減半)在 1M 與 10M token 下的標準化吞吐(TPS per batch)與每瓦吞吐;10M token 時 H3 吞吐約 6.1x、每瓦約 2.7x,1M token 時每瓦反而低於 HBM-only;來源 SK Hynix,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
技術路線(凱基記憶體專題,2026-10-01,經珩石筆記轉述,中信心)
| 路線 | 做法 | 目前進度 | 廠商 |
|---|---|---|---|
| KV Cache 卸載 | 把部分 KV Cache 由昂貴的 DRAM 移到 NAND SSD;NVIDIA 的 CNX 架構屬此類方案 | 已成趨勢 | NVDA.US(nvidia)、各家 Enterprise SSD 廠 |
| XL-Flash(超高 IOPS SSD) | 鎧俠目標 1 億 IOPS,約為傳統 Enterprise SSD 的 100 倍;採 SLC 顆粒、以 3D NAND 製程生產,晶圓消耗為傳統 NAND 的 3-4 倍,具產能排擠潛力;並研發與 CXL 整合、規劃下一代 Octane 產品 | 研發/規劃中 | 285A.JP(kioxia) |
| HBF(Hybrid Bonding Flash) | SK Hynix 與 Sandisk 合作,將 NAND 與 SoC 直接封裝,目標接近 HBM 的頻寬與約十倍容量 | 量產預計 2028 年後 | 000660.KR(sk_hynix)、SNDK.US(sandisk) |
| Z-NAND | 三星的高速 NAND 路線,同樣以 NAND 與 SoC 近接封裝為目標 | 量產預計 2028 年後 | 005930.KR(samsung) |
HBF 規格與 H3 混合架構(GS,2026-10-12)
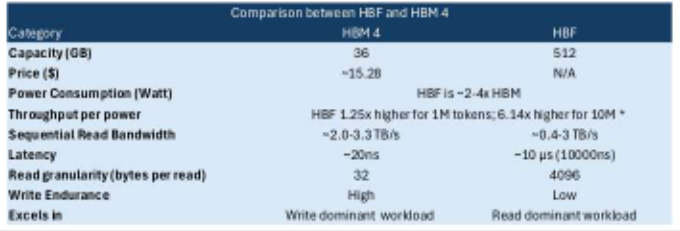
圖說(Exhibit 5):HBM4 與 HBF 規格比較表(容量 36 vs 512GB、循序讀取頻寬約 2.0-3.3 vs 約 0.4-3 TB/s、延遲約 20ns vs 約 10μs、讀取粒度 32 vs 4,096 bytes、寫入耐久 High vs Low);來源 Silicon Analyst、Hot Chips、GS,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
- 定位:HBF 在記憶體階層中插入 HBM 與傳統 SSD 之間,循序讀取頻寬接近 HBM、單位容量成本遠低於 HBM;GS 預期 HBF 每 GB 價格將顯著低於 HBM4 合約價(價格尚未公開),商業樣品 CY27 開始出貨(GS,2026-10-12)。
- 適用負載:讀取主導(model weights、預先計算的 KV Cache);寫入主導負載仍是 HBM 的強項。GS 判斷為抑制 NAND 熱與耐久限制,HBF 堆疊可能採 SLC,晶粒面積約為傳統 NAND 的 3.5 倍(對傳統 NAND 晶圓空間比 3.5x,與 DRAM/HBM 比值相近)。
- H3 混合架構(SK Hynix 提出):HBF 以菊鍊方式經 HBM base die 連接,不占用 GPU 有限的邊緣(shoreline);低成本 HBF 存靜態大型資料(權重、預算 KV Cache),HBM 只留給延遲敏感的即時解碼。依 SK Hynix 研究:HBF 約 512GB/堆疊、每 GPU 約 4TB,容量約為 HBM 的 16 倍;1M token 時批次大小可大 2.6 倍、吞吐約 1.25 倍,10M token 時批次大 18.8 倍、吞吐約 6.14 倍;每堆疊 HBF 功耗約 80-160W(HBM 約 40W),但每瓦吞吐最高約 2.7 倍。
- XPU 利用率:依 SanDisk 說法,4 顆搭載 HBF 的 XPU(每顆 192GB HBM+4TB HBF)可匹敵 8 顆純 HBM XPU 的總服務吞吐。
成本效益推算(GS)
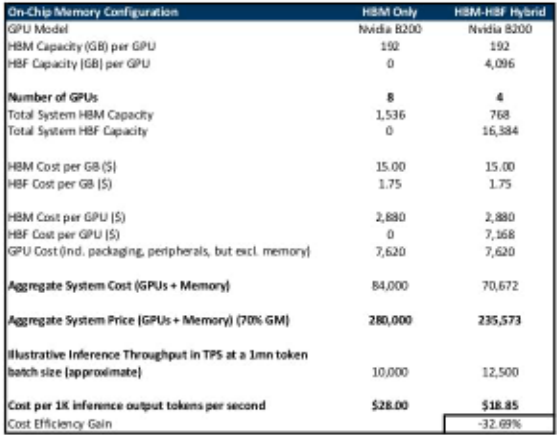
圖說(Exhibit 4 上半):HBM-only(8 顆 B200)與 HBM-HBF 混合(4 顆 B200)的每 1M token 成本比較表;來源 公司資料、TrendForce、GS,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
| 項目 | HBM-only | HBM-HBF 混合 | 備註 |
|---|---|---|---|
| GPU 數量(B200) | 8 | 4 | 每顆 HBM 192GB;混合每顆另配 HBF 4,096GB |
| 系統 HBM/HBF 容量 | 1,536GB/0 | 768GB/16,384GB | |
| 單價假設 | HBM US$15/GB | HBF US$1.75/GB | GS 稱 HBF 價格屬保守假設 |
| 系統成本(GPU+記憶體) | US$84,000 | US$70,672 | 售價以 70% GM 計:280,000 vs 235,573 |
| 1M token 批次 TPS(約略) | 10,000 | 12,500 | |
| 每 1K 輸出 token/秒成本 | US$28.00 | US$18.85 | 成本效率 -32.69% |
- GS 結論:HBF 可使每單位推論 token 輸出成本降約 30% 以上,轉化為數千億美元等級的超大規模業者資本支出節省(GS 首頁用語為 several hundreds of billions);效益隨序列長度近線性放大。
- 敏感度(Exhibit 4 下半):HBF 價格 US$0.25/GB 時成本效率 -56.10%、US$1.00 時 -44.40%、US$1.75 時 -32.69%、US$2.50 時 -20.99%,即使價格拉到 US$2.50 仍有約 21% 的成本優勢(H3 於 4 GPU 配置)。
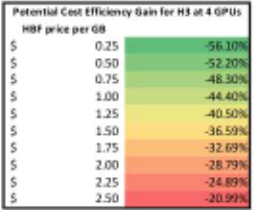
圖說(Exhibit 4 下半):H3 於 4 GPU 配置下,HBF 價格每 GB US$0.25-2.50 對應的成本效率增益表(-56.10% 至 -20.99%),US$1.75 為 -32.69%。
市場規模與 NAND 產能占用(GS 預測模型)
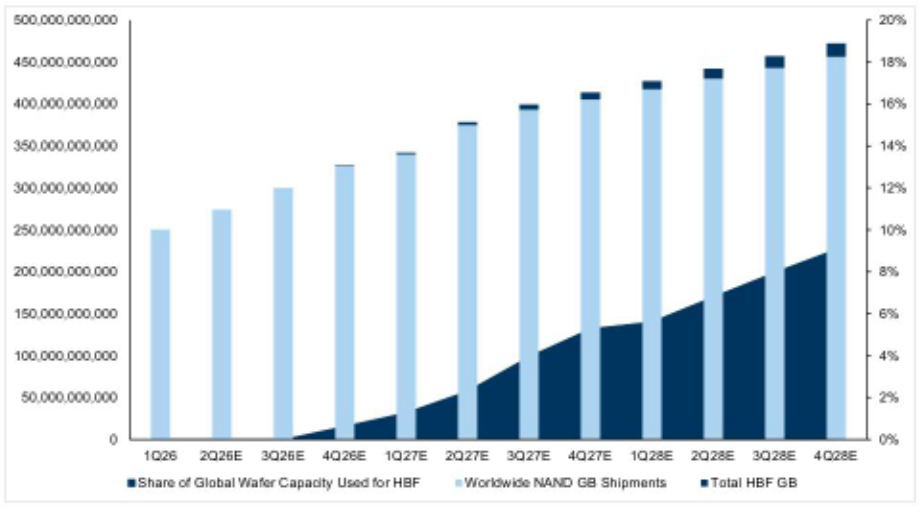
圖說(Exhibit 8):1Q26-4Q28E 全球 NAND GB 出貨(淺藍柱)、HBF GB(深藍小柱)與 HBF 占全球晶圓產能比重(深藍面積、右軸,4Q28E 約 9%);來源 TrendForce、GS,轉引自 報告_GS_HBF高頻寬快閃記憶體_20261012。
| 情境 | 假設 | 結果(GS,2026-10-12) |
|---|---|---|
| 保守 | 約 15% 的 GPU 採用 HBF(2030 年底),HBF 價格 US$1.75/GB | 年化 HBF TAM 約 US$40bn |
| 多頭 | 50% 的 XPU 於 2028 年底(4Q28)採用 HBF | HBF TAM 約 US$150bn;約 4% 的全球 NAND 位元出貨(表列 4Q28E 3.52%)、約 9% 的全球 NAND 晶圓產能(表列 4Q28E 8.55%) |
- 模型要點(Exhibit 9,見 Raw_data 頁 OCR 備註):HBF 搭載率自 4Q26E 5% 逐季爬升至 4Q28E 50%(1Q27E 10%、2Q27E 17.5%、3Q27E 25%、4Q27E 30%);每單位 HBF 4,096GB;4Q28E HBF 約 16.05B GB,所需晶圓約 42.9 萬片;XPU 基數以 NVDA、AVGO、AMD、MRVL 為主(4Q28E 合計 7,838k 顆)。
- 位元占比低、晶圓占比高(約 9%)的原因是 SLC 與大晶粒面積,結構類似 HBM 之於 DRAM;GS 因此認為 HBF 可能延長當前 NAND 供給偏緊的週期(有限的產能新增+HBF 吃掉晶圓),詳見 分析_NAND產業週期_MS_20260702 的供需模型對照。
- GS 提醒 NAND 系解方在系統層級仍屬早期,結果區間很寬,可能對 NAND 供需造成遠大於或遠小於預期的影響。
採用挑戰(GS)
- 頻寬與延遲:HBM4E 已在送樣、頻寬至少高約 50%;任何寫入都會大幅拉低 HBF 有效頻寬,其實用效益高度依賴讀取效能跟上最新 HBM 世代。
- 讀寫比不確定:推論雖以讀取為主,但若 prefix cache 未命中則讀寫比趨近零,早期部署的有效頻寬可能難以預測。
- 耐久、功耗、散熱:NAND 有 P/E 次數限制;H3 單 cube 約 160W(約為 HBM3E 的 4 倍、HBM4 的 2.5 倍),H3 用 8 個 HBF 堆疊,旗艦加速器尖峰功耗約 1,000-1,200W,HBF 自身功耗就可能逼近加速器的限制,過熱再加速記憶胞磨損。
- 製造資源密集:TSV、混合鍵合、超寬封裝內互連使成本約為傳統 NAND 的 3-4 倍(與 DRAM/HBM 的 trade ratio 相近),晶圓消耗高。
- GS 判斷最大障礙為頻寬限制與資源密集度;KV Cache 讀寫比與 HBF 定價為後續關鍵變數。
替代路線比較:XL-Flash 與 zNAND-O(GS)
| 路線 | 做法 | 與 HBF 差異 | 進度(GS,2026-10-12) |
|---|---|---|---|
| XL-Flash(Kioxia) | 基於 BiCS 3D NAND;走標準 PCIe/NVMe/CXL 匯流排;SLC、較小傳輸區塊、較大晶粒,以拉高頻寬、顯著降低隨機讀延遲並提升寫入耐久 | 無 TSV、與 GPU 物理分離(HBF 與 GPU 共用 silicon interposer),沿用既有 3D NAND 製造,轉換成本與投資風險較低;可能較適合寫入,但頻寬較 HBF 低;為 SSD 方案 | Kioxia 規劃 CY26 年底送出 >1,000 萬 IOPS 樣品、CY27 送出第二代 1 億 IOPS 樣品 |
| zNAND-O(Samsung) | 以 TSV 串接 4 或 8 層 V-NAND 晶粒的垂直堆疊 | 概念近似 HBF,但鎖定裝置端 AI(手機、PC)市場 | 發展中;Samsung 另開發 zHBM(記憶體堆在 AI 加速器之上而非並排)供資料中心,並已申請「zHBF」商標,HBF 細節尚未公布 |
- GS 認為三條路線最終都是以 NAND 為基礎的系統層方案,目的皆為在拉長上下文的同時降低系統成本;哪條先上市尚難判斷。
- XL-Flash 與 HBF 並非互斥:前者較偏寫入與通用 SSD 場景,後者較偏讀取密集的推論。
來源差異(待後續報告釐清)
- 名稱:凱基專題轉述寫作 Hybrid Bonding Flash;GS 與 OCP 脈絡為 High-Bandwidth Flash(SanDisk/SK Hynix 提出),GS 只在封裝層提到混合鍵合。兩個全稱並存,本頁 aliases 皆保留,以 GS 為準。
- XL-Flash 規格:凱基筆記稱 Gen 3 目標 1 億 IOPS;GS 稱第二代 CY27 樣品 1 億 IOPS,首代 CY26 年底樣品 >1,000 萬 IOPS,世代編號差異未釐清。
- HBF 時程:凱基稱量產 2028 年後;GS 稱商業樣品 CY27,兩者並不矛盾(樣品早於量產)。
- GS 內部標示:Exhibit 5 規格表「Throughput per power」列寫 1.25x(1M)/6.14x(10M),與 Exhibit 7 圖中「吞吐(TPS per batch)」數字相同;每瓦吞吐在 Exhibit 7 圖中為 1M 約 0.55、10M 約 2.7,疑為表內標示混用,引用時以圖 Exhibit 7 為準。
廠商立場(GS,2026-10-12)
| 廠商 | GS 評等 | 與 HBF 的關係 |
|---|---|---|
| SNDK.US(sandisk) | Buy | HBF 共同提出者、技術領先;NAND 製造靠 Kioxia 夥伴關係,資本密集度低,GS 視為差異化優勢 |
| 000660.KR(sk_hynix) | Buy | HBF 與 SanDisk 共同開發與標準化推動者;NAND 經驗加 HBM 先進封裝能力,GS 視為潛在 HBF 市場領導者 |
| 005930.KR(samsung) | Buy(APAC Conviction List) | 尚未公布 HBF 細節,但有 zNAND-O(TSV 整合)與 zHBF 商標申請;NAND 產能全球最大、具 DRAM/NAND/晶圓代工/先進封裝完整能力 |
| 285A.JP(kioxia) | Buy | 走 XL-Flash(SSD 路線、不需 TSV);SanDisk 的製造夥伴 |
| MU.US(micron) | Neutral | 專注 HBM/DRAM、未加入 HBF 治理聯盟、優先擴 DRAM greenfield,GS 預期其在 HBF 市占受限 |
- 半導體設備:GS 視 HBF 為小幅增量利多(TSV、混合鍵合、先進封裝、檢測與測試帶來增量;但提升 GPU 利用率可能降低加速器需求,整體仍由封裝與記憶體密集度抵銷)。
- 數位半導體(NVDA、AVGO、AMD 等):GS 認為邊際偏負面(高效能 NAND 方案成功會降低同效能下的加速器數量);Nvidia 掌握整套系統堆疊,可像在 Rubin 世代最佳化 HBM-NAND 平衡一樣緩解影響。
關鍵判斷
- 過去對 NAND 作為近記憶體的壽命疑慮,因 AI 推論場景以「讀取」為主,筆記引述研究稱壽命可達 7-15 年,技術可行性提高;但量產時程仍在 2028 年後,屬早期題材。
- 受惠面:NAND 位元與晶圓消耗上升(XL-Flash 晶圓消耗 3-4 倍),加強 Enterprise SSD 與上游矽晶圓需求;與非三大廠的 DRAM 廠商合作的策略價值也提高(筆記指鎧俠此布局)。
- GS 的量化看法(2026-10-12):HBF 可使推論成本降約 30%,TAM 約 US$40-150bn(採用率 15-50%、2030 年前後),多頭情境下占約 4% 位元但約 9% 晶圓產能,因此偏好 SanDisk、SK Hynix、Samsung,Micron 受惠較少;GS 認為 HBF 可能延長當前 NAND 緊俏週期的時間長度(見「市場規模與 NAND 產能占用」)。
- 需求側驗證點:Microsoft、Google、Meta 近期大幅追加 QLC Enterprise SSD 訂單(凱基稱連過去鮮少採購的 Google 也上調預測)。
- SK hynix MARS 與異質記憶體(OCP 2026,MS 2026-10-13):SK hynix 於 OCP 提出 MARS 分散式記憶體架構,以共享 KV Cache 存取取代重算,time-to-first-token 改善約 3-5 倍;HBF 目標約為 HBM 一半的頻寬、約 14 倍容量。MS 認為推論將走 HBM/DRAM/NAND 異質記憶體架構,記憶體含量可能擴大到傳統 GPU 附掛 HBM 之外。來源:報告_MS_OCP峰會2026_20261013
HBF 時程並列:GS 稱樣品 CY27、SK hynix 簡報稱 Spec 1.0 2027-01 與 Cube 2028Q1
| 來源 | 說法 | 性質 |
|---|---|---|
| GS(2026-10-12) | 商業樣品 CY27 開始出貨 | 券商預估,較樂觀 |
| MS(2026-10-13) | OCP 場合引述 SK hynix,樣品預期 2028 年初 | 轉述 |
| SK hynix OCP 簡報 p17(報告_OCP2026_SK海力士_MARS記憶體中心機櫃_20261015,2026-10) | 2026.2 OCP 聯盟啟動(Spec α)、2026.7 v0.7 公開、2027.1 Spec 1.0(預期)、2028.1Q HBF Cube 可取得 | 簡報本人時程表,預期值 |
判讀:Spec 1.0 與樣品/Cube 是不同里程碑,不必然互斥;但 GS 的 CY27 樣品與 SK hynix 的 2028Q1 Cube 相差約一年,GS 較樂觀。以 SK hynix 自家時程表為「可取得」基準,三說並列保留,待 SK hynix 或 SanDisk 官方確認樣品日。
KV 分層與 SSD 耐久(OCP 2026 實測與建模)
OCP 2026(2026-10-12 至 15)有多場記憶體廠與 hyperscaler 簡報,共同結論是 KV Cache 已是跨機櫃的分層問題,業界一致走 HBM→DRAM→CXL→SSD 四到五層;絕大多數數字為廠商自測或建模,模型、負載、基線各不同,絕對值不可互比,只能比方向。
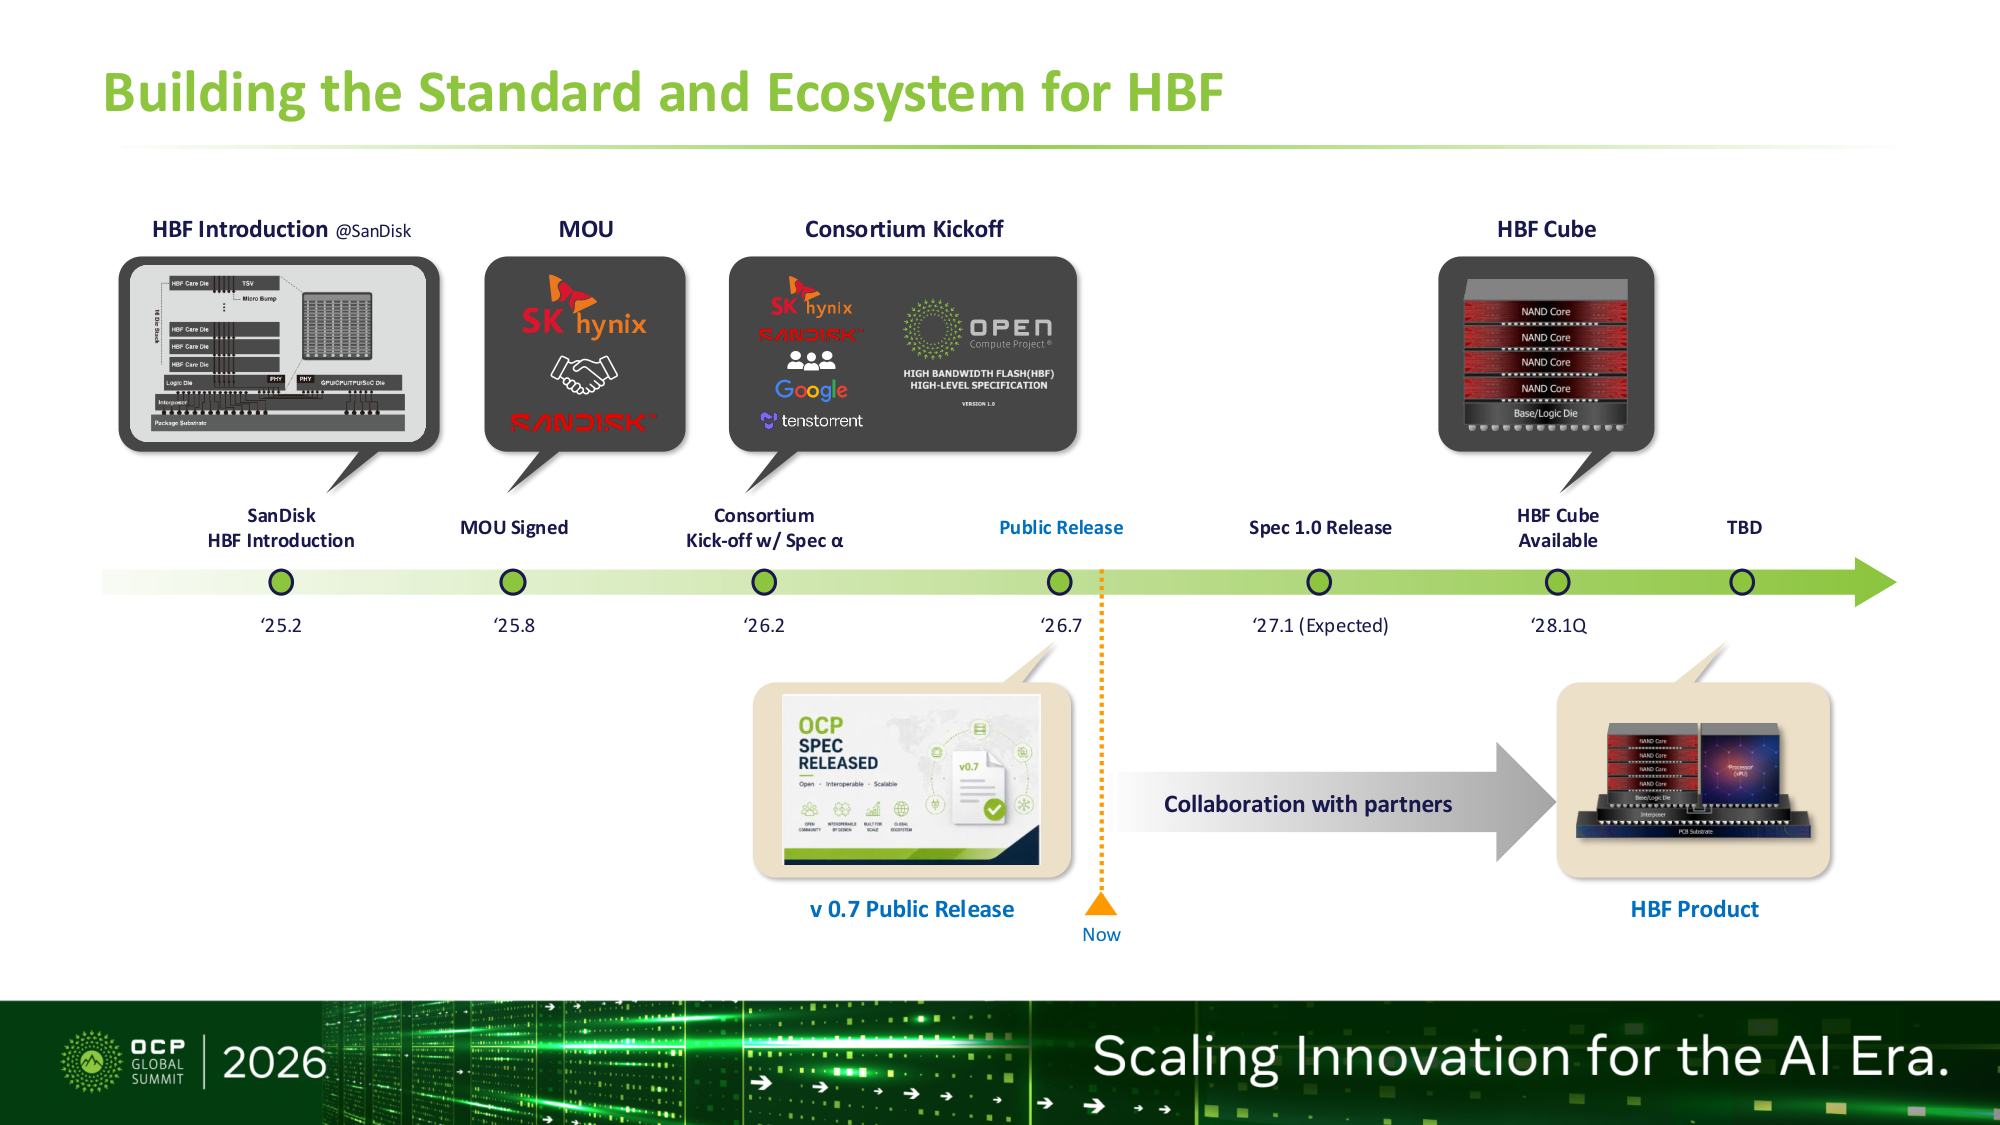
圖說(SK hynix 簡報 p17):HBF 標準化時程,2025.2 SanDisk 發表 HBF、2025.8 與 SanDisk 簽 MOU、2026.2 OCP 聯盟啟動、2026.7 v0.7 公開、2027.1 Spec 1.0(預期)、2028.1Q HBF Cube 可取得;來源 報告_OCP2026_SK海力士_MARS記憶體中心機櫃_20261015。
各層分類與口徑
| 來源 | 分層 | 備註 |
|---|---|---|
| Samsung(video_OCP2026_Samsung_代理記憶體分層KVCache_20261015,2026-10) | 熱(活躍 session:HBM/本機 DRAM/CXL)、溫(system prompt、多輪歷史:TLC SSD PM1753/PM1763)、冷(文件、程式庫:PM1773 QLC、區塊/物件/HDD) | 混合媒體:同一顆 SSD 劃 SLC 分區放高耐久資料;預取使 GPU 與 flash 直傳省一跳,前段 TTFT 約 -35%(自測) |
| Marvell(報告_OCP2026_Marvell_XPU級可組合記憶體Fabric_20261015,2026-10) | G1 HBM、G2 DRAM(1–2TB)、G2.5 CXL(數十 TB、百 ns)、G3 SSD(µs 級、數十 TB)、G4(數百 TB) | 自測:Llama-3.1-8B、H200、16 users,SSD TTFT 4,243ms 對 CXL 1,199ms、DRAM 2,162ms、HBM 重算 5,933ms;SSD 慢 CXL 約 3.5x,僅小模型前提 |
| Micron(報告_OCP2026_Micron_KVCache卸載分層記憶體模型_20261015,2026-10) | 兩族群:system prompt 層(重用 40–60%/數小時,容量導向)、session 層(重用 ≥95%/數分鐘,頻寬關鍵) | 解析模型加 GH200 驗證,非 CXL 或 SSD 實測 |
| Samsung 2030 願景(報告_OCP2026_Samsung_2030推論資料中心記憶體Pod_20261015,2026-10) | 十層 L0 SRAM 至 L4 TLC/QLC;zNAND-O 與 CXL Pool 同在 L2.5,KV SSD 在 L3,Ethernet SSD 在 L3.5 | 僅定性量級,無規格與年份;zNAND-O 被放在資料中心 context 層(GS 稱鎖定手機/PC,口徑有別) |
SSD 能否追上記憶體
- SK hynix 儲存場(報告_OCP2026_SK海力士_儲存作為LLM效能層_20261015,2026-10):vLLM 0.9.1+LMCache、H100、PCIe Gen5 NVMe。未優化 1→4 顆 SSD 的 TTFT 為記憶體基線 1.26–1.92x;調 LMCache chunk size 加 io_uring 後 1.07–1.14x;ShareGPT 多輪下與 DRAM 吞吐差 -3% 至 +5%。條件為 100% 命中微基準與 ShareGPT。
- 同廠 MARS 長 context 實驗:Remote SSD 33.56s 對 CXL DDR 15.45s(約 2.2x);Marvell 自測 SSD 慢 CXL 約 3.5x。
- 判讀:SSD 只在高命中、深度調校、小模型微基準下接近 DRAM,長 context 仍落後 CXL;不是矛盾,但不可寫成「SSD 已足夠」。
耐久:寫入設計而非單純容量
- SK hynix 估 Qwen3-14B(10 分鐘 TTL)每 GPU KV 工作集約 781GB、每日寫入最多約 57.5TB;滿足耐久的最小容量為 SLC 0.29TB、TLC 14.4TB、QLC 28.8TB;過度配置(OP)可降 TLC 至 4.8TB,ZNS 可降 QLC 至 8.8TB(單一 14B 模型推算,不宜外推大模型)。稱部分企業級 SSD 達不到所需 DWPD,並呼籲 OCP 評估 FDP、ZNS、KV SSD。
- Samsung 高擴展記憶體場(video_OCP2026_Samsung_高擴展記憶體_20261015,2026-10):KV 與 agent 需 DWPD 3+,QLC 單獨撐不住;FDP 使 WAF 由 3–4 降到 1,Lustre 多租戶混合負載實測 3.4→1.1;PM1773(E3.S、16–256TB、0.6 DWPD);Gen6 PM1763 28GB/s。另稱 NVIDIA CMX 為平台廠定義的新快閃 KV 層、每 GPU 16TB(字幕口述)。
- Meta QLC 場(報告_OCP2026_Meta_QLC儲存_20261015,2026-10):QLC 定位 TLC 與 HDD 之間的 warm 層;WAF 3–5x 使耐久僅 TLC 的 20%;NVMe Placement ID 使有效 DWPD 0.17→0.96(測試條件未載)。
- 三場一致:FDP/ZNS/資料放置是共同解法,詳見 技術_FDP與SSD資料放置。Meta 簡報只確認已導入 QLC、供應緊、品質差異大,未給導入比例與採購量,不能引為上文「Microsoft、Google、Meta 追加 QLC 訂單」的量化佐證。
Micron 容量閘控
有效重用率 γeff=γworkload×min(1, S/W)(S 為該層容量、W 為工作集)。GH200(Llama 3.1-70B FP16、ISL/OSL 30K/128、3.8 req/s)實測重用率 0.1→1 時 TTFT 60.10→5.77 秒;容量約 400GB 起重用率飽和(讀圖估值),並行 64 時崩落、TTFT 升一個數量級。對 NAND/SSD 的含意:容量買不到門檻等於無效(建模,單一來源)。
SK hynix MARS 補充
- MARS 實測(SK hynix 自測,硬體配置未載):KV Cache 取代重算,TTFT 平均 80.76→15.45s(CXL DDR)、Hybrid 21.92s、Remote SSD 33.56s,標示 3.5–5.2x(報告_OCP2026_SK海力士_MARS記憶體中心機櫃_20261015,2026-10)。
- HBF 峰值批次:HBF 卡(3TB,對 Base 卡 288GB)tokens/user 在 batch 8 達峰 19M,batch 1 略低、batch 16 約 9M、batch 64 約 1.2M(Raw_data 圖片清單 p16 所見;簡報摘要曾寫 batch 1 約 19M,以圖為準)。
- 容量口徑:SK hynix 稱 HBF 容量 14x 是卡級(3TB 對 288GB),GS 的 36 對 512GB 是堆疊級,口徑不同不互相覆蓋。
關鍵廠商
見上表;台廠端以 8299_群聯(市)(Enterprise SSD 控制器與模組,貨源策略與 Enterprise 營收占比由 1H26 的 38% 提高至 2027 年預估 47%)為主要追蹤標的,供需背景見 分析_記憶體超級週期_AI推論與排擠效應_凱基專題_20261001。FDP/遙測等 SSD 耐久設計對控制器的門檻見 技術_FDP與SSD資料放置(簡報未點名控制器廠,台廠含意為推論)。
技術瓶頸 / 風險
- 量產時程在 2028 年後,可能被 CXL 記憶體池、HBM 架構演進等其他方案分流(見 技術_CXL、技術_HBM)。
- 壽命結論來自單一研究引述,缺獨立驗證。
- GS(2026-10-12)列舉的障礙:HBM4E 頻寬領先、寫入與讀寫比不確定、耐久與散熱、製造成本約為傳統 NAND 的 3-4 倍,詳見上方「採用挑戰」。
- 凱基部分為珩石同事筆記轉述(未取得報告原檔),GS 部分為原始報告(影像 PDF,OCR 後核對);數字有疑義處見 報告_GS_HBF高頻寬快閃記憶體_20261012 的 OCR 備註。
來源
- 報告_OCP2026_SK海力士_MARS記憶體中心機櫃_20261015、報告_OCP2026_SK海力士_儲存作為LLM效能層_20261015、video_OCP2026_Samsung_代理記憶體分層KVCache_20261015、video_OCP2026_Samsung_高擴展記憶體_20261015、報告_OCP2026_Samsung_2030推論資料中心記憶體Pod_20261015、報告_OCP2026_Meta_QLC儲存_20261015、報告_OCP2026_Micron_KVCache卸載分層記憶體模型_20261015、報告_OCP2026_Marvell_XPU級可組合記憶體Fabric_20261015 — OCP 2026 峰會(2026-10-12~15)KV 分層、SSD 耐久、HBF 時程
- 報告_MS_OCP峰會2026_20261013 — Morgan Stanley,2026-10-13;OCP 2026:SK hynix MARS 共享 KV Cache(TTFT 3-5 倍)、HBF 約 1/2 HBM 頻寬與 14 倍容量、樣品 2028 年初
- memo_記憶體_凱基超級週期專題_20261001
- 報告_GS_HBF高頻寬快閃記憶體_20261012 — 高盛(GS),2026-10-12;HBF 規格、H3 混合架構、成本效益(-30%)、TAM US$40-150bn、XL-Flash/zNAND-O 替代路線與五家原廠評等
- memo_記憶體_凱基記憶體牆難解_珩石Niuniu_20261001 — 凱基講座版,同場交叉校正(CMX 採用者 Meta/Oracle/xAI、XL-Flash 與 HBF 時程) — 珩石同事筆記轉述凱基記憶體專題,2026-10-01