PDF 原檔:web_Damnang_記憶體客製晶片轉型_20260709_original.pdf
校正紀錄
本檔為韓文原文的機器翻譯 PDF,經 pdf_parse 抽出後落地前已校正下列翻譯/OCR 誤植;未列出者為原文。
- 全文以 NFKC 正規化:PDF 字型把大量漢字輸出成康熙部首碼(⼯/⼾/⽽/⼀…),已還原為一般漢字,否則全庫搜尋無法命中
MOQ/MOG/MOL/MOLLE/MOLogic/Module-On-Logic→ Memory-on-Logic(同一概念被機翻拆成六種寫法)chHBM→ cHBM- 「血腦膜」→ HBM(HBM 被誤譯為 Blood-Brain Membrane 再回譯)
- 「記憶電池」→ 記憶體(memory 誤譯)
- 「骰子堆最底下的一顆骰子」→ die 堆疊最底下的一顆 die(dice 誤譯)
- 「佐治亞理工學院」→ 喬治亞理工學院;「英偉達」→ NVIDIA(大陸譯名)
- 「比特/位」成長 → 位元成長(bit growth)
- 「鍵結」→ 鍵合;「中間層佈線」→ 中介層佈線
- 作者署名「達姆南」為 Damnang 的音譯,保留原文
- 未校正:文中「記憶體邏輯一體化」「邏輯上記憶體」「邏輯記憶體」三種說法並存,均指 Memory-on-Logic,語意明確故保留原話
圖片清單(已驗證 2026-08-25)
| 檔名 | size | 分類 | 親眼所見內容 |
|---|---|---|---|
web_Damnang_記憶體客製晶片轉型_20260709_001.png |
507KB | 裝飾·banner | AI 生成封面插圖:左「COMMODITY MEMORY PRICES/OLD MEMORY CYCLE」鋸齒折線→「RE-RATING VALUE」上升箭頭,中央「STACKED MEMORY (HBM/DRAM)」疊在「CUSTOM LOGIC CHIP」上,右標題「MEMORY-ON-LOGIC: RE-RATING MEMORY BEYOND THE CYCLE / THE TRANSFORMATION INTO A CUSTOM SILICON COMPANY」 |
web_Damnang_記憶體客製晶片轉型_20260709_002.png |
271KB | 真資料圖 | 三段結構對比:HBM(GPU/Compute Die ↔ 2,048-bit ↔ DRAM x8-16 + Base Die,同置 Silicon Interposer,"Memory beside compute (2.5D)")→ cHBM(Base Die 改為橘色 "Custom Base Die (customer logic)","Customer logic enters the base die")→ Memory-on-Logic(DRAM x8-16 以 TSV/hybrid bonding 直接疊在 Compute Die 上,無中介層,"Memory stacked directly on logic (3D)") |
web_Damnang_記憶體客製晶片轉型_20260709_003.png |
303KB | 真資料圖 | HBM 2.5D 剖面詳圖:左 GPU/Compute Die 邊緣的 PHY → 2,048-bit interface 穿過中介層 → 右側 DRAM core die (x8-16) 堆疊(TSV 貫穿)+ 底部橘色 Base Die (control, I/O, test logic),全部落在 Silicon Interposer 上 |
web_Damnang_記憶體客製晶片轉型_20260709_004.png |
309KB | 真資料圖 | cHBM 剖面圖:GPU 側縮為 "smaller PHY (serialized link)"、留白處標 "freed area → more compute";中間 "narrow custom die-to-die link";右側橘色 Custom Base Die 內含三塊 —— Custom D2D Interface/Memory Controller (moved from GPU)/Customer Logic (compression / preprocessing);DRAM core die 標註 (unchanged)。底注 "Same 2.5D layout, but the base die now carries the customer's logic" |
web_Damnang_記憶體客製晶片轉型_20260709_005.png |
431KB | 真資料圖 | Memory-on-Logic 真 3D 結構:六層 DRAM stack 直接疊在橘色 Compute Die (GPU) 上,TSV / hybrid bonding 標註「tens of thousands to hundreds of thousands of connections, ~tens of micrometers」;紅色熱流箭頭 + 溫度計圖示標 "Heat is the key unsolved problem"。底注 "Interposer removed. Memory stacked directly on the compute die (true 3D)" |
web_Damnang_記憶體客製晶片轉型_20260709_006.png |
422KB | 真資料圖 | Qualcomm HBC 結構:LPDDR stack 以 TSV 疊在橘色 "Near-Memory Accelerator (dedicated, low power)" 上,右側 SoC 並排,兩者同置 Organic Substrate;右上兩個禁止符號標 "no silicon interposer"、"no CoWoS";左標 "low-power accelerator + LPDDR → fits thermal budget" |
web_Damnang_記憶體客製晶片轉型_20260709_007.png |
289KB | 真資料圖 | 收入結構四階段流程圖,左半 "PRICED IN — what the market already models":Commodity DRAM(Revenue = bit growth × ASP/價格波動直接進獲利/議價權在客戶/週期股標籤,每次谷底 de-rating)→ HBM + LTA (today)(2026 產能售罄 SK hynix, Micron/LTA 成標準、預付款 $540M–770M/Micron FY26 Q1 營收 $13.6B +57% YoY/毛利率 22% → 50%+);右半 "NOT YET PRICED IN":cHBM(規格與量提前 2–3 年鎖定、backlog-like/首度出現 NRE 收入/lock-in 綁客戶設計、換供應商=重新設計/溢價上限打開,HBM 已是 DDR5 的 5–6 倍)→ Memory-on-Logic(賣整合子系統而非元件/bonding、yield、final test 各成新收入線/封裝價值鏈利潤待重新談判/服務型收入占比上升) |
web_Damnang_記憶體客製晶片轉型_20260709_008.png |
814KB | 真資料圖 | 投資框架總表「Memory Beyond the Cycle」四段:1 空方論點與其誤讀(積極擴產+中國進入/2027-28 供給趕上需求/價格下滑、de-rating;隱含假設 "every bit is interchangeable")vs 右側橘框 "What that reading misses"(客製產能不會流入現貨市場/LTA+預付款把風險移轉給客戶/2028 正是客製量能反映到獲利的年份/屆時賣的記憶體已是不同產品);2 四個追蹤指標(① 混合鍵合設備訂單 ② cHBM base die 的代工投片量 ③ 三大廠邏輯設計人才招募 ④ 散熱管理進展);3 時間錨點(2027 年中 Qualcomm AI250 發表/2028 NVIDIA Feynman 採用 cHBM/2028 AI300 搭 HBC Gen2 送樣);4 三種情境(Memory-on-logic 成主流/收斂在 cHBM/維持利基)+共同結論 "Companies paid at the memory-logic boundary, bonding, test, thermal, design services" |
web_Damnang_記憶體客製晶片轉型_20260709_009.png |
819KB | 真資料圖(與 _008 重複) | 與 _008 為同一張投資框架總表,解析度略高;lib 頁擇一嵌入即可 |
原始內容
RE-RATING
VALUE
VALUE
邏輯記憶:超越週期重新評估記憶
當記憶體公司轉型為客製化晶片公司時
達姆南
2026 年 7 月 9 日 已付費 PAID
分享
A CUSTOM SILICON COMPANY
THE TRANSFORMATION INTO
ADVANCED
MANUFACTURING
場和近期多份報告都對記憶體持悲觀態度。其論點是, 2027 年和 2028 年 前後新增的產能將使供應趕上需求,價格將回落,隨後正如以往週期性規 律所預測的那樣,出現降息。
我不同意這種觀點。
悲觀觀點仍然將記憶體視為一種商品,但支撐這一假設的技術格局正在改變。追蹤記憶 體產業在工程層面的結構性轉變,就會發現,週期頂峰論所依賴的「無論誰生產,標準 部件都一樣」的前提,對於未來的記憶體產品而言,正變得越來越不適用。
STACKED
MEMORY
(HBM/DRAM)
RE-RATING
AR TRA
MEMORY IS NO LONGE
A CYCLICAL INDUSTR
GPU /
Compute Die
Silicon Interposer
Memory beside compute (2.5D)
HBM
CHBM
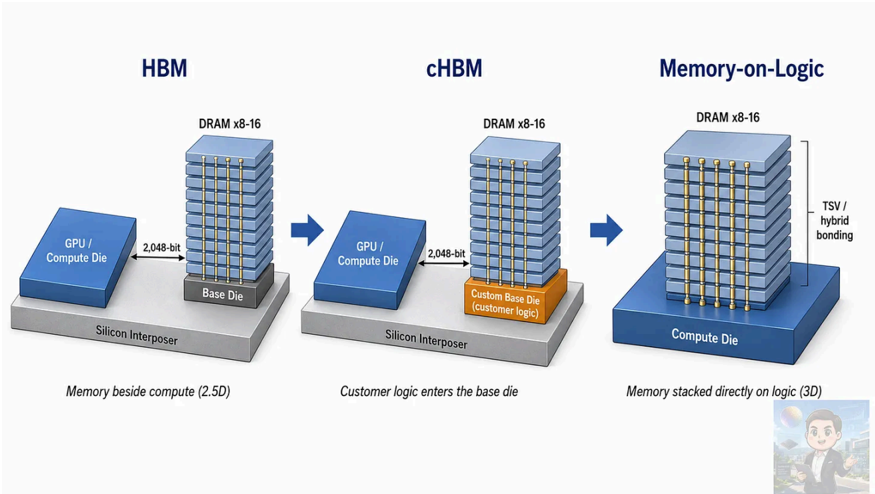
Memory-on-Logic
這轉變的核心是 HBM 基片。
基礎晶片進入邏輯工藝,客戶電路進入其中( cHBM ),最後記憶體直接位於客戶的計 算晶片之上(邏輯上記憶體)。
我預計,在這一發展進程的最終階段,記憶體公司將從通用晶片製造商轉向客 製化晶片 合作夥伴 ,而記憶體公司目前的趨勢也指向這一方向。本文將深入探討技術背景、整個 產業正在發生的實際變化,以及這種變化對記憶體收入結構和估值的影響。讀完本文, 您將明白我為何依然看好記憶體產業,以及這種看好為何基於記憶體業務本身結構的轉 變。
目錄
- HBM 、 cHBM 和邏輯記憶體,這三種結構有所區別。
- 從 cHBM 到邏輯記憶體,這是產業發展的順序。
- 矽谷聽到了什麼
- 記憶體收入結構如何變化
- 從投資角度來看,應該關注哪些面向︖
記憶體股漲勢會持續嗎?
達姆南 · 5 月 12 日
閱讀完整報道
記憶體產業已不再是週期性產業。
達姆南 ·
3 月 25 日
閱讀完整報道
免責聲明
本文中的數據和時間軸均來自公司公告、公開報告和已發表的論文。對這些數據的解讀 和本文表達的觀點完全是我個人的分析,並不構成對任何特定證券的買賣建議。投資決 策及其後果的責任完全由投資者自行承擔。 PHY (x8-16)
GPU / Compute Die
PHY
1. HBM 、 cHBM 和邏輯記憶體,這三種結構有所區別 HBM
HBM (高頻寬記憶體)堆疊 8 、 12 或 16 個 DRAM 晶片,並透過 TSV (矽通孔)垂直連 接。堆疊底部是基片,它負責記憶體控制、 I/O 和測試邏輯,並作為連接 DRAM 堆疊與 外部世界的網關。最終的 HBM 堆疊放置在 GPU 旁的矽中介層上,並透過中介層的佈線 與 GPU 連接。堆疊本身是三維的,但由於它與 GPU 並排放置而不是在其上方,因此這 種結構被稱為 2.5D 。在 HBM4 中, GPU 和堆疊之間的介面寬度為 2048 位,這些訊號從 GPU 晶片邊緣的 PHY 層發出,穿過中介層的佈線,然後進入基底。
上述 DRAM 核心晶片的結構基本上固定,因為儲存資料的電容陣列佔據了其大部分面 積,所以堆疊結構中唯一承載邏輯的層是位於最底層的基礎晶片。 GPU 和記憶體之間 傳輸的每個位元組都必須經過這一層,這使得基礎晶片的處理能力決定了整個堆疊結構
TSV
的頻寬和能效,而且這一負擔隨著每一代技術的迭代而增加。介面位從 HBM3 的 1024 位 翻了一番,達到 HBM4 的 2048 位,單腳速度也隨之提升,訊號處理、通道管理和電源管 理的複雜度也隨之增加。 narrow custom die-to-die link DRAM core die
(unchanged)
因此,記憶體公司在提升 HBM 效能時,先著手改進基礎晶片,而改進的出發點正是製 造基礎晶片的製程。在 HBM3E 及之前的版本中,基礎晶片採用與更高層級 DRAM 晶片 相同的 DRAM 製程製造。 DRAM 製程專為高電容密度而設計,因此在其上建構邏輯電 路會導致晶片體積更大、速度更慢,而同樣的邏輯電路則採用邏輯製程製造。基礎晶片 需要處理的工作量逐代增加, DRAM 製程無法滿足需求,因此從 HBM4 開始,基礎晶片 開始轉向邏輯製程製造。 freed area to base die D2D Interface (moved from GPU) (compression / preprocessing)
SK 海力士採用台積電的 12nm 製程製造,三星採用自家代工廠的 4nm 製程製造,而美 光出於成本考慮,一直沿用其現有的 DRAM 製程製造 HBM4 晶片,併計劃從 HBM4E 過渡到台積電的邏輯製程。
即使製程發生了變化,該基礎晶片的設計仍然屬於記憶體公司,且該產品仍然是符合 JEDEC 規範的標準部件。
cHBM
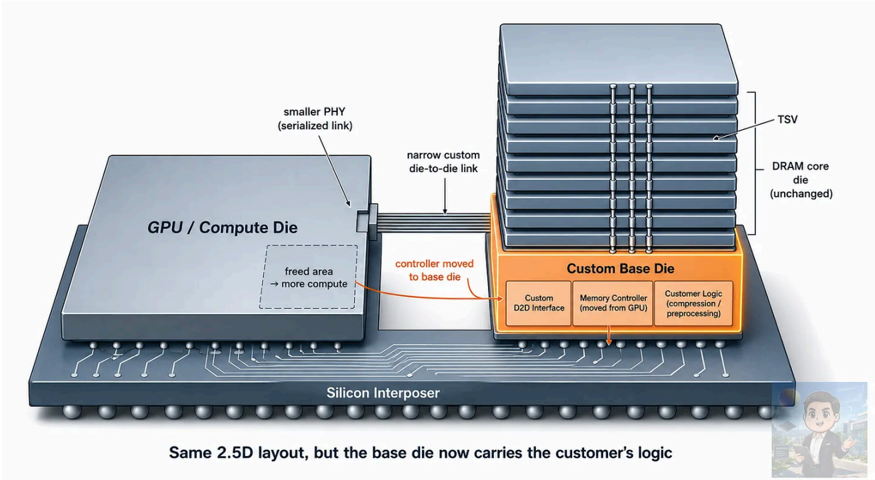
將基礎晶片製程改為邏輯製程並不能解決 HBM 結構本身固有的問題。 GPU 晶片的運算 面積長期不足,而這有限的面積又被 HBM 介面和記憶體控制器等資料傳輸電路佔據。
這就是 cHBM (自訂 HBM )概念的由來。
其概念是將 GPU 側與記憶體通訊的電路下移到基體晶片上,而基體晶片本身就位於記憶 體堆疊的正下方。這樣, GPU 就可以將釋放出來的空間用於計算,而與記憶體相關的邏
輯則直接運行在資料儲存的下方。在同一位置進行預處理或壓縮,可以減少需要傳輸到 GPU 的資料量,從而節省功耗。
問題在於, JEDEC 標準的基礎晶片是所有客戶的通用標準,因此無法針對特定客戶的 架構進行這種重新定位。換句話說, cHBM 是一種偏離標準、客製化設計基礎晶片以建 構 HBM 的方法。順便一提,業界有時將遵循標準的傳統 HBM 稱為 sHBM (標準 HBM )。
設計 cHBM 基礎晶片的方法有很多種。從記憶體公司根據客戶的規格進行設計,到 ASIC (專用積體電路)合作夥伴(例如 Marvell )與三家記憶體製造商共同定義基礎晶 片,再到客戶直接設計基礎晶片邏輯(例如 NVIDIA 的做法)。
無論採用何種形式,記憶體堆疊和邏輯電路都必須作為一個整體運行,客戶的設計規範或 電路都會進入基礎晶片,因此雙方別無選擇,只能坐在一起,從設計的最初階段就定義 規範。
將客戶電路的一部分設計到基礎晶片中意味著什麼︖
這意味著長期以來被視為商品的記憶體商業模式從此開始轉變。搭載客戶客製化電路的 HBM 是該客戶的專用部件,不能出售給其他供應商︔而對於客戶而言,嵌入自身電路 的記憶體也難以輕易替換為其他供應商的產品。從 cHBM 開始,只要規格匹配,任何零 件都可以互換的商品化前提不再成立。
邏輯記憶體
DRAM stack
TSV /
hybrid bonding tens of thousands to
hundreds of thousands of connections,
~tens of micrometers
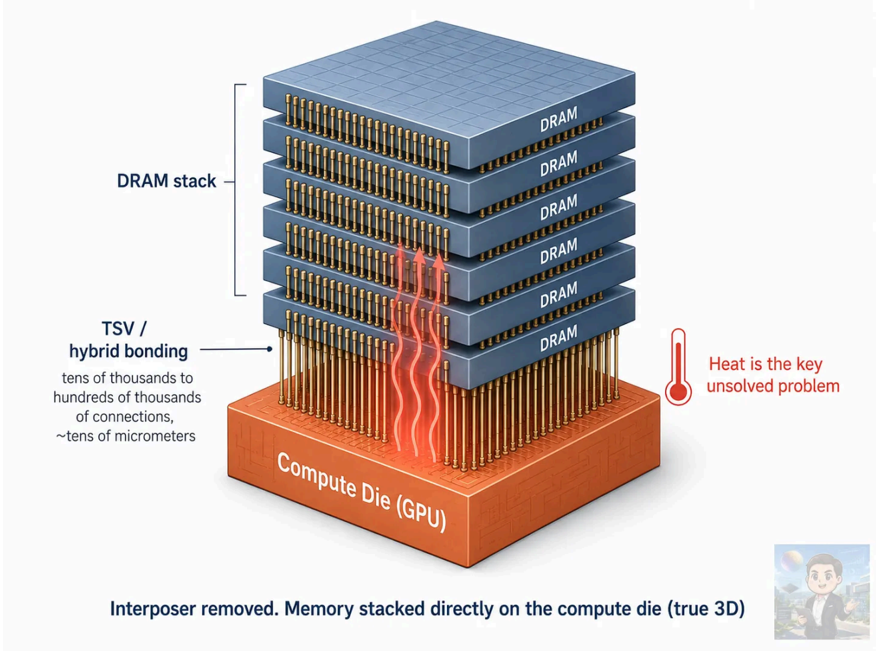
到了 cHBM 階段,基礎晶片看起來不再像是用於管理記憶體的晶片,而更像是客戶的 邏輯晶片。介面屬於客戶,控制器也屬於客戶,剩餘區域的功能也屬於客戶。這就引出 了一個新問題:還有必要建造一個單獨的基礎晶片嗎︖為什麼不把真正的 GPU (計算 晶片)放在基礎晶片的位置,然後直接在其上方堆疊內存呢︖這種結構就是「邏輯上記 憶體」( Memory-on-Logic )。計算晶片承擔了基礎晶片的所有功能,中介層消失了, 記憶體堆疊以 3D 形式直接堆疊在計算晶片之上。
此時,連結的物理條件發生了變化。 HBM 堆疊和 GPU 不再透過 2048 位元邊緣介面連 接,而是連接點遍佈整個鍵合介面。諸如 TSV 和混合鍵合等垂直鍵合方法將連接密度 從數萬個提升到數十萬個,訊號傳輸距離也從中介層佈線的毫米級縮短到垂直方向的幾 十微米。
頻寬變化幅度可達一個數量級,傳輸位元所需的能量也隨之變化。喬治亞理工學院和 SK 海力士在 2025 年發表的一篇論文分析了一個基於邏輯記憶體的結構,該結構能夠實現 2.5D 架構 64 倍的吞吐量和 3 倍的能源效率。這些數據是學術模型,不能完全照搬,但它 們很好地說明了效能提升的方向和幅度。
記憶體邏輯一體化( Memory-on-Logic )技術尚未解決的問題是散熱。 將 DRAM 晶片放置在功耗高 達數百瓦的運算晶片之上, DRAM 會阻礙運算晶片的散熱路徑,同時自身也會吸收熱 量。 DRAM 對溫度非常敏感,高溫會導致其刷新週期縮短,從而降低效能。最終,如 何解決散熱問題很可能成為決定記憶體邏輯整合技術成敗的最關鍵因素。
故事目前為止並非從整個 HBM 開始,而是從die 堆疊最底下的一顆 die開始。
此基礎晶片從 DRAM 製程轉移到邏輯製程 (HBM4) ,客戶邏輯晶片轉移到其中 (cHBM) ,最後基礎晶片的位置被客戶的運算晶片 ( 邏輯記憶體 ) 取代。
然而,這種發展趨勢並非線性的世代更替。在未來幾年內, cHBM 是最現實的商業化路 徑,而邏輯記憶體( Memory-on-Logic )則是一種更激進的架構,只有在散熱和良率問題解決後才 能成為主流。這兩種架構並非立即相互取代,而是可能會並行發展一段時間,具體取決 於客戶的功耗預算、工作負載和封裝成本。
基礎晶片越接近客戶的晶片,記憶體業務就越接近客製化晶片業務,而且 …
我認為這正是市場尚未真正理解記憶體業務成長潛力的關鍵 。
這三家記憶體製造商的估值仍被視為週期性股票,其股價波動主要受位元成長和平均售 價( ASP )的影響。客製化轉型帶來的營收和利潤結構變化尚未在已公佈的財務數據中 體現,因此也未能反映在估值模型中。由此可見,此變革意義重大,下文將詳細闡述其 商業模式和營收結構的具體變化。
2. 從 cHBM 到邏輯記憶體,這是產業發展的順序
cHBM 已出現在產品路線圖中。儘管 NVIDIA 尚未正式確認細節,但 cHBM 的應用在 計劃於 2028 年推出的 NVIDIA Feynman 世代產品中不斷被提及,因此與其說是既定事 實,不如說是該代產品的關鍵關注點。三星、 SK 海力士和美光都已將客製化 HBM 列 入其官方路線圖,而 Marvell 也宣布正在與這三家記憶體製造商共同開發客製化 HBM 架構。客戶定制晶片取代標準晶片的進程已經進入執行階段。
當 cHBM 確定路線圖時,下一階段 --邏輯記憶體 --已經形成了自己的方案,並公 佈了生產時間表。
這就是高通的 HBC (高頻寬運算),該公司在 2026 年 6 月的投資者日上發布了這項技 術。
目前該產品尚未上市。搭載第一代 HBC 晶片的 AI250 加速器計畫於 2027 年年中發 布,第二代 HBC 晶片則在後續產品路線圖中。 HBC 屬於邏輯記憶體 (Memory-on-Logic) 系列,但 其記憶體採用的是低功耗 DDR (LPDDR) 而非 HBM ,且位於堆疊結構下方的晶片是一 個專用的近記憶體加速器,而非 GPU 本身。
LPDDR stack - low-power
accelerator + LPDDR
→ fits thermal budget no silicon
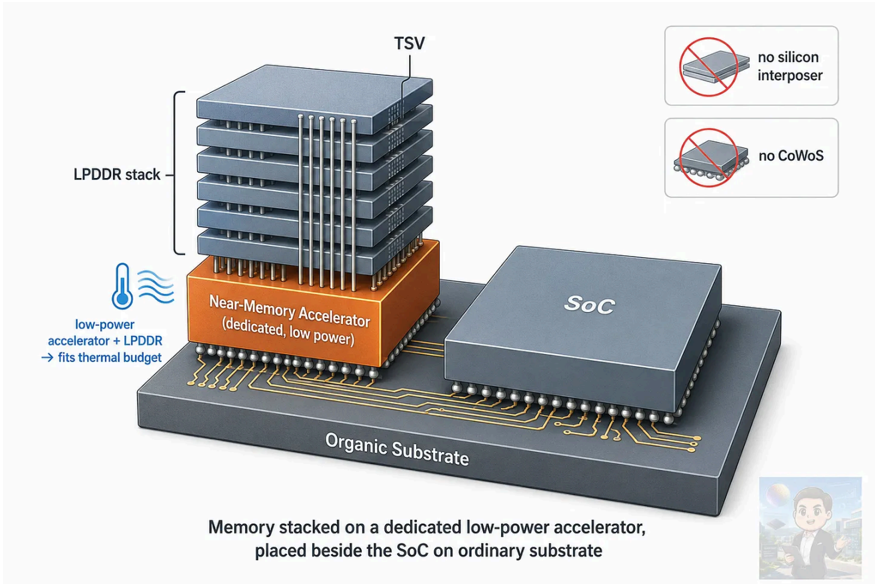
考慮一下這種結構。高通將 AI 加速器與 SoC 分離。它在分離的加速器晶片上堆疊了一層 LPDDR 內存,並透過 TSV 將兩者連接起來。這個 HBC 單元和 SoC 並排放置在普通的有 機基板上。沒有矽中介層,也沒有採用 CoWoS 等 2.5D 先進封裝技術。這種設計旨在同 時解決兩個瓶頸問題: HBM 供應短缺和先進封裝產能不足。
高通選擇 LPDDR 記憶體是出於容量和功耗的考量。 LPDDR 是一種低功耗 DRAM 系 列,因此每個記憶體堆疊的功耗很低,並且便於容量擴展。高通針對邏輯晶片上記憶體 發熱問題的方案就在於此。它沒有採用發熱的 GPU ,而是在 GPU 下方放置了一個低功 耗的專用加速器,並且記憶體也使用了低功耗的 LPDDR ,從而使整個系統的散熱性能 符合預算。
高通聲稱其每瓦頻寬是 HBM 的六倍,每瓦容量是片上 SRAM 的 200 倍。這些數據需 要詳細的白皮書和實際硬體驗證,但客戶方面已經出現了行動跡象。
沙烏地阿拉伯的 Humain 公司已將搭載 HBC Gen1 的 AI250 機架納入其部署計畫。據報 道,微軟執行長納德拉也曾表示將在 Azure 資料中心部署高通 HBC 。這款產品距離正式 發布還有一年時間,就已經吸引了大型基礎設施客戶和超大規模資料中心營運商的關 注,這本身就足以證明市場對這種架構的需求。
高通並不是唯一一家致力於將記憶體整合到邏輯電路中的公司。
有報導稱, SK 海力士自 2023 年以來一直在與包括 NVIDIA 在內的幾家無晶圓廠公司 討論將 HBM 直接堆疊在處理器上的方法,同時也提出了一種使用台積電晶圓鍵合技術 將記憶體鍵合到邏輯晶圓上的製造方法。
TSV
台灣 ASIC 設計公司 GUC 提出了 DoL ( DRAM-on-Logic ,邏輯上 DRAM )技術,即將一 到四層 DRAM 放置在邏輯層之上。至於最上層是 LPDDR 還是 HBM 式 DRAM 堆棧,以及 最下層的邏輯層是專用加速器還是 GPU 本身,則因具體情況而異,但方向始終相同:內 存層逐漸靠近邏輯層,最終覆蓋在邏輯層之上。
如前所述,記憶體位於邏輯電路之上,這意味著記憶體與特定客戶的晶片融為一體。
從 cHBM 到邏輯記憶體的演進過程中,記憶體業務逐漸轉變為 客製化晶片業務 ,而矽 谷最近聽到的消息表明,這種變化已經在組織層面開始了。
那麼從投資角度來看,什麼才是最重要的呢︖
記憶體公司向客製化晶片公司轉型,這種轉變將如何改變它們的收入結構,利潤在供應 鏈中的流向,以及應該透過哪些指標來追蹤這一進程,這些都是需要關注的重點。下文 將對此進行詳細闡述。
Damnang Substack 物。如果您想接收新文章並支持我的創作,請考
3. 矽谷聽到了什麼
還有一點證據表明,邏輯記憶體確實是一種趨勢。
矽谷半導體產業最近傳出消息,一家韓國大型記憶體製造商正在聖荷西組建一個數百人 戶專案的前瞻性投資,而非單純的探索性機構。原因在於,邏輯記憶體技術要求客戶的
的團隊,專門負責邏輯記憶體( Memory-on-Logic ,簡稱 Memory-on-Logic )業務。由於尚未有官 方公告, Memory-on-Logic 的規模和具體時間尚無法確認。但如果此舉屬實,這更像是針對特定客 運算晶片和記憶體堆疊從架構設計的最初階段就必須協同設計。
問為什麼是聖荷西,為什麼幾百人,這種說法就更有說服力了。即使如今 HBM 的客製 化內容不斷增長,但其本質上仍然是一家由韓國總部設計、客戶互動和差旅都由當地少 量員工負責的企業。由於標準配置是固定的,所以沒有必要坐在客戶旁邊。
廠
邏輯內存集成則完全不同。客戶的運算晶片和記憶體堆疊必須協同工作,因此這項工作 必須從架構定義階段就與客戶的設計團隊在同一空間內進行。而這些客戶,包括 GPU 商和超大規模資料中心的內部晶片團隊,都集中在舊金山灣區。即使在矽谷,聖荷西的 勞動成本也位居前列。承擔數百人的招募成本意味著一項前期投資,並計劃透過收入來 收回成本。如果沒有已確定的客戶項目,如此規模的團隊是不合理的。
時間節點也恰到好處。隨著 cHBM 預計將於 2028 年左右應用於 AI 加速器,下一代產 品向邏輯記憶體 (Memory-on-Logic) 過渡的協同設計工作現在就必須啟動。從半導體設計週期反向 推導,相關組織架構必須在產品上市前三到四年就到位,而現在正是關鍵時刻。
的 是 一 個讀者支持的出版 慮成為免費或付費訂閱者。
How Memory Revenue Changes - from Commodity to Custom Silicon
4. 記憶體收入結構的變化
Commodity DRAM
the old formula
• Revenue = bit growth x ASP
• Price swings flow straight to earnings
• Bargaining power sits with the customer
• Cyclical label, de-rating at every trough
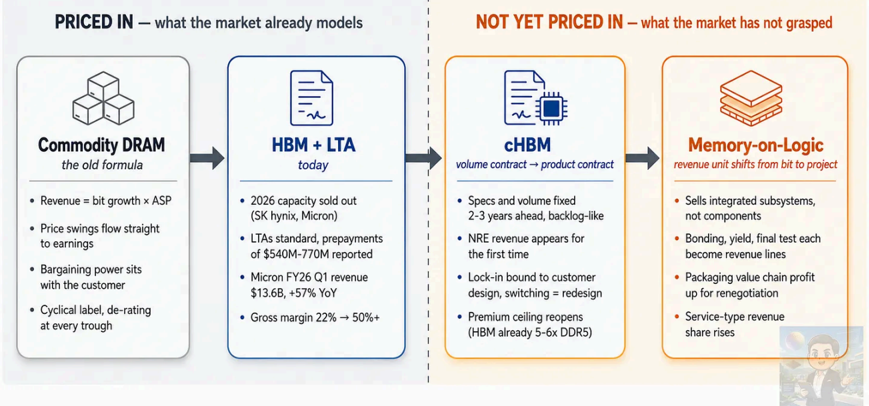
目前記憶體公司的營收模式可以歸結為位元成長率乘以平均售價。他們批量生產標準規 格的晶片,價格隨供需平衡波動,而這種波動直接影響到收益。客戶可以從三大廠商中 的任何一家購買相同規格的產品,因此議價能力在結構上一直掌握在客戶手中。 「週期 性產業」的標籤,以及每次週期低谷時出現的估值下調,都是由這種結構造成的。
HBM 的出現已經大大改變了這一格局。 SK 海力士在 2025 年 10 月表示,其 2026 年的 DRAM 、 NAND 和 HBM 產能已全部售罄,現在簽訂 HBM 合約的客戶將收到 2027 年交付 的產品。美光科技也在 2025 年 8 月發出訊號,表示 2026 年的 HBM 產能已售罄。
合約結構也在不斷演變。長期協議( LTA )承諾年度採購量,已成為業界標準。美光採 用的是一種名為戰略客戶協議( SCA )的結構,該結構將採購量承諾與價格上限相結 合。但有報導稱, SK 海力士採用了一種取消價格上限的結構,使市場價格上漲直接反映 在合約價格上。另有報告稱,NVIDIA為確保 HBM 的採購量,分別向 SK 海力士和美光預 付了 5.4 億至 7.7 億美元的款項。
產能售罄、預付款和多年期合約的綜合效應已經反映在盈利中。美光 2026 財年第一季營 收為 136.4 億美元,年增 57% ,毛利率從 2024 財年的約 22% 上升至 50% 以上。
即便如此, HBM 目前仍屬於標準零件範疇。 JEDEC 規範依然存在,而且三家製造商 的產品一旦通過認證即可互換的前提仍然有效。長期協議本質上是一份關於數量和價格 的合同,而不是關於產品本身的合約。合約期滿後,客戶可以將訂單轉移到其他供應 商,而且認證競爭實際上每一代都會重複發生。目前的售罄狀態和價格強勢是由供應短 缺造成的,因此,一旦產能成長趕上需求,這種商品的市場壓力就會再次顯現。
cHBM 將這份合約的性質從批量合約轉變為產品合約。與客戶共同設計基礎晶片需要提 前兩到三年確定規格和數量,因此該合約的性質與邏輯 ASIC 公司的訂單積壓非常相
→
HBM + LTA
CHBM
Memory-on-Logic
似。收入項目也隨之增加。用於收回設計合作中投入的工程成本的非經常性工程 (NRE) 收入首次出現,定價也從跟隨市場波動轉變為基於設計成本和價值的談判。
鎖定機制的層級也發生了變化。標準 HBM 的鎖定機制僅限於資質認證和產能預留層 面,而 cHBM 的鎖定機制則與客戶本身的設計緊密相關,因此更換供應商需要重新設 計。這種結構從合約到期意味著談判一切從頭開始,轉變為沿用現有設計反而提高了贏 得下一代合約的幾率。
價格溢價空間也隨之擴大。 HBM 的價格已經是同等容量 DDR5 的五到六倍,一旦採用 客戶客製化設計,替代品就會消失,溢價上限也將再次提升。綜合三星和 SK 海力士高 層的公開言論來看,客製化 HBM 將從 2027 年開始加速發展,並極有可能在 2028 年至 2029 年左右成為 HBM 市場的重要支柱,而這種合約結構的變化也將進而改變整個 HBM 市場的格局。
在第二階段,即記憶體整合到邏輯晶片上時,收入單位本身發生了變化。一旦記憶體堆 疊透過晶圓鍵合技術與客戶的運算晶片連接起來,記憶體公司就會從銷售單一元件轉變 為銷售整合子系統。在記憶體公司的 DRAM 晶片鍵合到台積電製造的邏輯晶圓上的這種 結構中,誰負責鍵合、誰承擔良率責任以及誰進行最終測試都成為談判的議題,而每一 項都成為一項收入來源。
記憶體公司在後端獲取的價值可能會成長,或者反過來,代工廠可能會試圖吞併這部分 市場,因此封裝價值鏈上的利潤分配問題需要重新談判。無論哪種情況,設計、整合和 測試等服務型項目在記憶體公司收入中的比重都會上升,而以每位元售價為單一變數的 收入主導地位則會下降。收入的基本單位也將從位元轉移到客戶專案。
當然, ASIC 業務也有其陰暗面。
客製化意味著客戶集中。將產能分配給一個客戶專屬的設計,如果該客戶的晶片在市場 上失敗,這批晶片就無法銷往其他任何地方。這種風險在標準件時代並不存在。一旦設 計競標失敗,就意味著失去該客戶的全部下一代產品訂單。收入波動性從市場驅動轉變 為訂單驅動,但波動性本身並未消失。然而,發展方向卻很明確。邏輯 ASIC 公司的歷 史表明,基於訂單的週期在資本市場上獲得的估值倍數高於不可預測的市場週期。
5. 從投資角度來看,應該關注哪些面向?
當我審視這個主題時,我總是會回到我一直以來使用的框架,即區分已經定價的和尚未 定價的。
已包含在價格中的部分。
HBM 熱潮本身主要體現在三大記憶體廠商的股價上。客製化 HBM 即將到來這一事實也 早已是公開訊息,相關路線圖、高通 HBC 的發布、 Humain 的部署計劃以及 Azure 相關 的報道都已是市場關注的焦點。但市場定價的僅僅是這些產品和路線圖的存在。它們將 如何改變收入結構則是另一個問題。
尚未完全計入價格的因素。
首先,隨著客製化記憶體收入份額的上升,利潤率結構和倍數也會改變。目前市場仍主 要依據位元成長和平均售價來衡量三大記憶體廠商的績效。以 ASIC 晶片產業的術語,例 如非經常性工程費用收入、鎖定溢價和訂單積壓等,來解讀業績的框架尚未成為標準。 如果某季財報中首次明確揭露客製化業務的合約結構,則可能成為推動此框架轉變的契 機。
其次,利潤在價值鏈中的流動路徑也改變了。隨著邏輯記憶體( Memory-on-Logic )技術的進步, 中介層需求的成長率逐漸下降,而混合鍵合和晶圓級製程設備的需求則呈現結構性成 長。從鍵合設備到散熱解決方案再到測試設備,隨著產業鏈向上發展,利潤的流向也需 要重新規劃。
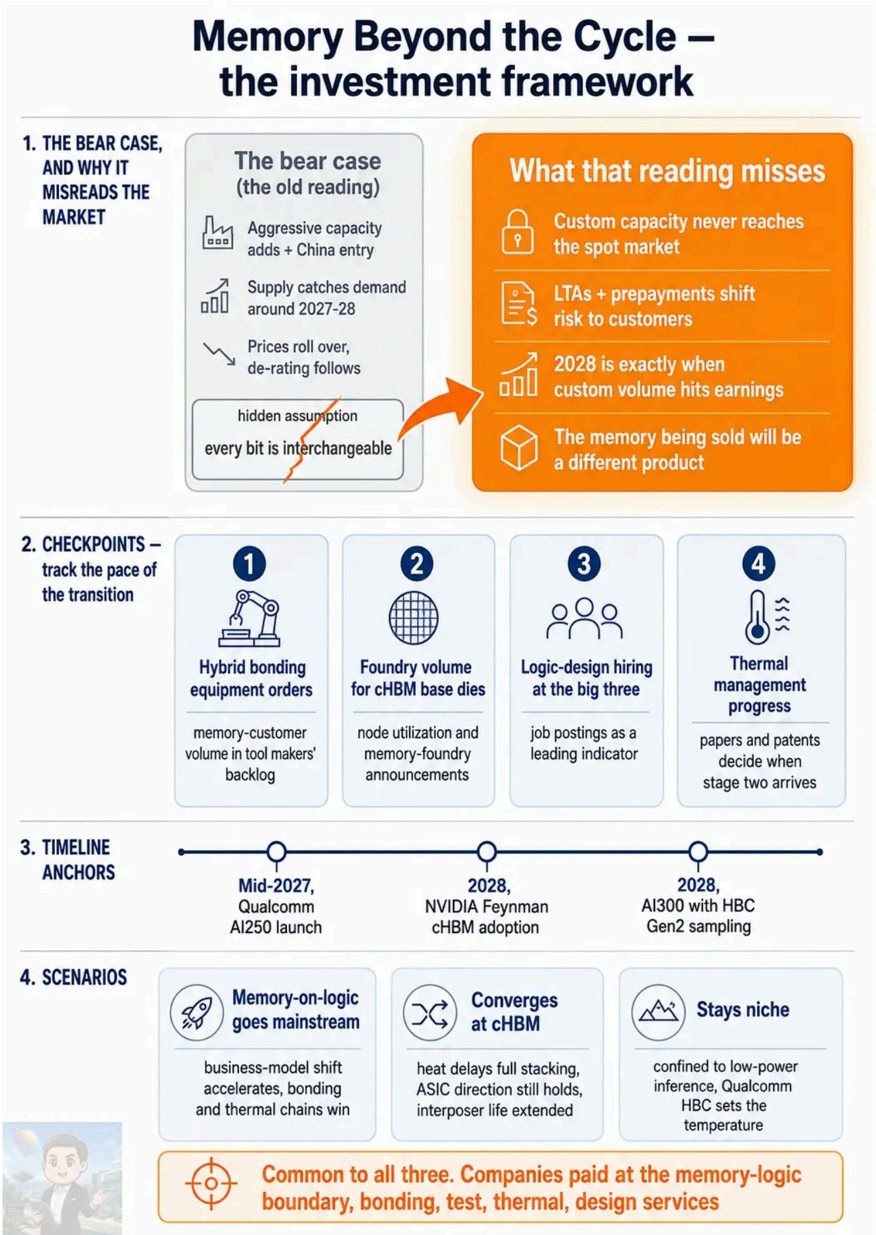
該框架下最大的爭議點在於 2028 年以後的周期前景。悲觀情境如下:三大廠商正積極擴 充產能,中國廠商也在擴大其在商品市場的份額,因此,當新增產能於 2027 年至 2028 年 左右全面投產時,供應將趕上需求,價格將出現下跌,並像以往一樣出現降價。這一邏 輯的前提是記憶體是標準化的部件。只有當每個位元都可互換時,新增產能才能拉低整 個市場的價格。
- THE BEAR CASE,
AND WHY IT
MISREADS THE
MARKET
- CHECKPOINTS - track the pace of
the transition
- TIMELINE
ANCHORS
- SCENARIOS
Memory Beyond the Cycle -
- THE BEAR CASE,
AND WHY IT
MISREADS THE
MARKET
- CHECKPOINTS - track the pace of
the transition
- TIMELINE
ANCHORS
- SCENARIOS
Memory Beyond the Cycle -
但客製化轉型恰恰動搖了這個前提。綜合三星和 SK 海力士高層的觀點,客製化 HBM 從 2027 年開始發展,並在 2028 年至 2029 年左右成為 HBM 市場的重要支柱,而分配給客戶 特定設計的產能並不會流入現貨市場。一旦大部分新增產能被特定客戶項目佔用,產能 過剩傳導至價格的途徑就會變得狹窄。長期協議( LTA )和預付款結構也改變了風險的 分配方式。在客戶預付款並承諾多年用量的模式下,當需求下降時,供應商無法獨自承 擔衝擊。
空頭所指的 2028 年,正是 cHBM 開始大規模普及,客製化產品銷售開始反映在獲利上 的年份。週期頂峰邏輯所假設的通用內存,與屆時實際銷售的內存產品在特性上很可能 有所不同。當然,這並不意味著週期會消失。通用 DRAM 和 NAND 快閃記憶體仍在市場 上佔有一席之地,如果客製化轉型晚於預期,空頭預測或許會成真。但現在,在押注記 憶體市場疲軟之前,必須先檢視客製化轉型的速度。
首先要追蹤的是混合鍵合設備的訂單。記憶體邏輯封裝( Memory-on-Logic )是否被應用於大量 生產,首先體現在鍵合設備的訂單上。當設備製造商開始在訂單說明中提及記憶體客戶 的訂單量時,這是一個重要的訊號。
第二個指標是 cHBM 基礎晶片的代工廠產量。一旦基礎晶片進入邏輯製程階段,該晶 圓就會被分配給代工廠。代工廠按節點劃分的產能利用率,以及記憶體公司與代工廠之 間的合作公告,都能反映研發進度。
第三點是三大記憶體製造商的邏輯設計人才招募。招募資訊是衡量策略執行速度的重要 指標。透過公開資訊可以追蹤哪些公司在哪些地區招募哪些職位。
第四個面向是熱管理技術的進步。記憶體邏輯電路中最大的技術風險是散熱。解決散熱 問題的進展首先體現在會議報告和專利中。解決散熱問題的速度決定了第二階段何時到 來。
時間線上有三個關鍵節點:高通 AI250 於 2027 年中期發布, NVIDIA Feynman 於 2028 年 採用 cHBM ,以及搭載 HBC Gen2 的 AI300 於 2028 年推出商用樣品。實際產品能否依計 畫在這三個節點推出,將決定此主題的發展速度。
我設想了三種情境。第一種情境是記憶體邏輯一體化( Memory-on-Logic )成為主流。三大記憶 體廠商的商業模式轉型加速,鍵合設備和散熱管理價值鏈獲得結構性效益。第二種情境 是 cHBM 技術發展受阻 。散熱問題導致進展比預期更久,全堆疊技術未能實現,最終只 能發展到客製化基礎晶片。即便如此,記憶體向 ASIC 晶片發展的趨勢仍不變,中介層 和 2.5D 封裝價值鏈的壽命得以延長。第三種情境是 Memory-on-Logic 仍保持小眾地位。散熱和良 率問題使得 Memory-on-Logic 僅限於低功耗推理等特定工作負載。在這種情況下,高通 HBC 的 成敗將決定整個 Memory-on-Logic 的發展方向。
如果很難確定最終結果,答案卻出乎意料地簡單。看看那些在記憶體和邏輯電路交界處 獲得收益的公司。在所有三種情況下,黏合、測試、散熱管理和設計服務的價值都會上 升。當難以預測最終結果時,押注於交集點則是古老的經驗法則。
當一家記憶體公司的競爭力從製程延伸到設計時,用於評估這些公司價值的框架本身就 會引發爭議。從商品週期股的角度來看,目前的本益比預示著週期高峰的到來。而從客 製化晶片合作夥伴的角度來看,同樣的本益比則意味著估值重估的開始。我認為,未來 幾年記憶體股票的發展趨勢將是這兩種框架之間差距的逐漸縮小。而彌合這一差距的證 據將逐步顯現,體現在諸如鍵合設備訂單、代工廠產量、招聘資訊以及散熱管理技術進 展等指標中。
關於此帖的討論
評論 重新堆疊
請留言 …
58 個讚 ∙ 5 重堆疊